
<强化学习>无模型下计算给定策略对应的价值函数,Model free Prediction,评估一个给定策略的表现
一、Intro
Prediction只是评估给定策略的表现,直白的说它是找 “在环境ENV下,AGENT按照给定的策略pai,AGENT的价值函数”。
这篇blog只介绍三种计算方法,没有涉及到 “求取ENV下的最优AGENT”!
对于事先已经给出了ENV,也就是说我们有完整的MDP,知道所有的state,也知道从这到那、从那到这的reward,可以在代码的开头就定义State表和reward表,这就是model-based问题,只要使用贝尔曼方程和贝尔曼最优方程迭代更新找到最优的value function V*和最优的policy pai*即可。
而大多数情况下ENV是不会给你的。只把你扔到一个陌生的环境中自己去探索去学习。也就是说我们不知道在这个ENV下总共有哪几种state,不知道离开这个state进入那个state会得到多少reward。所以!state要靠自己去探索鉴定,reward只知道最后输赢的时候的reward,这里我们就采用了model free算法了。
传统的model free算法有三种:
————MC
————TD
————TD(lamda)
在model free Prediction这里,三种方法相同之处是:
使用固定的策略pai作为控制策略进行探索,获得多条episode的数据(这里的episode有的是以终止状态ST为结尾的,有的不是);
基于大量episode的数据求取所有出现过的状态的价值预测的均值,来代表策略pai对应的状态价值函数(V(s) → vπ(s) as N(s) →∞)
二、 MC方法
蒙特卡洛方法直接使用一条条episode的经验。value<——mean return。
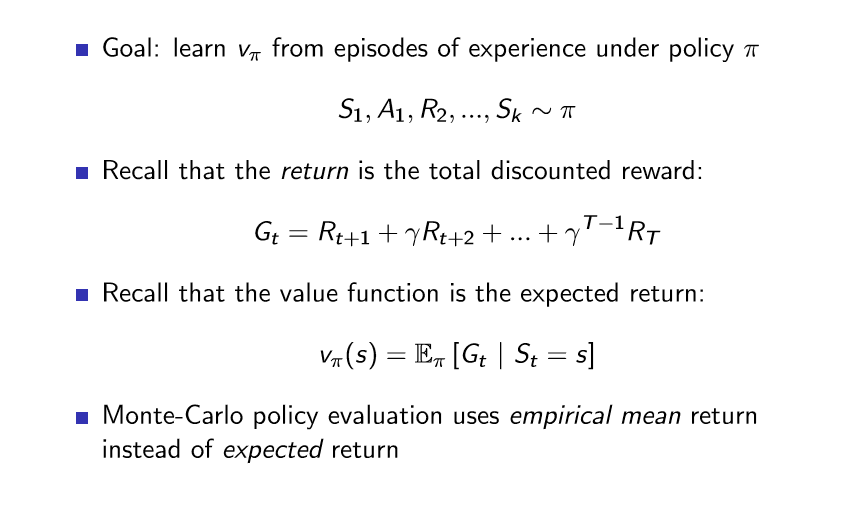
对于同一个状态在一个episode中多次出现,分为首访蒙特卡洛和每访蒙特卡洛。首访蒙特卡洛是只考虑状态的第一次出现,而每访蒙特卡洛是每次都要计入。
使用渐进更新:
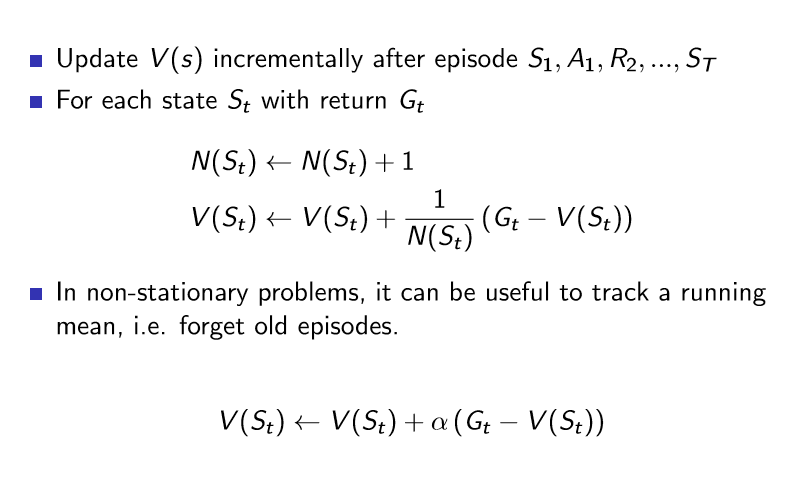
其实就是采样取均值,使用样本估计全局。基于大数定理当采样数足够大时均值结果就趋于于真实结果了。
三、 TD方法
时序差分方法直接使用一条条episode的经验。value<——mean return。
#TD learns from incomplete episodes, by bootstrapping
#TD updates a guess towards a guess
TD的更新式是这样的: V(St) ← V(St) + α( Rt+1 + γV(St+1) −V(St)),
MC的更新式是这样的:V(St) ← V(St) + α( Gt −V(St))
虽然两种方法都是使用大量episode的均值来估取value,但
可以看出,MC是使用完整采样来渐进更新求取均值,而TD是使用不完全采样来渐进更新求取均值。
也正因此,TD适用于 “持续环境” ; MC受限于 “有终止态环境” //例如围棋alphaGo使用蒙特卡洛树搜索,围棋就是一个典型的“有终止态环境”
TD有两个概念 “TD target”和“TD error”
|—— TD target Rt+1 + γV(St+1)
\—— TD error δt = Rt+1 + γV(St+1)−V(St)
拓展:TD n step
是对上面的TD的一个拓展,上面我们使用Rt+1 + γV(St+1)作为TD target来计算均值估计V(St) ==》 一步的真实采样+一个还在迭代更新中不准确的V值
我们也可以多看几步,如Rt+1 +Rt+2 + γV(St+3)作为TD target来计算均值估计V(St), ==》 两步的真实采样+一个还在迭代更新中不准确的V值
.................................... ==》 n步的真实采样+一个还在迭代更新中不准确的V值
四、 蒙特卡洛&时序差分 的 Bias / Variance 比较:

五、 TD(λ)方法
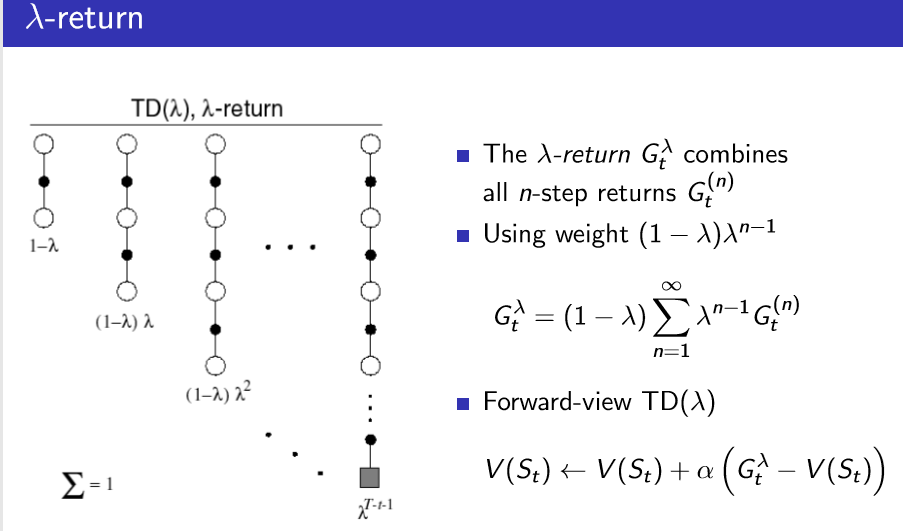
TD(λ)的更新式是这样的:V(St) ← V(St) + α( Gλ −V(St))
Gλ 是这样定义的:
<强化学习>无模型下计算给定策略对应的价值函数,Model free Prediction,评估一个给定策略的表现的更多相关文章
- 用深度强化学习玩FlappyBird
摘要:学习玩游戏一直是当今AI研究的热门话题之一.使用博弈论/搜索算法来解决这些问题需要特别地进行周密的特性定义,使得其扩展性不强.使用深度学习算法训练的卷积神经网络模型(CNN)自提出以来在图像处理 ...
- AI之强化学习、无监督学习、半监督学习和对抗学习
1.强化学习 @ 目录 1.强化学习 1.1 强化学习原理 1.2 强化学习与监督学习 2.无监督学习 3.半监督学习 4.对抗学习 强化学习(英语:Reinforcement Learning,简称 ...
- 论文:利用深度强化学习模型定位新物体(VISUAL SEMANTIC NAVIGATION USING SCENE PRIORS)
这是一篇被ICLR 2019 接收的论文.论文讨论了如何利用场景先验知识 (scene priors)来定位一个新场景(novel scene)中未曾见过的物体(unseen objects).举例来 ...
- 【转】强化学习(一)Deep Q-Network
原文地址:https://www.hhyz.me/2018/08/05/2018-08-05-RL/ 1. 前言 虽然将深度学习和增强学习结合的想法在几年前就有人尝试,但真正成功的开端就是DeepMi ...
- 强化学习论文(Scalable agent alignment via reward modeling: a research direction)
原文地址: https://arxiv.org/pdf/1811.07871.pdf ======================================================== ...
- 深度强化学习资料(视频+PPT+PDF下载)
https://blog.csdn.net/Mbx8X9u/article/details/80780459 课程主页:http://rll.berkeley.edu/deeprlcourse/ 所有 ...
- 【整理】强化学习与MDP
[入门,来自wiki] 强化学习是机器学习中的一个领域,强调如何基于环境而行动,以取得最大化的预期利益.其灵感来源于心理学中的行为主义理论,即有机体如何在环境给予的奖励或惩罚的刺激下,逐步形成对刺激的 ...
- 强化学习(二)马尔科夫决策过程(MDP)
在强化学习(一)模型基础中,我们讲到了强化学习模型的8个基本要素.但是仅凭这些要素还是无法使用强化学习来帮助我们解决问题的, 在讲到模型训练前,模型的简化也很重要,这一篇主要就是讲如何利用马尔科夫决策 ...
- DRL强化学习:
IT博客网 热点推荐 推荐博客 编程语言 数据库 前端 IT博客网 > 域名隐私保护 免费 DRL前沿之:Hierarchical Deep Reinforcement Learning 来源: ...
随机推荐
- 「SPOJ1487」Query on a tree III
「SPOJ1487」Query on a tree III 传送门 把树的 \(\text{dfs}\) 序抠出来,子树的节点的编号位于一段连续区间,然后直接上建主席树区间第 \(k\) 大即可. 参 ...
- selenium抓取淘宝数据报错:warnings.warn('Selenium support for PhantomJS has been deprecated, please use headless
ssh://root@192.168.33.12:22/root/anaconda3/bin/python3 -u /www/python3/maoyantop100/meishi_selenium. ...
- Python 基础之模块之os os.path 及os与shutil对比
一: os 对系统进行操作 #注:以下操作都在linux环境下操作,且很多运行之前需要做好相关条件import os#(1)system() 在python总执行系统命令#os.system(&quo ...
- IDEA设置窗口标签换行显示
windows -> editor tabs -> tabs placement 关掉 show tabs in sigle row即可
- OPC DA通讯 KEP6.4 DCOM 配置脚本
在OPC DA通讯测试时总是避免不了要配置DCOM,我习惯是在虚拟机中装这些通讯测试软件,每次安装都需要再次手动配置,感觉很是麻烦 因此,查找资料,了解到可以用dcomperm这个软件来在命令行下进行 ...
- 02-01 Android学习进度报告一
前两天,刚刚安装好有关Android开发有关的软件并配好了环境,有一些体会想要发表. 首先我了解到有一款专门用于Android开发的软件,叫做Android Studio ,是一个IDE集成软件 于是 ...
- window.onload 方法脚本
//首先 创建一个函数 function windowOload(func){ var onLoad = window.onload; //如果window.onload没有绑定任何函数 则绑定该函数 ...
- ORACLE 删除重复的数据
内容转自:https://www.cnblogs.com/zfox2017/p/7676237.html 查询及删除重复记录的SQL语句 1.查找表中多余的重复记录,重复记录是根据 ...
- css 文本溢出省略号
单行溢出显示省略号: white-space: nowrap; overflow: hidden; text-overflow: ellipsis; 多行溢出显示省略号: text-overflow: ...
- 在React中随机生成图形验证码
各个方法 在输入框中定义一个位置存放图形 完整代码 方便复制粘贴 import React, { Component } from 'react'; import styles from './lef ...