
hadoop完全分布式
虚拟机克隆
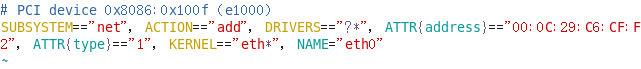
a. vim /etc/udev/rules.d/70-persistent-net.rules
更改网卡名
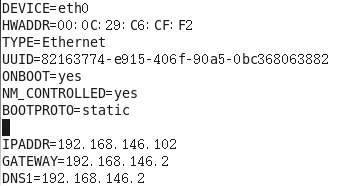
b. vim /etc/sysconfig/network-scripts/ifcfg-eth0
更新网卡
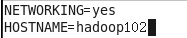
c. vim /etc/sysconfig/network
更改主机名称
d. 配置hosts
vim /etc/hosts
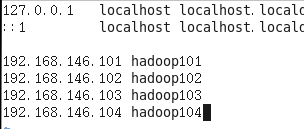
windows主机hosts:C:\Windows\System32\drivers\etc\hosts
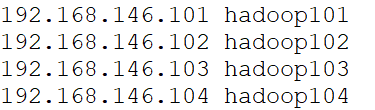
e. 重启虚拟机
集群配置
a. 集群部署规划
| hadoop102 | hadoop103 | hadoop104 | |
| HDFS |
NameNode DataNode |
DataNode |
SecondaryNameNode DataNode |
| YARN | NodeManager |
ResourceManager NodeManager |
NodeManager |
b. 配置集群文件
配置core-site.xml
<!-- 指定HDFS中NameNode的地址 -->

<property>

        <name>fs.defaultFS</name>

        <value>hdfs://hadoop102:9000</value>

</property>

<!-- 指定Hadoop运行时产生文件的存储目录 -->

<property>

        <name>hadoop.tmp.dir</name>

        <value>/opt/module/hadoop-2.7.2/data/tmp</value>

</property>
配置hadoop-env.sh
# The java implementation to use.

export JAVA_HOME=/opt/module/jdk1.8.0_144
配置hdfs-site.xml
<!-- 指定HDFS副本的数量 -->

<property>

        <name>dfs.replication</name>

        <value>3</value>

</property>

<!-- 指定Hadoop辅助名称节点主机配置 -->

<property>

      <name>dfs.namenode.secondary.http-address</name>

      <value>hadoop104:50090</value>

</property>
配置yarn-env.sh
# some Java parameters

export JAVA_HOME=/opt/module/jdk1.8.0_144
配置yarn-site.xml
<!-- Reducer获取数据的方式 -->

<property>

         <name>yarn.nodemanager.aux-services</name>

         <value>mapreduce_shuffle</value>

</property>

<!-- 指定YARN的ResourceManager的地址 -->

<property>

    <name>yarn.resourcemanager.hostname</name>

    <value>hadoop103</value>

</property>
配置mapred-env.sh
export JAVA_HOME=/opt/module/jdk1.8.0_144
配置mapred-site.xml
<!-- 指定MR运行在YARN上 -->

<property>

          <name>mapreduce.framework.name</name>

          <value>yarn</value>

</property>
c. ssh无密登录
生成公钥和私钥
cd ~

ssh-keygen -t rsa
公钥拷贝到要免密登录的目标机器上
ssh-copy-id hadoop102

ssh-copy-id hadoop103

ssh-copy-id hadoop104
注:由于节点间的通讯,hadoop102需要root用户在配置一次,hadoop103普通用户配置一次
群起集群
a. 配置slaves
/opt/module/hadoop-2.7.2/etc/hadoop/slaves

脚本同步所有节点配置文件
b. 启动集群
sbin/start-dfs.sh
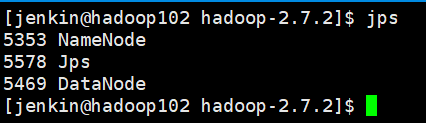
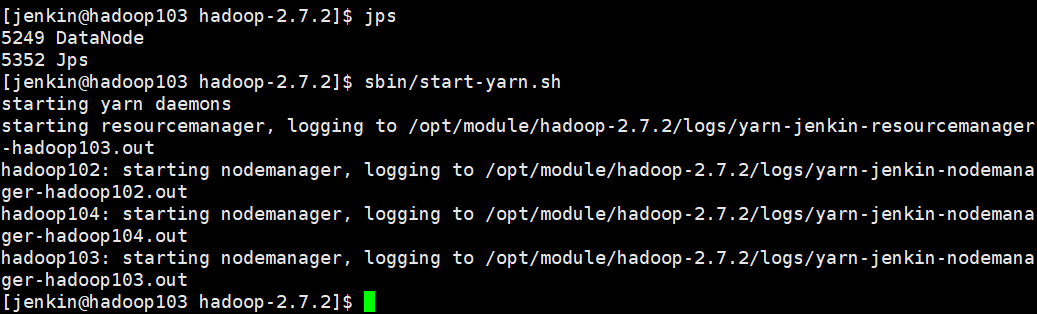
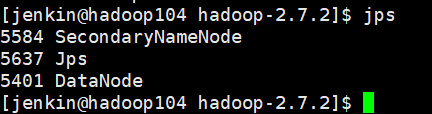
注:NameNode和ResourceManger如果不是同一台机器,不能在NameNode上启动 YARN,应该在ResouceManager所在的机器上启动YARN。
集群时间同步
时间同步的方式:找一个机器,作为时间服务器,所有的机器与这台集群时间进行定时的同步,比如,每隔十分钟,同步一次时间
时间服务器配置
a. 检查ntp是否安装
rpm -qa | grep ntp
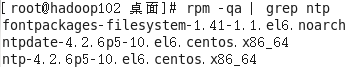
b. 修改ntp配置文件
vim /etc/ntp.conf
修改1(授权192.168.146.0-192.168.146.255网段上的所有机器可以从这台机器上查询和同步时间)
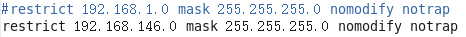
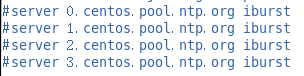
修改2(集群在局域网中,不使用其他互联网上的时间)
添加3(当该节点丢失网络连接,依然可以采用本地时间作为时间服务器为集群中的其他节点提供时间同步)
添加在conf文件末尾
server 127.127.1.0
fudge 127.127.1.0 stratum 10
c. 修改/etc/sysconfig/ntpd 文件
vim /etc/sysconfig/ntpd
# 让硬件时间与系统时间一起同步
SYNC_HWCLOCK=yes
d. 重新启动ntpd服务
service ntpd status
service ntpd start
e. 设置ntpd服务开机启动
chkconfig ntpd on
其他机器配置
a. 在其他机器配置10分钟与时间服务器同步一次
crontab -e
编写内容
*/10 * * * * /usr/sbin/ntpdate hadoop102
b. 修改任意机器时间
date -s "2020-11-11 11:11:11"
c. 十分钟后查看机器是否与时间服务器同步
date
hadoop完全分布式的更多相关文章
- Hadoop伪分布式集群环境搭建
本教程讲述在单机环境下搭建Hadoop伪分布式集群环境,帮助初学者方便学习Hadoop相关知识. 首先安装Hadoop之前需要准备安装环境. 安装Centos6.5(64位).(操作系统再次不做过多描 ...
- hadoop伪分布式平台搭建(centos 6.3)
最近要写一个数据量较大的程序,所以想搭建一个hbase平台试试.搭建hbase伪分布式平台,需要先搭建hadoop平台.本文主要介绍伪分布式平台搭建过程. 目录: 一.前言 二.环境搭建 三.命令测试 ...
- [hadoop] hadoop-all-in-one-伪分布式安装
hadoop伪分布式-all-in-one安装 #查看hadoop 版本 [root@hadoop-allinone-200-123 bin]# pwd /wdcloud/app/hadoop-2.7 ...
- Hadoop伪分布式搭建(一)
下面内容主要说明在Windows虚拟机上面,怎么搭建一个Hadoop伪分布式,并如何运行wordcount程序和网页查看HDFS文件系统. 1 相关软件下载和安装 APACH官网提供hadoop版本 ...
- ubuntu下hadoop完全分布式部署
三台机器分别命名为: hadoop-master ip:192.168.0.25 hadoop-slave1 ip:192.168.0.26 hadoop-slave2 ip:192.168.0.27 ...
- Hadoop伪分布式搭建步骤
说明: 搭建环境是VMware10下用的是Linux CENTOS 32位,Hadoop:hadoop-2.4.1 JAVA :jdk7 32位:本文是本人在网络上收集的HADOOP系列视频所附带的 ...
- Hadoop HDFS分布式文件系统设计要点与架构
Hadoop HDFS分布式文件系统设计要点与架构 Hadoop简介:一个分布式系统基础架构,由Apache基金会开发.用户可以在不了解分布式底层细节的情况下,开发分布式程序.充分利用集群 ...
- Hadoop伪分布式模式部署
Hadoop的安装有三种执行模式: 单机模式(Local (Standalone) Mode):Hadoop的默认模式,0配置.Hadoop执行在一个Java进程中.使用本地文件系统.不使用HDFS, ...
- Hadoop(三)手把手教你搭建Hadoop全分布式集群
前言 上一篇介绍了伪分布式集群的搭建,其实在我们的生产环境中我们肯定不是使用只有一台服务器的伪分布式集群当中的.接下来我将给大家分享一下全分布式集群的搭建! 其实搭建最基本的全分布式集群和伪分布式集群 ...
- Hadoop完全分布式环境搭建
前言 本文搭建了一个由三节点(master.slave1.slave2)构成的Hadoop完全分布式集群(区别单节点伪分布式集群),并通过Hadoop分布式计算的一个示例测试集群的正确性. 本文集群三 ...
随机推荐
- cookie的理解
第一:每个特定的域名下最多生成20个cookie IE6或更低版本最多20个cookie IE7和之后的版本最多可以有50个cookie Firefox最多50个cookie chrome和Safar ...
- Codeforces Edu Round 47 A-E
A. Game Shopping 按照题意模拟既可. #include <iostream> #include <cstdio> using namespace std; co ...
- 【Codeforces 1181E】A Story of One Country (Easy & Hard)(分治 & set)
Description 在一个二维平面上有若干个矩形.定义一个矩形的(或有边在无限远处)区域为符合条件的条件为: 这个区域仅包含一个矩形,且不能使边界穿过任何一个矩形的内部. 这个区域可以用一个水平或 ...
- 小白都看得懂的Javadoc上手教程
Javadoc是什么 官方回答: Javadoc is a tool for generating API documentation in HTML format from doc comments ...
- schema与数据类型优化-高性能mysql
总结作为开发人员重点注意的内容!这是一篇有关高性能MYSQL第四章schema相关的笔记. 0.前言 在项目中,数据库表列有两个text字段,用来存储大文本,在数据规模达到40万后,如果查询没命中索引 ...
- sqli-labs less1-4(union注入)
less-1 考点:Single quotes 输入: 判断类型 ?id=1 返回loginname和password.输入的id就是与后台数据库连接的接口通过id=? 查询数据库信息 ?id=1' ...
- qq获取验证码接口
测试 获取验证码 import smtplib from email.mime.text import MIMEText from email.utils import formataddr #定义参 ...
- ORACLE11g Dataguard物理Standby 日常巡检操作手册
ORACLE11g Dataguard物理Standby日常巡检操作手册 编写:_____________校对:_____________日期:_____________ 目录1.DG环境的日常巡检 ...
- Kafka服务器后台启动
nohup bin/kafka-server-start.sh config/server.properties 1>/dev/null 2>&1 &
- ubuntu20.04 LTS 更换国内163源、阿里源、清华源、中科大源
Ubuntu 20.04 是 Ubuntu 的第 8 个 LTS 版本,其重大更新和改进将在 2030 年前终止,计划于2020年 4 月 23 日发布. 国内有很多Ubuntu的镜像源,有阿里的.网 ...