
kafka项目经验之如何进行Kafka压力测试、如何计算Kafka分区数、如何确定Kaftka集群机器数量
@
Kafka压测
用Kafka官方自带的脚本,对Kafka进行压测。Kafka压测时,可以查看到哪个地方出现了瓶颈==(CPU,内存,网络IO)。一般都是网络IO达到瓶颈。 ==
使用下面两个kafka自带的脚本
kafka-consumer-perf-test.shkafka-producer-perf-test.sh
Kafka Producer(生产)压力测试
进入kafka的安装目录,执行下面的命令
[sun@hadoop102 kafka]$ bin/kafka-producer-perf-test.sh --topic test --record-size 100 --num-records 100000 --throughput -1 --producer-props bootstrap.servers=hadoop102:9092,hadoop103:9092,hadoop104:9092
说明:
record-size是一条信息有多大,单位是字节。num-records是总共发送多少条信息。throughput是每秒多少条信息,设成-1,表示不限流,可测出生产者最大吞吐量。
输出:
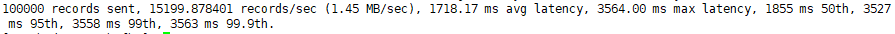
参数解析:本例中一共写入10w条消息,吞吐量为1.45 MB/sec,每次写入的平均延迟为1718.17毫秒,最大的延迟为3564.00毫秒。
Kafka Consumer(消费)压力测试
Consumer的测试,如果这四个指标(IO,CPU,内存,网络)都不能改变,考虑增加分区数来提升性能。
进入kafka的安装目录,执行下面的命令
[sun@hadoop102 kafka]$ bin/kafka-consumer-perf-test.sh --broker-list hadoop102:9092,hadoop103:9092,hadoop104:9092 --topic test --fetch-size 10000 --messages 10000000 --threads 1
参数说明:
--zookeeper 指定zookeeper的链接信息
--topic 指定topic的名称
--fetch-size 指定每次fetch的数据的大小
--messages 总共要消费的消息个数
输出:
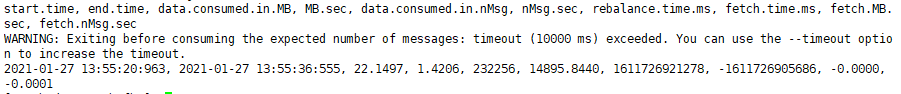
start.time开始时间:2021-01-27 13:55:20:963end.time结束时间:2021-01-27 13:55:36:555data.consumed.in.MB共消费数据:22.1497MBMB.sec吞吐量:1.4206MB/secdata.consumed.in.nMsg共消费消息条数:232256条nMsg.sec平均每秒消费条数:14895.8440条
计算Kafka分区数
- 创建一个只有1个分区的topic
- 测试这个topic的producer吞吐量(1.45m/s)和consumer吞吐量(1.42m/s)。数据来自上面的压测
- 假设他们的值分别是Tp和Tc,单位可以是MB/s。 4)然后假设你期望的目标吞吐量是Tt(10m/s),那么分区数=Tt /min(Tp,Tc) ,这里取最小值是因为使最低的吞吐量都能达到期望的吞吐量。
- 例如:producer吞吐量=20m/s;consumer吞吐量=50m/s,期望吞吐量100m/s;
- 分区数=100 / 20 =5分区 5)分区数一般设置为:3-10个
Kafka机器数量计算
- Kafka机器数量(经验公式)=2 (峰值生产速度副本数/100)+1
- 先拿到峰值生产速度,再根据设定的副本数,就能预估出需要部署Kafka的数量。 副本数默认是1个
- 在企业里面2-3个都有,2个居多。
- 比如我们的峰值生产速度是50M/s(一般不超过50M/s)。生产环境可以设置为2。 Kafka机器数量=2(502/100)+1=3台
- 副本多可以提高可靠性,但是会降低网络传输效率。
kafka项目经验之如何进行Kafka压力测试、如何计算Kafka分区数、如何确定Kaftka集群机器数量的更多相关文章
- 项目经验——Sql server 数据库的备份和还原____还原数据库提示“介质集有2个介质簇,但只提供了1个。必须提供所有成员” .
在对数据库备份与还原的过程中,我遇到一个问题“介质集有2个介质簇,但只提供了1个.必须提供所有成员”,下面详细的介绍一下遇到问题的经过与问题解决的方法! 一.备份与还原遇到的问题描述与解决方法: 前两 ...
- 新闻网大数据实时分析可视化系统项目——7、Kafka分布式集群部署
Kafka是由LinkedIn开发的一个分布式的消息系统,使用Scala编写,它以可水平扩展和高吞吐率而被广泛使用.目前越来越多的开源分布式处理系统如Cloudera.Apache Storm.Spa ...
- Spark集群 + Akka + Kafka + Scala 开发(3) : 开发一个Akka + Spark的应用
前言 在Spark集群 + Akka + Kafka + Scala 开发(1) : 配置开发环境中,我们已经部署好了一个Spark的开发环境. 在Spark集群 + Akka + Kafka + S ...
- Centos安装Kafka集群
kafka是LinkedIn开发并开源的一个分布式MQ系统,现在是Apache的一个孵化项目.在它的主页描述kafka为一个高吞吐量的分布式(能 将消息分散到不同的节点上)MQ.在这片博文中,作者简单 ...
- 4 kafka集群部署及kafka生产者java客户端编程 + kafka消费者java客户端编程
本博文的主要内容有 kafka的单机模式部署 kafka的分布式模式部署 生产者java客户端编程 消费者java客户端编程 运行kafka ,需要依赖 zookeeper,你可以使用已有的 zo ...
- kafka学习(三)-kafka集群搭建
kafka集群搭建 下面简单的介绍一下kafka的集群搭建,单个kafka的安装更简单,下面以集群搭建为例子. 我们设置并部署有三个节点的 kafka 集合体,必须在每个节点上遵循下面的步骤来启动 k ...
- 生产环境一键创建kafka集群
前段时间公司的一个kafka集群出现了故障,由于之前准备不足,当时处理的比较慌乱.如:由于kafka的集群里topic数量较多,并且每个topic的分区数量和副本数量都不是一样的,如果按部就班的一个一 ...
- kafka集群及监控部署
1. kafka的定义 kafka是一个分布式消息系统,由linkedin使用scala编写,用作LinkedIn的活动流(Activity Stream)和运营数据处理管道(Pipeline)的基础 ...
- kafka集群原理介绍
目录 kafka集群原理介绍 (一)基础理论 二.配置文件 三.错误处理 kafka集群原理介绍 @(博客文章)[kafka|大数据] 本系统文章共三篇,分别为 1.kafka集群原理介绍了以下几个方 ...
随机推荐
- VSCode + PYQT5 搭建图形化界面
1,安装依赖 pip install -i https://mirrors.aliyun.com/pypi/simple/ PyQt5 pip install -i https://mirrors.a ...
- Git简易教程-安装及简单使用
Git是一种版本控制器,在项目开发中可以用来托管代码 一.下载安装Git 1. Git下载 地址:https://git-scm.com/download/win 2. 安装 检验是否安装成功 电脑桌 ...
- 漫画 | 老泪纵横,约会也不敢耽误改bug
啥都不说了, 直接看图, 就说你中了几枪. 小莱已经抹了好几把辛酸泪-- 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 关于作者 作者:大家好,我是莱乌,BAT搬砖工一枚.从 ...
- 浅析 TensorFlow Runtime 技术
关于 TF Runtime 的疑问? 什么是TFRT ? TensorFlow Runtime,简称 TFRT,它提供了统一的.可扩展的基础架构层,可以极致地发挥CPU多线程性能,支持全异步编程(无锁 ...
- MySQL - 数据查询 - 简单查询
1. 简述 查询数据是指从数据库中获取所需要的数据.如Jack 要达到验证用户名和密码的目的,就需要从数据库已保存的用户表中读取当前用户的密码进行验证,以验明正身!保存查询数据是数据库操作中常用且重要 ...
- double 转为long类型
System.out.println(new Double(234314.999999999).longValue());//234314 System.out.println(new Double ...
- linux yum install
作为一名新手,学习Linux已经一个月了,其间遇到了不少问题,而今天笔者遇到的问题是 #yum install pam-devel #This system is not registered to ...
- [LeetCode98]98. Validate Binary Search Tree判断二叉搜索树
判断二叉搜索树的方法是: 中序遍历形成递增序列 //全局变量记录中序遍历产生的序列,因为要递归,所以要用全局变量 List<Integer> list = new ArrayList< ...
- 配置NFS实现nginx动静分离
案例子任务一.安装配置NFS服务器 步骤1:使用docker容器配置NFS服务器 启动centos容器并进入 docker run -d --privileged centos:v1 /usr/sbi ...
- Docker技术