
hadoop(一)之初识大数据与Hadoop
前言
从今天起,我将一步一步的分享大数据相关的知识,其实很多程序员感觉大数据很难学,其实并不是你想象的这样,只要自己想学,还有什么难得呢?
学习Hadoop有一个8020原则,80%都是在不断的配置配置搭建集群,只有20%写程序!
一、引言(大数据时代)
1.1、从数据中得到信息
我们看一张图片:
我们知道这个图片上的人叫张小妹,年龄20岁,职业模特。但是如果只有数据没有图片的话,就没有意义的数据了。所以数据一定是在特定的环境下才有意义的。
我们再来看一张图片:
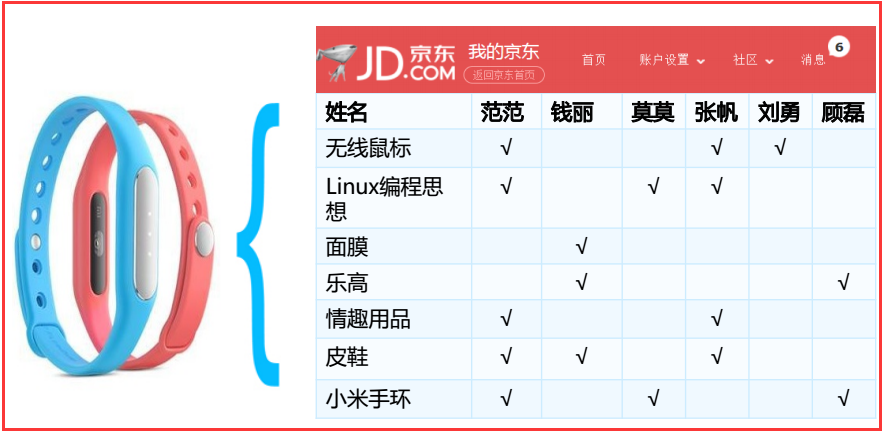
从这张图片分析出:从纵向分析,范范和张帆的购买东西十分的相似,所以如果要推荐东西给张帆的话,我们就可以选择小米手环。
从横向分析,无效鼠标,linux编程思想,皮鞋和小米手环都卖的比较火,其他几样销量少,所以我们推荐就可以把这几样放上去。
1.2、大数据表象概念
大家理解什么是大数据吗,那大数据到底有多大!我们就以百度的数据来分析一下:
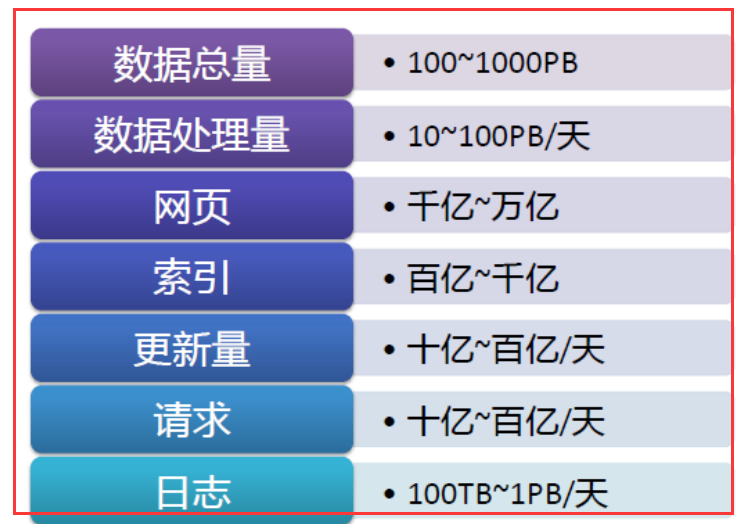
首先:1PB=1024T
分析:我们就看最小的它每天产生的日志就可以看出来,百度每天要产生100TB~1PB的日志数据。一般我们电脑的硬盘是1T的。那就需要电脑的100个硬盘到1024块硬盘,你想想是多么的恐怖!
二、大数据基础
2.1、什么是大数据?
其实对于大数据官方并没有给出一个准确的定义,不同机构有着不同的定义。
1)对于“大数据”(Big data)研究机构 Gartner 给出了这样的定义。“大数据”是需要新处理模式才能具有更强的决策力、洞察发现力和流程优化能力来适应海量、高增长率和多样化的信息资产。
2)麦肯锡全球研究所给出的定义是:一种规模大到在获取、存储、管理、分析方面大大超出了传统数据库软件工具能力范围的数据集合,具有海量的数据规模、快速的数据流转、多样的数据类型和价值密度低四大特征。
3)大数据技术的战略意义不在于掌握庞大的数据信息,而在于对这些含有意义的数据进行专业化处理。换而言之,
如果把大数据比作一种产业,那么这种产业实现盈利的关键,在于提高对数据的“加工能力”,通过“加工”实现数据的“增值”。
4) 从技术上看,大数据与云计算的关系就像一枚硬币的正反面一样密不可分。大数据必然无法用单台的计算机进行处
理,必须采用分布式架构。它的特色在于对海量数据进行分布式数据挖掘。但它必须依托云计算的分布式处理、分布式数据库和云存储、虚拟化技术。
5)随着云时代的来临,大数据(Big data)也吸引了越来越多的关注。分析师团队认为,大数据(Big data)通常用来形容一个公司创造的大量非结构化数据和半结构化数据,
这些数据在下载到关系型数据库用于分析时会花费过多时间和金钱。大数据分析常和云计算联系到一起,因为实时的大型数据集分析需要像 MapReduce 一样的框架来向数十、数百或甚至数千的电脑分配工作。
6) 大数据需要特殊的技术,以有效地处理大量的容忍经过时间内的数据。适用于大数据的技术,包括大规模并行处理(MPP)数据库、数据挖掘、分布式文件系统、分布式数据库、云计算平台、互联网和可扩展的存储系统。
7)谷歌给出的大数据定义和特点
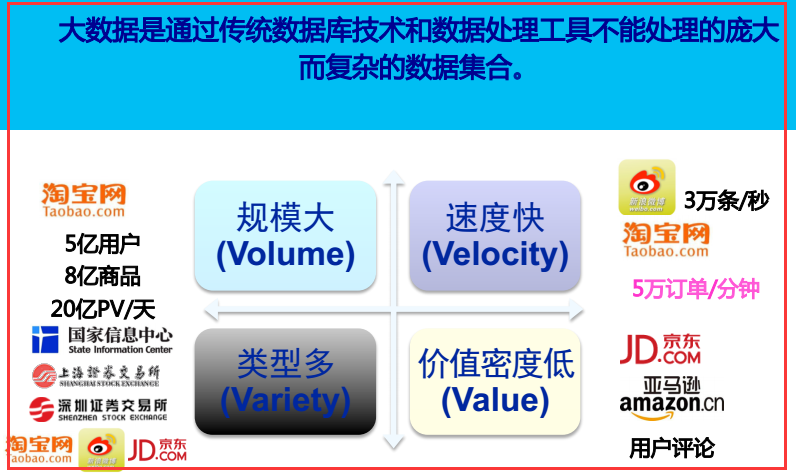
2.2、大数据的基本特征
容量(Volume):数据的大小决定所考虑的数据的价值和潜在的信息
种类(Variety):数据类型的多样性
速度(Velocity):指获得数据的速度
可变性(Variability):妨碍了处理和有效地管理数据的过程
真实性(Veracity):数据的质量
复杂性(Complexity):数据量巨大,来源多渠道
价值(Value):合理运用大数据,以低成本创造高价值
2.3、大数据的意义
1)现在的社会是一个高速发展的社会,科技发达,信息流通,人们之间的交流越来越密切,生活也越来越方便,大数据就是这个高科技时代的产物。
阿里巴巴创办人马云来台演讲中就提到,未来的时代将不是 IT 时代,而是 DT 的时代,DT 就是 Data Technology 数据科技,显示大数据对于阿里巴巴集团来说举足轻重。
2)有人把数据比喻为蕴藏能量的煤矿。煤炭按照性质有焦煤、无烟煤、肥煤、贫煤等分类,而露天煤矿、深山煤矿的挖掘成本又不一样。与此类似,大数据并不在“大”,而在于“有用”。
价值含量、挖掘成本比数量更为重要。对于很多行业而言, 如何利用这些大规模数据是赢得竞争的关键。
3)大数据的价值体现在以下几个方面:
对大量消费者提供产品或服务的企业可以利用大数据进行精准营销
做小而美模式的中小微企业可以利用大数据做服务转型
面临互联网压力之下必须转型的传统企业需要与时俱进充分利用大数据的价值
4)不过,“大数据”在经济发展中的巨大意义并不代表其能取代一切对于社会问题的理性思考,科学发展的逻辑不能被湮没在海量数据中。
著名经济学家路德维希·冯·米塞斯曾提醒过:“就今日言,有很多人忙碌于资料之无益累积,以致对问题之说明与解决,丧失了其对特殊的经济意义的了解。”这确实是需要警惕的。
5)在这个快速发展的智能硬件时代,困扰应用开发者的一个重要问题就是如何在功率、覆盖范围、传输速率和成本之间找到那个微妙的平衡点。
企业组织利用相关数据和分析可以帮助它们降低成本、提高效率、开发新产品、做出更明智的业务决策等等。
例如,通过结合大数据和高性能的分析,下面这些对企业有益的情况都可能会发生:
及时解析故障、问题和缺陷的根源,每年可能为企业节省数十亿美元。
为成千上万的快递车辆规划实时交通路线,躲避拥堵。
根据客户的购买习惯,为其推送他可能感兴趣的优惠信息。
从大量客户中快速识别出金牌客户。
使用点击流分析和数据挖掘来规避欺诈行为。
2.4、大数据的系统架构(整体架构)
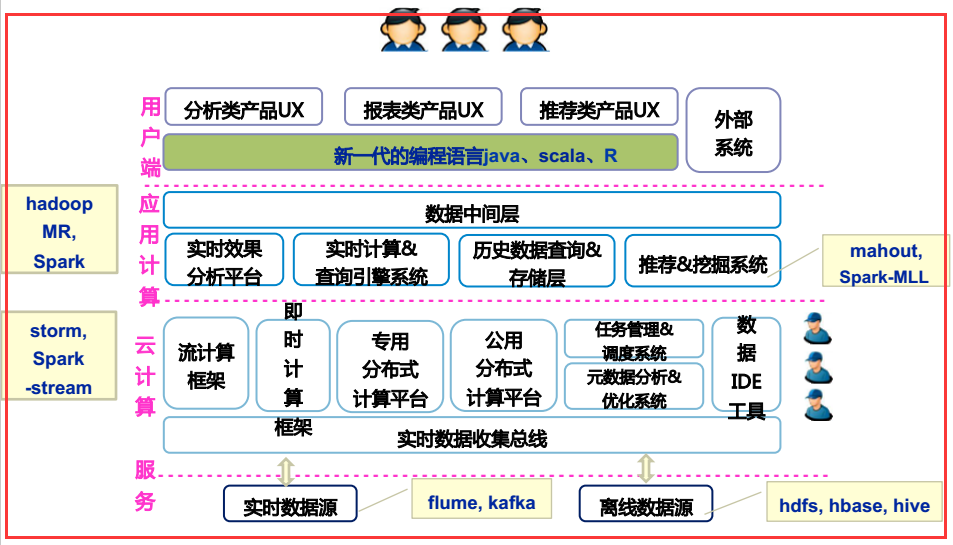
2.5、大数据处理平台
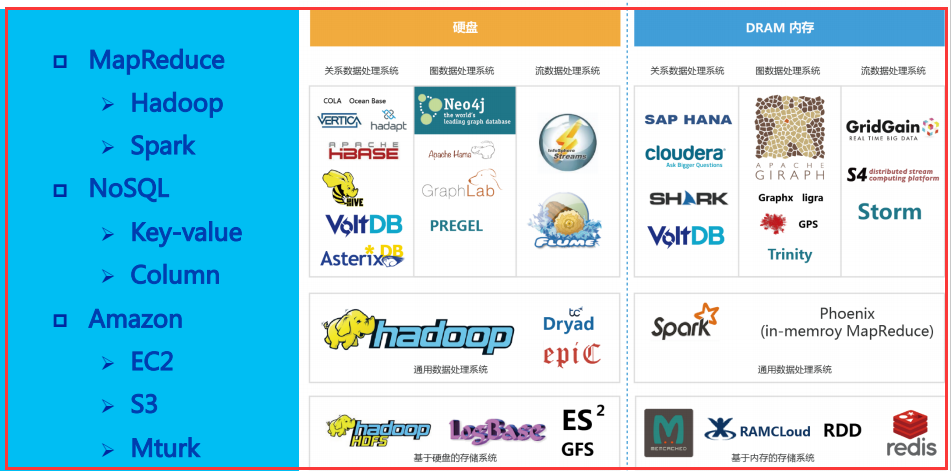
2.6、大数据中的几个概念
1)集群(Cluster):服务器集群就是指将很多服务器集中起来一起进行同一种服务,在客户端看来就像是只有一个服务器。集群可以利用多个计算机进行并行 计算从而获得很高的计算速度,也可以用多个计算机做备份,
从而使得任何一个机器坏了整个系统还是能正常运行。(通俗来说就是由若干计算机组成的,共同协作来完成一个大型复杂计算任务的计算机群体。 )
2)数据密集型(DIC):在集群中所计算的数据的量比较大,但是计算过程并不复杂。
3)计算密集型(CIC):数据量并不大,但是计算过程是比较复杂的。
4)向上扩展(Scale-up):对硬件的扩展。受限于硬件的发展。其实就是对cpu、内存、硬盘的扩展
5)向外扩展(Scale-out):通过计算机集群的方式来提高计算能力。 (例如当某个计算任务用 10 台计算机不能完成时就增加计算机台数来完成)。受限于网络资源。其实就是对服务器个数的扩展
6)机器学习(MachineLearning):当数据被处理完,用来获取所处理的信息。从数据集中获取信息。
7)云计算(CloudComputing):通过互联网来提供动态易扩展且经常是虚拟化的资源
三、Hadoop概述
3.1、什么是Hadoop
1)Hadoop 是一个由 Apache 基金会所开发的分布式系统基础架构。
2)用户可以在不了解分布式底层细节的情况下,开发分布式程序。充分利用集群的威力进行高速运算和存储。
3)Hadoop 实现了一个分布式文件系统(Hadoop Distributed File System),简称 HDFS。 HDFS 有高容错性的特点,并且设计用来部署在低廉的(low-cost)硬件上;
而且它提供高吞吐量(high throughput)来访问应用程序的数据,适合那些有着超大数据集(large data set)的应用程序。
HDFS 放宽了(relax) POSIX 的要求,可以以流的形式访问(streaming access)文件系统中的数据。
4)Hadoop 的框架最核心的设计就是: HDFS 和 MapReduce。 HDFS 为海量的数据提供了存储,则 MapReduce 为海量的数据提供了计算。
3.2、Hadoop的优点
1)Hadoop 是一个能够对大量数据进行分布式处理的软件框架。
2) Hadoop 以一种可靠、高效、可伸缩的方式进行数据处理。
3)Hadoop 是可靠的,因为它假设计算元素和存储会失败,因此它维护多个工作数据副本,确保能够针对失败的节点重新分布处理。
4)Hadoop 是高效的,因为它以并行的方式工作,通过并行处理加快处理速度。
5)Hadoop 还是可伸缩的,能够处理 PB 级数据。
6)Hadoop 依赖于社区服务,因此它的成本比较低,任何人都可以使用。
7)Hadoop是一个能够让用户轻松架构和使用的分布式计算平台。用户可以轻松地在Hadoop上开发和运行处理海量数据的应用程序。它主要有以下几个优点:
高可靠性:Hadoop 按位存储和处理数据的能力值得人们信赖
高扩展性:Hadoop是在可用的计算机集簇间分配数据并完成计算任务的,这些集簇可以方便地扩展到数以千计的节点中。
高效性:Hadoop 能够在节点之间动态地移动数据,并保证各个节点的动态平衡,因此处理速度非常快
高容错性:Hadoop 能够自动保存数据的多个副本,并且能够自动将失败的任务重新分配
低成本:与一体机、商用数据仓库以及 QlikView、 Yonghong Z-Suite 等数据集市相比, hadoop 是开源的,项目的软件成本因此会大大降低。
8)Hadoop 带有用 Java 语言编写的框架,因此运行在 Linux 生产平台上是非常理想的。 Hadoop 上的应用程序也可以使用其他语言编写,比如 C++。
3.3、Hadoop发展历程
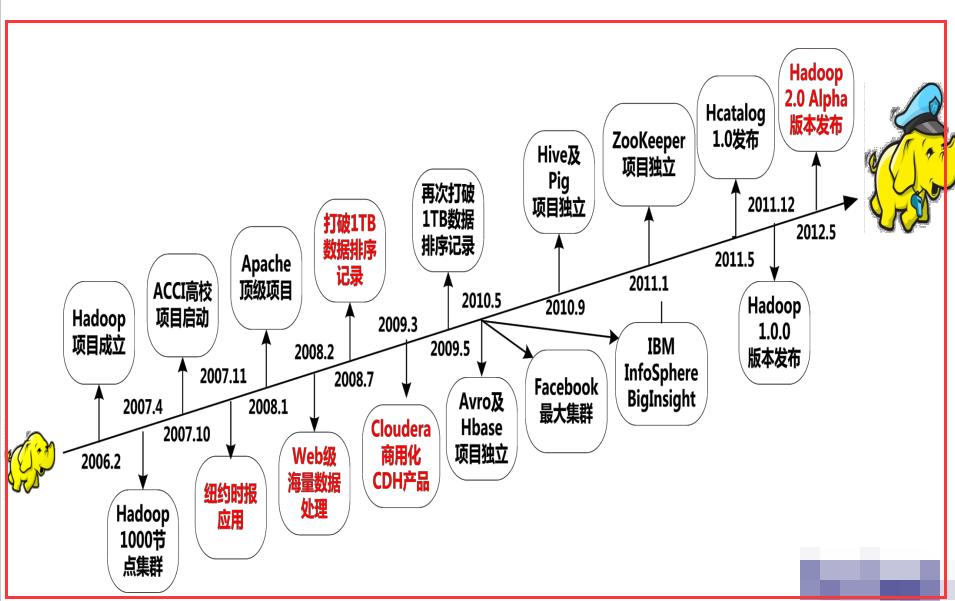
3.4、Hadoop生态圈
经过几年的发展,Hadoop已经发展成包含多个相关项目的软件生态系统。(也就是说Hadoop包含着许多的子项目)
1)狭义的Hadoop
核心项目:
Hadoop Common: 在 0.20 及以前的版本中,包含 HDFS、 MapReduce 和其他项目公共内容,从 0.21 开始 HDFS和 MapReduce 被分离为独立的子项目,其余内容为 Hadoop Common
为Hadoop其他项目提供一些常用工具,如系统配置工具Configuration、远程过程调用RPC序列化机制、Had抽象文件系统FileSystem等。
HDFS: Hadoop 分布式文件系统(Distributed File System),运行大型商用机集群,是Hadoop体系中海量数据储存管理的基础。
MapReduce: 并行计算框架, 0.20 前使用 org.apache.hadoop.mapred 旧接口, 0.20 版本开始引入 org.apache.hadoop.mapreduce 的新 API。
分布式数据处理模型和执行环境,是Hadoop体系中海量数据处理的基础。
2)广义的Hadoop
核心项目+其他项目(Avro、Zppkeeper、Hive、Pig、Hbase等):
上面为基础,面向具体领域或应用的项目有:mahout、X-Rime、Crissbow、lvory等
数据交换、工作流等外围支撑系统:Chukwa、Flume、Sqoop、Oozie

子项目:
Hbase:
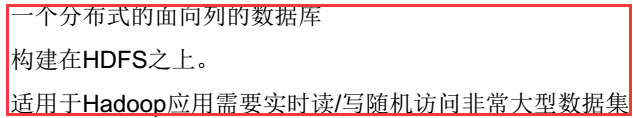
Zookeeper:

Apache Pig:

Apache Hive:
Apache Flume:

Apache sqoop:
Mahout:

Ambari:

hadoop(一)之初识大数据与Hadoop的更多相关文章
- Hadoop基础之初识大数据与Hadoop
前言 从今天起,我将一步一步的分享大数据相关的知识,其实很多程序员感觉大数据很难学,其实并不是你想象的这样,只要自己想学,还有什么难得呢? 学习Hadoop有一个8020原则,80%都是在不断的配置配 ...
- [Hadoop 周边] 浅谈大数据(hadoop)和移动开发(Android、IOS)开发前景【转】
原文链接:http://www.d1net.com/bigdata/news/345893.html 先简单的做个自我介绍,我是云6期的,黑马相比其它培训机构的好偶就不在这里说,想比大家都比我清楚: ...
- 大数据技术Hadoop入门理论系列之一----hadoop生态圈介绍
Technorati 标记: hadoop,生态圈,ecosystem,yarn,spark,入门 1. hadoop 生态概况 Hadoop是一个由Apache基金会所开发的分布式系统基础架构. 用 ...
- 大数据笔记01:大数据之Hadoop简介
1. 背景 随着大数据时代来临,人们发现数据越来越多.但是如何对大数据进行存储与分析呢? 单机PC存储和分析数据存在很多瓶颈,包括存储容量.读写速率.计算效率等等,这些单机PC无法满足要求. 2. ...
- 大数据和Hadoop生态圈
大数据和Hadoop生态圈 一.前言: 非常感谢Hadoop专业解决方案群:313702010,兄弟们的大力支持,在此说一声辛苦了,经过两周的努力,已经有啦初步的成果,目前第1章 大数据和Hadoop ...
- 大数据测试之hadoop集群配置和测试
大数据测试之hadoop集群配置和测试 一.准备(所有节点都需要做):系统:Ubuntu12.04java版本:JDK1.7SSH(ubuntu自带)三台在同一ip段的机器,设置为静态IP机器分配 ...
- 老李分享:大数据框架Hadoop和Spark的异同 1
老李分享:大数据框架Hadoop和Spark的异同 poptest是国内唯一一家培养测试开发工程师的培训机构,以学员能胜任自动化测试,性能测试,测试工具开发等工作为目标.如果对课程感兴趣,请大家咨 ...
- 大数据:Hadoop入门
大数据:Hadoop入门 一:什么是大数据 什么是大数据: (1.)大数据是指在一定时间内无法用常规软件对其内容进行抓取,管理和处理的数据集合,简而言之就是数据量非常大,大到无法用常规工具进行处理,如 ...
- 大数据和Hadoop时代的维度建模和Kimball数据集市
小结: 1. Hadoop 文件系统中的存储是不可变的,换句话说,只能插入和追加记录,不能修改数据.如果你熟悉的是关系型数据仓库,这看起来可能有点奇怪.但是从内部机制看,数据库是以类似的机制工作,在一 ...
随机推荐
- [js高手之路]Vue2.0基于vue-cli+webpack父子组件通信教程
在git命令行下,执行以下命令完成环境的搭建: 1,npm install --global vue-cli 安装vue命令行工具 2,vue init webpack vue-demo 使用v ...
- Java线程:线程栈模型
要理解线程调度的原理,以及线程执行过程,必须理解线程栈模型. 线程栈是指某时刻时内存中线程调度的栈信息,当前调用的方法总是位于栈顶.线程栈的内容是随着程序的运行动态变化的,因此研究线程栈必须选择一个运 ...
- nhibernate教程(4)--条件查询(Criteria Query)
NHibernate之旅(4):探索查询之条件查询(Criteria Query) 2008-10-16 18:20 by 李永京, 44341 阅读, 43 评论, 收藏, 编辑 本节内容 NHi ...
- Banner图二三事
前 言 JRedu 作为一个准前端学员,banner图可是很重要的呢.本人,小白一只,给大家分享几个刚刚学习的基础banner图事件.~~~ 1. 小广告图滚动播放 1.1HTML代码 首先,创 ...
- 201521123082 《Java程序设计》第1周学习总结
201521123082 <Java程序设计>第1周学习总结 标签(空格分隔): Java 1. 本周学习总结 0.初步了解Java语言及其发展历史和过程,同时也初步了解了Java具有跨平 ...
- sudoku--SE第二次作业
git传送门 编译环境: windows10.vs2017 所用语言: c++ 首先作为一个晚上闭眼的玩家,我先来讲一下我的心路历程: 最开始接到作业的时候心里是拒绝的,刚出了一趟小远门就这样,就很难 ...
- 线程高级篇-读写锁ReentrantReadWriteLock
转载原文:http://blog.csdn.net/john8169/article/details/53228016 读写锁: 分为读锁和写锁,多个读锁不互斥,读锁和写锁互斥,这是有JVM自己控制的 ...
- 201521123063 《Java程序设计》 第14周学习总结
1. 本周学习总结 1.1 以你喜欢的方式(思维导图.Onenote或其他)归纳总结多数据库相关内容. 2. 书面作业 1. MySQL数据库基本操作 1.1 建立数据库test.表students. ...
- 201521145048 《Java程序设计》第7周学习总结
1. 本周学习总结 2. 书面作业 Q1.ArrayList代码分析 1.1 解释ArrayList的contains源代码 1.2 解释E remove(int index)源代码 1.3 结合1. ...
- 201521123068 《java程序设计》 第11周学习总结
1. 本周学习总结 1.1 以你喜欢的方式(思维导图或其他)归纳总结多线程相关内容. 多线程的冲突:同时运行的线程需要访问共享数据(临界资源) 多线程的互斥访问:两个或两个以上的线程需要同时对同一数据 ...