
通过爬虫爬取四川省公共资源交易平台上最近的招标信息 --- URLConnection
通过爬虫爬取公共资源交易平台(四川省)最近的招标信息
一:引入JSON的相关的依赖
<dependency>
<groupId>net.sf.json-lib</groupId>
<artifactId>json-lib</artifactId>
<version>2.4</version>
<classifier>jdk15</classifier>
</dependency>
二:通过请求的url获取URLConnection连接
package com.svse.pachong;
import java.io.InputStream;
import java.net.HttpURLConnection;
import java.net.URL;
import java.net.URLConnection;import org.apache.log4j.Logger;
/**
* 通过请求的url获取URLConnection连接
* @author lenovo
* @date 2019年1月22日
* description:
*/
public class open_url_test {public static Logger logger = Logger.getLogger(open_url_test.class);
public boolean openurl(String url_infor) throws Exception{
URL url = new URL(url_infor);
// 连接类的父类,抽象类
URLConnection urlConnection = url.openConnection();// http的连接类
HttpURLConnection httpURLConnection = (HttpURLConnection) urlConnection;/* 设定请求的方法,默认是GET(对于知识库的附件服务器必须是GET,如果是POST会返回405。
流程附件迁移功能里面必须是POST,有所区分。)*/
httpURLConnection.setRequestMethod("GET");
// 设置字符编码 httpURLConnection.setRequestProperty("Charset", "UTF-8");
// 打开到此 URL引用的资源的通信链接(如果尚未建立这样的连接)。
int code = httpURLConnection.getResponseCode();
System.out.println("code:"+code); //连接成功 200
try {
InputStream inputStream = httpURLConnection.getInputStream();
System.out.println("连接成功");
logger.info("打开"+url_infor+"成功!");
return true;
}catch (Exception exception){
logger.info("打开"+url_infor+"失败!");
return false;
}
}
}
三:通过爬取的url解析想要的数据,并以json的格式返回
package com.svse.pachong;
import java.io.BufferedReader;
import java.io.IOException;
import java.io.InputStream;
import java.io.InputStreamReader;
import java.net.URL;
import java.nio.charset.Charset;
import net.sf.json.JSONException;
import net.sf.json.JSONObject;/**
* 通过爬取的url解析想要的数据,并以json的格式返回
* @param urlString 需要爬取的网站url路径
* @return 返回json结果的数据
* @throws IOException
* @throws JSONException
*/
public class readData {public static JSONObject readData(String urlString) throws IOException, JSONException{
InputStream is = new URL(urlString).openStream();
try {
BufferedReader rd = new BufferedReader(new InputStreamReader(is, Charset.forName("UTF-8")));
StringBuilder sb = new StringBuilder();
int cp;
while ((cp = rd.read()) != -1) {
sb.append((char) cp);
}
String jsonText = sb.toString();
JSONObject json = JSONObject.fromObject(jsonText);
return json;
} finally {
is.close();
}
}
}
四:爬取入口
package com.svse.pachong;
import java.io.IOException;
import net.sf.json.JSONArray;
import net.sf.json.JSONException;
import net.sf.json.JSONObject;/**
* 爬取的入口
* @author lenovo
* @date 2019年1月22日
* description:
*/
public class Main {static String urlString = "http://www.scggzy.gov.cn/Info/GetInfoListNew?keywords=×=4×Start=×End=&province=&area=&businessType=&informationType=&industryType=&page=1&parm=1534929604640";
@SuppressWarnings("static-access")
public static void main(String[] args) {open_url_test oUrl = new open_url_test();
try {
if (oUrl.openurl(urlString)) {
readData rData = new readData();
JSONObject json = rData.readData(urlString);
JSONObject ob=JSONObject.fromObject(json);String data=ob.get("data").toString(); //JSONObject 转 String
data="["+data.substring(1,data.length()-1)+"]";JSONArray json2=JSONArray.fromObject(data); //String 转 JSONArray
for (int i = 0; i < 10; i++) {
JSONObject jsonObject = (JSONObject) json2.get(i);
System.out.println("--------------------------------------------");
System.out.println("项目: "+jsonObject.get("Title"));
System.out.println("时间: "+jsonObject.get("CreateDateStr"));
System.out.println(jsonObject.get("TableName"));
System.out.println(jsonObject.get("Link"));
System.out.println( jsonObject.get("province") +" "+jsonObject.get("username")+" "+jsonObject.get("businessType")+" "+jsonObject.get("NoticeType"));
}
}else{
System.out.println("解析数据失败!");
}
} catch (JSONException e) {
e.printStackTrace();
} catch (IOException e) {
e.printStackTrace();
} catch (Exception e) {
e.printStackTrace();
}
}}
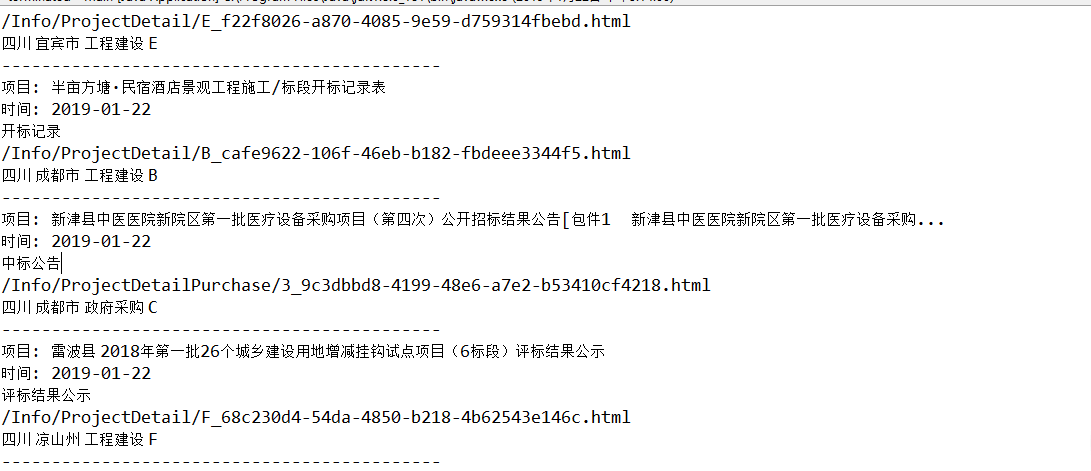
四:测试结果
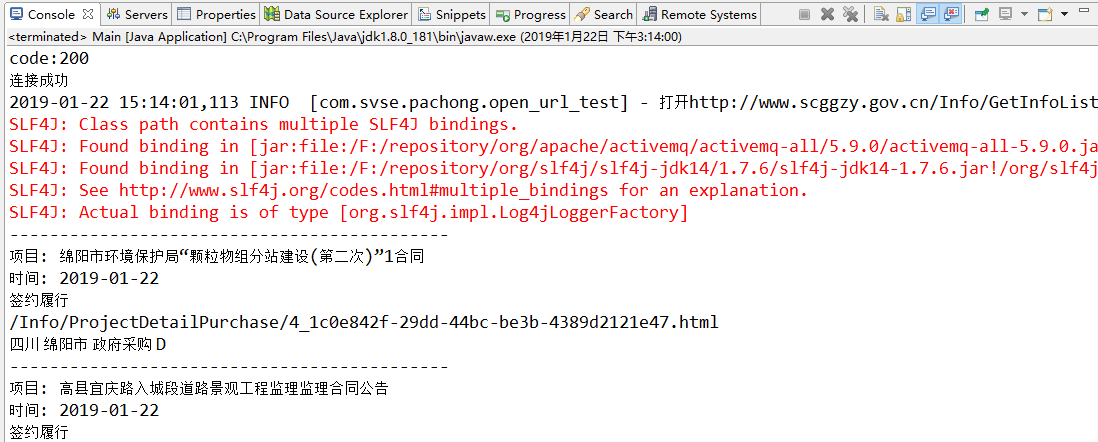
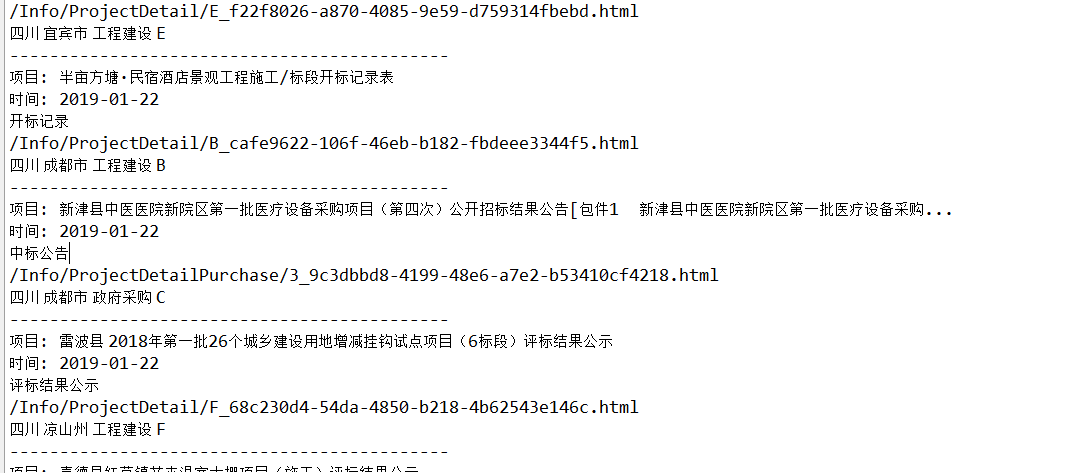
至此,整个爬取的任务就结束了!
通过爬虫爬取四川省公共资源交易平台上最近的招标信息 --- URLConnection的更多相关文章
- python爬虫爬取京东、淘宝、苏宁上华为P20购买评论
爬虫爬取京东.淘宝.苏宁上华为P20购买评论 1.使用软件 Anaconda3 2.代码截图 三个网站代码大同小异,因此只展示一个 3.结果(部分) 京东 淘宝 苏宁 4.分析 这三个网站上的评论数据 ...
- Java爬虫爬取网站电影下载链接
之前有看过一段时间爬虫,了解了爬虫的原理,以及一些实现的方法,本项目完成于半年前,一直放在那里,现在和大家分享出来. 网络爬虫简单的原理就是把程序想象成为一个小虫子,一旦进去了一个大门,这个小虫子就像 ...
- 如何使用robots禁止各大搜索引擎爬虫爬取网站
ps:由于公司网站配置的测试环境被百度爬虫抓取,干扰了线上正常环境的使用,刚好看到每次搜索淘宝时,都会有一句由于robots.txt文件存在限制指令无法提供内容描述,于是便去学习了一波 1.原来一般来 ...
- node:爬虫爬取网页图片
代码地址如下:http://www.demodashi.com/demo/13845.html 前言 周末自己在家闲着没事,刷着微信,玩着手机,发现自己的微信头像该换了,就去网上找了一下头像,看着图片 ...
- 用Python爬虫爬取广州大学教务系统的成绩(内网访问)
用Python爬虫爬取广州大学教务系统的成绩(内网访问) 在进行爬取前,首先要了解: 1.什么是CSS选择器? 每一条css样式定义由两部分组成,形式如下: [code] 选择器{样式} [/code ...
- 简单的python爬虫--爬取Taobao淘女郎信息
最近在学Python的爬虫,顺便就练习了一下爬取淘宝上的淘女郎信息:手法简单,由于淘宝网站本上做了很多的防爬措施,应此效果不太好! 爬虫的入口:https://mm.taobao.com/json/r ...
- 使用Python爬虫爬取网络美女图片
代码地址如下:http://www.demodashi.com/demo/13500.html 准备工作 安装python3.6 略 安装requests库(用于请求静态页面) pip install ...
- python3爬虫爬取网页思路及常见问题(原创)
学习爬虫有一段时间了,对遇到的一些问题进行一下总结. 爬虫流程可大致分为:请求网页(request),获取响应(response),解析(parse),保存(save). 下面分别说下这几个过程中可以 ...
- python网络爬虫(10)分布式爬虫爬取静态数据
目的意义 爬虫应该能够快速高效的完成数据爬取和分析任务.使用多个进程协同完成一个任务,提高了数据爬取的效率. 以百度百科的一条为起点,抓取百度百科2000左右词条数据. 说明 参阅模仿了:https: ...
随机推荐
- 【Java源码】集合类-LinkedList
一.类继承关系 LinkedList和ArrayList都实现了List接口.所以有List的特性,同时LinkedList也实现了Deque,所以它也具有双端队列和栈的特性. public clas ...
- foobar2000播放dff格式音乐的解决办法
安装dff插件:http://www.foobar2000.org/components/view/foo_input_dsdiff 离线版本:链接:http://pan.baidu.com/s/1e ...
- Java中的数字
以下内容引用自http://wiki.jikexueyuan.com/project/java/numbers.html: 通常情况下,当处理数字时,使用原始数据类型,如byte,int,long,d ...
- 当Eclipse爱上SVN
推荐使用:Subclipse :http://jingyan.baidu.com/article/1612d5007d41e9e20e1eeeff.html 为离线安装做准备: 1.下载Subver ...
- Deepin-安装vscode
安装方式有两种: 1.通过命令安装 sudo apt-get install vscode 2.通过deb或rpm包安装 我们是Debian系列的系统,所以用deb包,关于红帽系统,请使用rpm包. ...
- Spark应用远程调试
本来想用Eclipse的.然而在网上找了一圈,发现大家都在说IntelliJ怎样怎样好.我也受到了鼓励,遂决定在这台破机器上鼓捣一次IntelliJ吧. Spark程序远程调试,就是将本地IDE连接到 ...
- Jenkins系列之-—01 简介&新建任务
一.Jenkins 简介 Jenkins是一个可扩展的持续集成引擎. 主要用于: l 持续.自动地构建/测试软件项目.l 监控一些定时执行的任务. Jenkins拥有的特性包括: l 易于安装-只要把 ...
- Vs2017添加引用时报错 未能正确加载“ReferenceManagerPackage”包。
Vs2017添加引用时报错未能正确加载“ReferenceManagerPackage”包. 最近新装了2017,开始前几天还好, 可是最近在添加引用时,报错 -------------------- ...
- iOS开发——高级篇——多线程GCD死锁
面试题 请问以下代码打印结果: - (void)interview01 { // 以下代码是在主线程执行的 NSLog(@"执行任务1"); dispatch_queue_t qu ...
- Koa2学习(六)使用koa-router
Koa2学习(六)使用koa-router 配置简单路由 引入中间件 配置需要的路由 通过app.use注册路由 const Koa = require('koa') const app = new ...