
python 爬虫豆瓣top250
网页api:https://movie.douban.com/top250?start=0&filter=
用到的模块:urllib,re,csv
捣鼓一上午终于好了,有些小问题
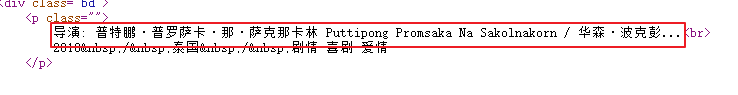
(top218有bug)具体问题:上图没有主演:用到正则表达式时取出过多的值,下图则是正常取值
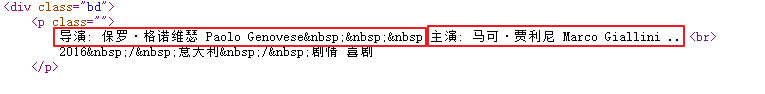
所以取前200名,具体python代码实现如下,望大佬指导
#! /usr/bin/python3
# -*- coding:UTF-8 -*-
from urllib import request
import re,csv class MovieTopForDouBan(object):
def __init__(self):
self.start = 0
self.param = '&filter='
self.headers={'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 '
'(KHTML, like Gecko) Chrome/66.0.3359.181 Safari/537.36'}
self.file_path = 'D:\\'
self.head = ['排名','名称','别名','其他名称','导演','主演','年份','地区','类型','平均分','人数','短评']
self.movie_list=[] def get_page(self):
try:
url = 'https://movie.douban.com/top250?start=' + str(self.start)
req = request.Request(url, headers=self.headers)
response = request.urlopen(req)
page = response.read().decode('utf-8')
page_num = (self.start + 25) // 25
print('正在抓取第' + str(page_num) + '页数据...')
self.start += 25
return page
except request.URLError as e:
if hasattr(e, 'reason'):
print('抓取失败,失败原因:', e.reason) def get_movie_info(self):
pattern = re.compile(u'<div.*?class="item">.*?<em class="">(.*?)</em>'
u'.*?<span.*?class="title">(.*?)</span>'
u'.*?<span.*?class="title">(.*?)</span>'
u'.*?<span.*?class="other">(.*?)</span>'
u'.*?<div.*?class="bd">.*?<p.*?class="">'
u'.*?导演:(.*?) .*?主演: (.*?)<br>'
u'(.*?) / (.*?) / (.*?)</p>.*?<div.*?class="star">'
u'.*?<span.*?class="rating_num".*?property="v:average">(.*?)</span>'
u'.*?<span>(.*?)人评价</span>.*?</div>'
u'.*?<span.*?class="inq">(.*?)</span>.*?</p>', re.S)
while self.start <= 176:#取前俩百 (top:218 电影名:初恋这件小事)有bug
page=self.d=self.get_page()
movies=re.findall(pattern,page)
for movie in movies:
data =list(movie)
data[2] = data[2].lstrip(' / ')
data[3] = data[3].lstrip(' / ')
data[6] = data[6].lstrip()
data[8] = data[8].rstrip()
self.movie_list.append(data) def write_text(self):
print('开始向文件写入数据....')
with open(self.file_path+'movie_info.txt','w',encoding='utf-8') as file_TopText:
try:
for movie in self.movie_list:
file_TopText.write('电影排名:' + movie[0] + '\r\n')
file_TopText.write('电影名称:' + movie[1] + '\r\n')
file_TopText.write('外文名称:' + movie[2] + '\r\n')
file_TopText.write('电影别名:' + movie[3] + '\r\n')
file_TopText.write('导演姓名:' + movie[4] + '\r\n')
file_TopText.write('主演姓名:' + movie[5] + '\r\n')
file_TopText.write('上映年份:' + movie[6] + '\r\n')
file_TopText.write('制作国家/地区:' + movie[7] + '\r\n')
file_TopText.write('电影类别:' + movie[8] + '\r\n')
file_TopText.write('电影评分:' + movie[9] + '\r\n')
file_TopText.write('参评人数:' + movie[10] + '\r\n')
file_TopText.write('简短影评:' + movie[11] + '\r\n\r\n')
print('抓取结果写入文件成功...')
except Exception as e:
print(e)
print('数据写入完毕....') def write_csv_file(self):
path = self.file_path + 'movie_info.csv'
common=0
try:
with open(path, 'w', newline='',encoding='utf-8') as csv_file:
writer = csv.writer(csv_file, dialect='excel')
if self.head is not None:
writer.writerow(self.head)
for row in self.movie_list:
writer.writerow(row)
common+=1
print("将CSV文件写入路径%s成功。" % path)
except Exception as e:
print("将CSV文件写入路径: %s, 信息: %s" % (path, e))
print(common) def main(self):
print('开始从豆瓣电影抓取数据........')
self.get_movie_info()
self.write_text()
#self.write_csv_file()
print('数据抓取完毕...') if __name__ == '__main__':
movie = MovieTopForDouBan()
movie.main()
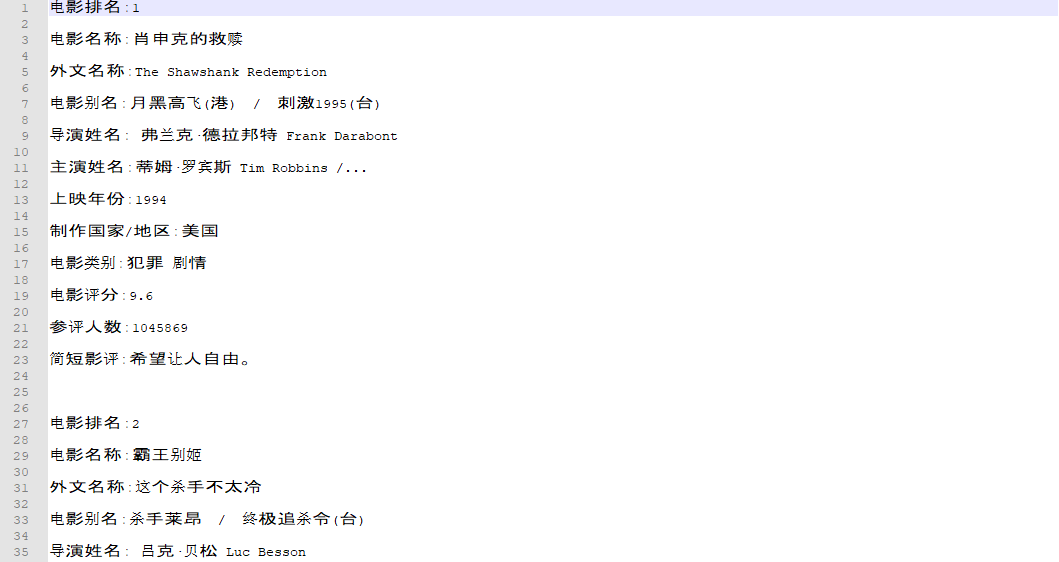
d盘根目录生成一个movie_info.txt 文件
python 爬虫豆瓣top250的更多相关文章
- python爬虫---豆瓣Top250电影采集
代码: import requests from bs4 import BeautifulSoup as bs import time def get_movie(url): headers = { ...
- Forward团队-爬虫豆瓣top250项目-项目总结
托管平台地址:https://github.com/xyhcq/top250 小组名称:Forward团队 组长:马壮 成员:李志宇.刘子轩.年光宇.邢云淇.张良 我们这次团队项目内容是爬取豆瓣电影T ...
- Forward团队-爬虫豆瓣top250项目-项目进度
项目地址:https://github.com/xyhcq/top250 我们的项目是爬取豆瓣top250的电影的信息,在做这个项目前,我们都没有经验,完全是从零开始,过程中也遇到了很多困难,不过我们 ...
- Forward团队-爬虫豆瓣top250项目-设计文档
组长地址:http://www.cnblogs.com/mazhuangmz/p/7603594.html 成员:马壮,李志宇,刘子轩,年光宇,邢云淇,张良 设计方案: 1.能分析HTML语言: 2. ...
- 《Forward团队-爬虫豆瓣top250项目-设计文档》
成员:马壮,李志宇,刘子轩,年光宇,邢云淇,张良 设计方案: 1.能分析HTML语言: 2.提取重要数据,并保存为文本文档: 3.用PY代码调取文本文档的数据: 4.编写提取部分数据的python代码 ...
- 《Forward团队-爬虫豆瓣top250项目-开发文档》
码云地址:https://github.com/xyhcq/top250 模块功能:获取豆瓣top250网页的源代码,并分析. def getHTMLText(url,k): # 获取网页源代码 tr ...
- python爬虫: 豆瓣电影top250数据分析
转载博客 https://segmentfault.com/a/1190000005920679 根据自己的环境修改并配置mysql数据库 系统:Mac OS X 10.11 python 2.7 m ...
- Forward团队-爬虫豆瓣top250项目-需求分析
一. 需求:1.爬取豆瓣电影top250. 2.获取电影名称,排名,分数,简介,导演,演员. 3.将爬取到的数据保存,以便随时查看. 3.可以将获取到的数据展示给用户. 二. 参考: 豆瓣api参考资 ...
- Forward团队-爬虫豆瓣top250项目-模块测试
项目托管平台地址:https://github.com/xyhcq/top250 模块测试:爬虫对信息的处理部分 测试方法: 实际运行一下代码: 可以看见,信息都已经爬取出来了 其他补充说明: 原本系 ...
随机推荐
- (转)Linux最常用指令及快捷键 Linux学习笔记
Linux最常用指令及快捷键 Linux学习笔记 原文:http://blog.csdn.net/yanghongche/article/details/50827478 [摘自 鸟叔的私房菜]--转 ...
- Linux网络编程函数
1. Server端-socket/bind/listen/accept/read socket(AF_INET, SOCK_STREAM, 0); //指定端口,内核将端口上的数据转发给该socke ...
- 有限状态机在单片机和 Arduino 编程中的应用
有限状态机在单片机和 Arduino 编程中的应用,个人认为在实际中这是一种思想,意味着解决一类问题. 本帖最后由 张飞 于 2015-3-4 20:18 编辑 在单片机编程中,如果在不使用操作系统的 ...
- 19.CentOS7下PostgreSQL安装过程
CentOS7下PostgreSQL安装过程 装包 sudo yum install postgresql-server postgresql-contrib 说明: 这种方式直接明了,其他方法也可以 ...
- Java开发笔记(九十八)利用Callable启动线程
前面介绍了如何利用Runnable接口构建线程任务,该方式确实方便了线程代码的复用与共享,然而Runnable不像公共方法那样有返回值,也就无法将线程代码的处理结果传给外部,造成外部既不知晓该线程是否 ...
- Sublime常用插件安装大全
作为前端人员,要找一个很顺手的编辑器真的不容易,我向大家推荐的一款实用前端开发神器,不但占地小,且插件很多,很强大. 下面我向大家介绍一下它的安装及插件的使用方法. 一.安装及安装emmet插件 首先 ...
- display:table的几个用法(元素平分宽度,垂直居中)
DIV+CSS的布局已经让表格布局几乎很少用到,除非表格语义性很强的情况. display:table解决了一部分需要使用表格特性但又不需要表格语义的情况, 尤其是DIV+CSS很不方便解决的问题,比 ...
- ASP.NET MVC 长连接(服务器推)完整实现
1.什么是"服务器推"(百科来一波)? 传统模式的 Web 系统以客户端发出请求.服务器端响应的方式工作.这种方式并不能满足很多现实应用的需求,譬如: 监控系统:后台硬件热插拔.L ...
- pta 编程题20 旅游规划
其它pta数据结构编程题请参见:pta 题目 这个最短路径问题只需要求两点之间的最短路径,因而在Dijikstra算法中当求出目标点的最短路径之后跳出循环即可. #include <iostre ...
- [VC]vc中socket编程步骤
sockets(套接字)编程有三种,流式套接字(SOCK_STREAM),数据报套接字(SOCK_DGRAM),原始套接字(SOCK_RAW): 基于TCP的socket编程是采用的流式套接字.在这个 ...