
超详细的mysql总结(DQL)
CREATE TABLE IF NOT EXISTS `products` (

    id INT PRIMARY KEY AUTO_INCREMENT,

    brand VARCHAR(20),

    title VARCHAR(100) NOT NULL,

    price DOUBLE NOT NULL,

    score DECIMAL(2,1),

    voteCnt INT,

    url VARCHAR(100),

    pid INT

)

// 省略 insert into 插入数据部分
首先来查看一下表中的所有数据
SELECT * FROM `products`;

// * 代表展示所有的字段,如果只展示部分字段可以指定,可通过as对字段取别名,as可省略

SELECT id, brand as phoneBrand, title phoneTitle, price, score FROM `products`;
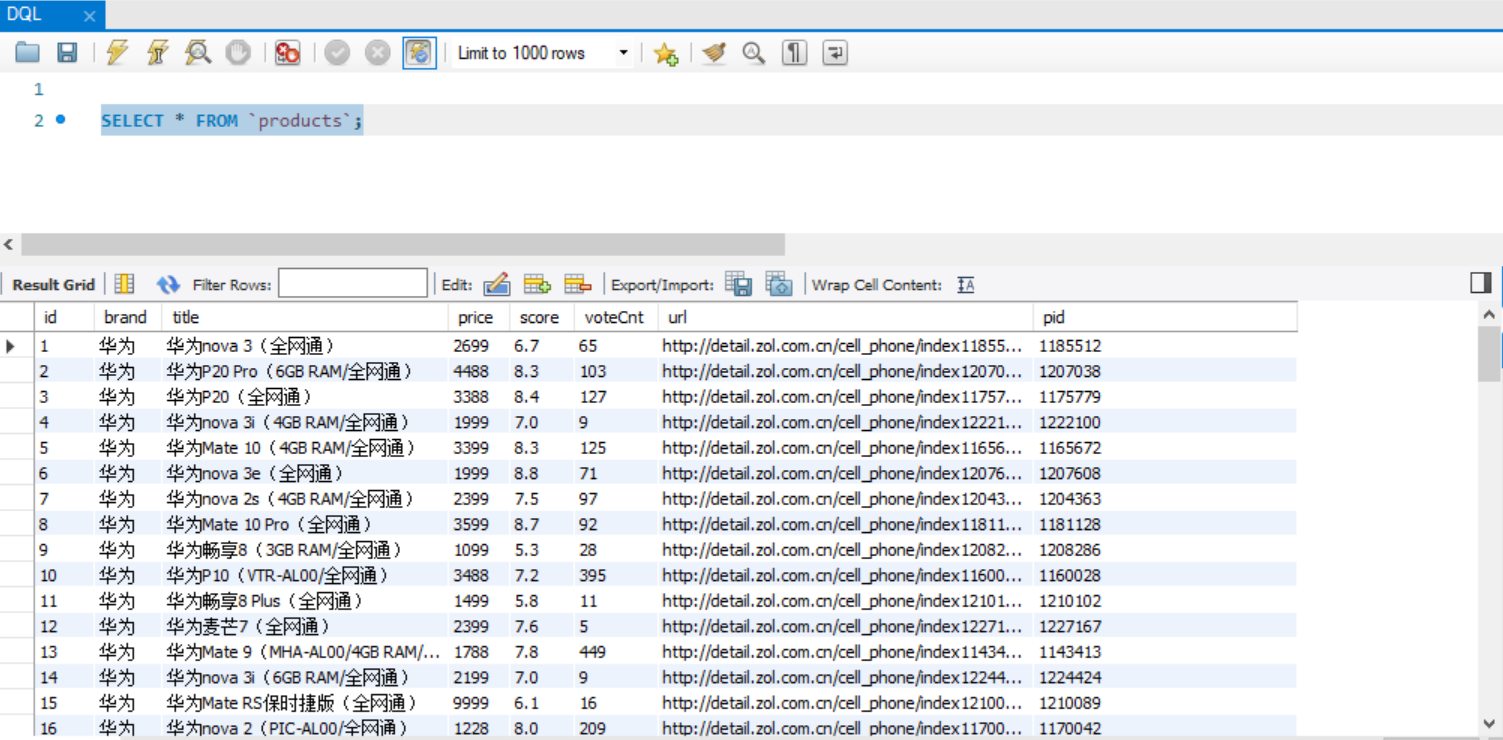
SELECT id, brand as phoneBrand, title phoneTitle, price, score From `products` WHERE brand = '华为';

// where后可以跟多个条件,用 AND() 或者 OR 来进行连接

SELECT * From `products` WHERE brand = '华为' && price > 4000; // 查询价格大于4000的华为手机

SELECT * From `products` WHERE score BETWEEN 5 AND 6; // 查询手机评分在5-6分之间的手机,包含5和6分

SELECT * FROM `products` WHERE brand LIKE '%v%'; // 匹配品牌名称包含字母为V的数据

SELECT * FROM `products` WHERE brand LIKE '_v%'; // 匹配品牌名称包含第二个字母为V的数据
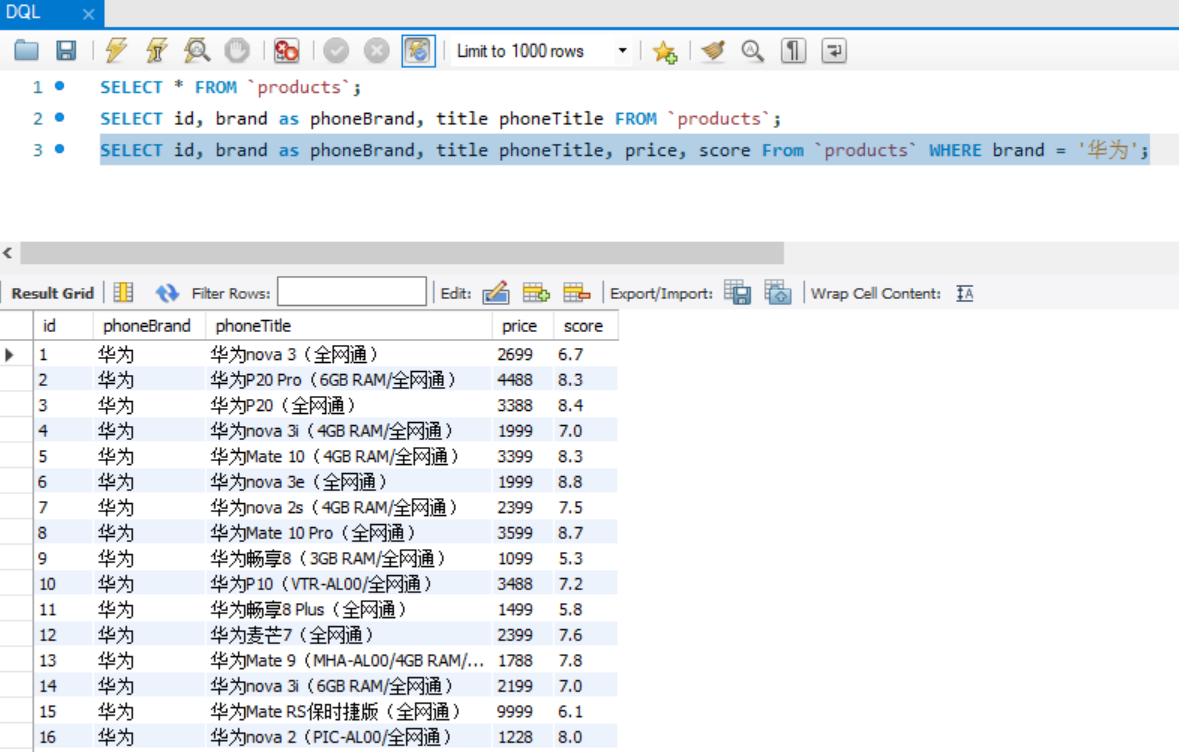
SELECT id, brand as phoneBrand, title phoneTitle, price, score From `products` WHERE brand = '华为' ORDER BY price DESC;
// DESC 代表降序, ASC 代表升序

// 通过price降序排列的时候,相同价格的产品,再对评分倒序排列

SELECT id, brand as phoneBrand, title phoneTitle, price, score From `products` WHERE brand = '华为' ORDER BY price DESC, score DESC;
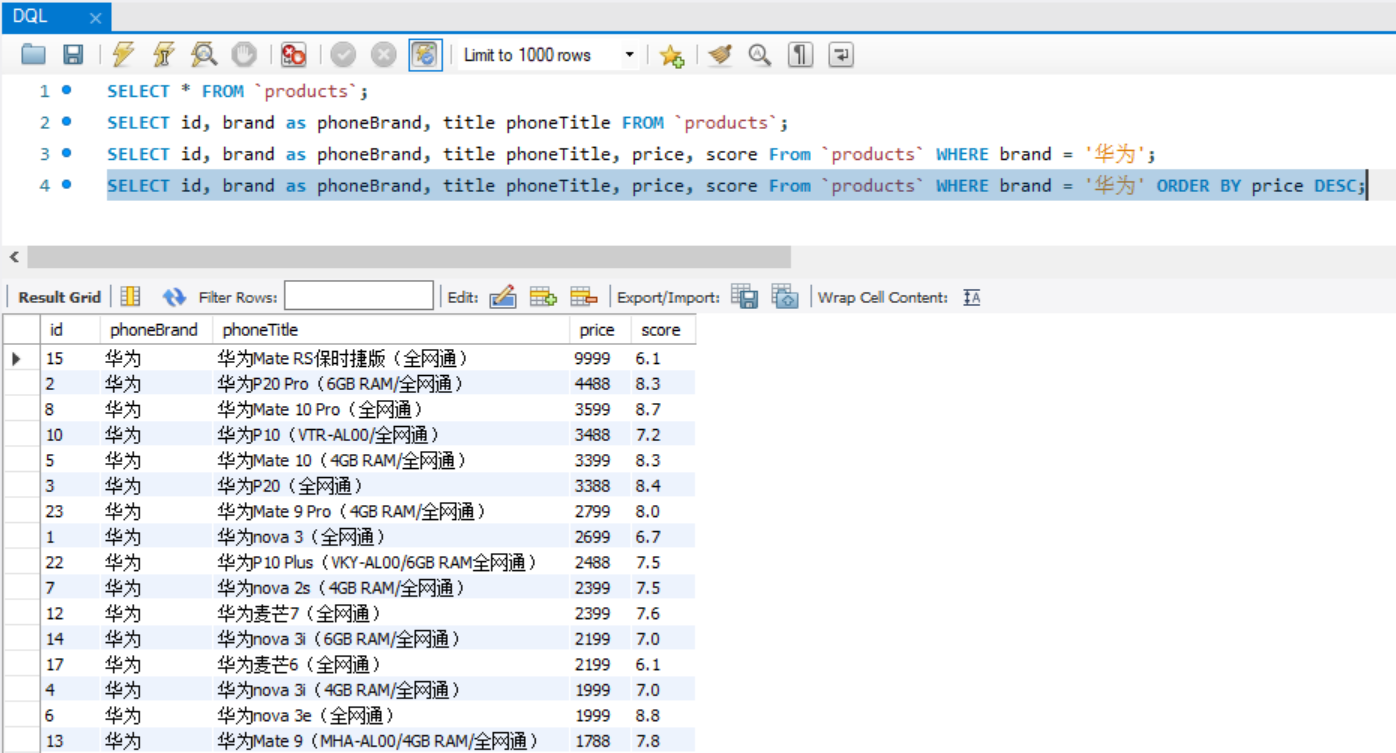
SELECT * FROM `products` LIMIT 10 OFFSET 40;

// LIMIT 10 OFFSET 40 代表偏移40条数据,往后取10条数据

// LIMIT 10, 40 代表偏移10条数据,往后取40条数据
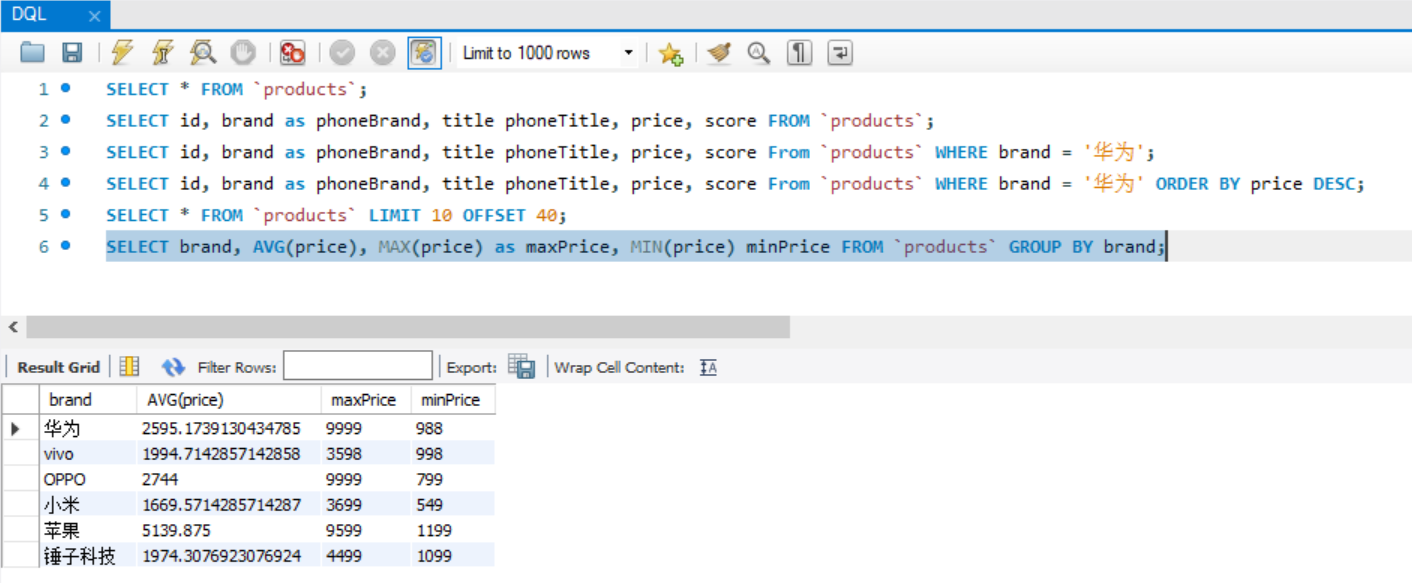
SELECT brand, AVG(price), MAX(price) as maxPrice, MIN(price) minPrice FROM `products` GROUP BY brand;

// 同样可以取别名,不取别名时展示的就是查询语句的字段名称

// 在统计出所有品牌的平均值、最大值、最小值后,只想取出价格范围在1000-5000之间的品牌

SELECT brand, AVG(price), MAX(price) as maxPrice, MIN(price) minPrice FROM `products` GROUP BY brand
HAVING maxPrice < 5000 && minPrice > 1000;

// 计算投票总数 SUM(voteCount)

// 计算所有的价格类别,去重 COUNT(DISTINCT price)
SELECT select_expr [, select_expr]...

    [FROM table_references]

    [WHERE where_condition]

    [ORDER BY expr [ASC | DESC]]

    [LIMIT {[offset,] row_count | row_count OFFSET offset}]

    [GROUP BY expr] [HAVING where_condition]
上面都是针对于一张表格来进行查询,但我们仔细观察,发现表格中的同一品牌手机的 brand 字段都是一致的,如果针对不同的品牌,要增加描述信息、官网等,那么需要在每一条数据中都重复添加,这样表格数据有大量冗余,可以考虑另建一张品牌表,放置品牌数据,这样就只用在商品表中存放品牌id,通过外键将商品和品牌关联上。
// 创建商品表

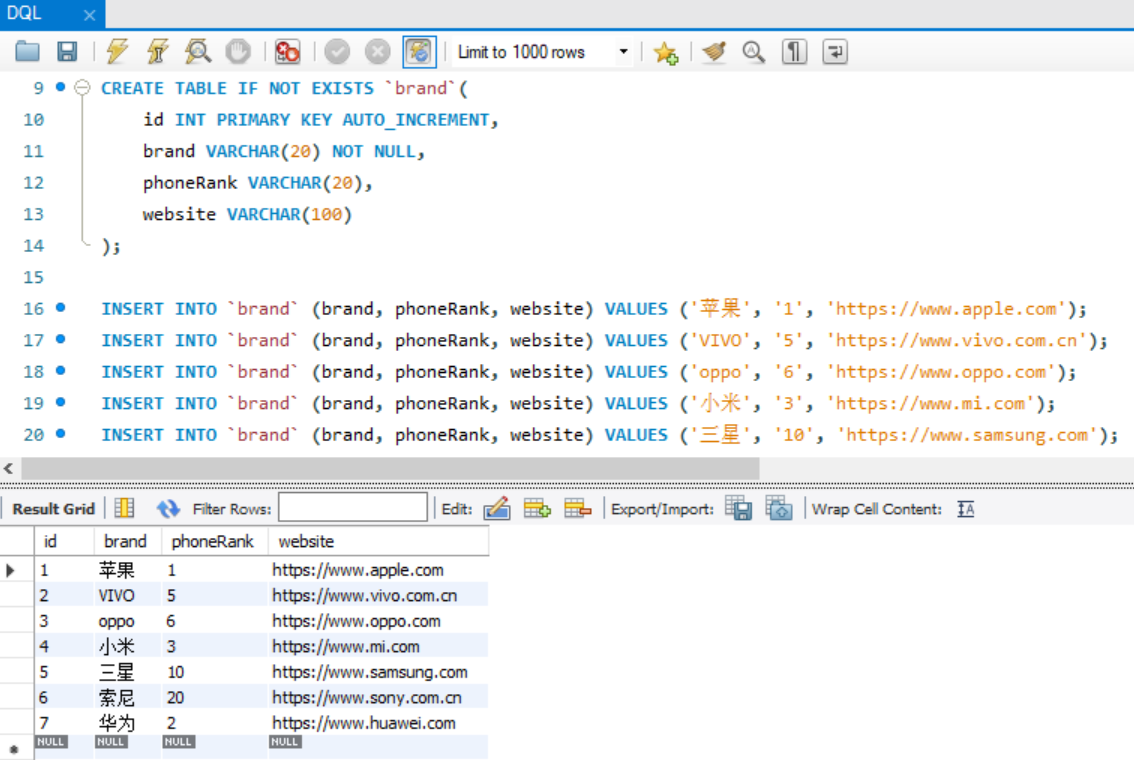
CREATE TABLE IF NOT EXISTS `brand`(

    id INT PRIMARY KEY AUTO_INCREMENT,

    brand VARCHAR(20) NOT NULL,

    phoneRank VARCHAR(20),

    website VARCHAR(100)

);
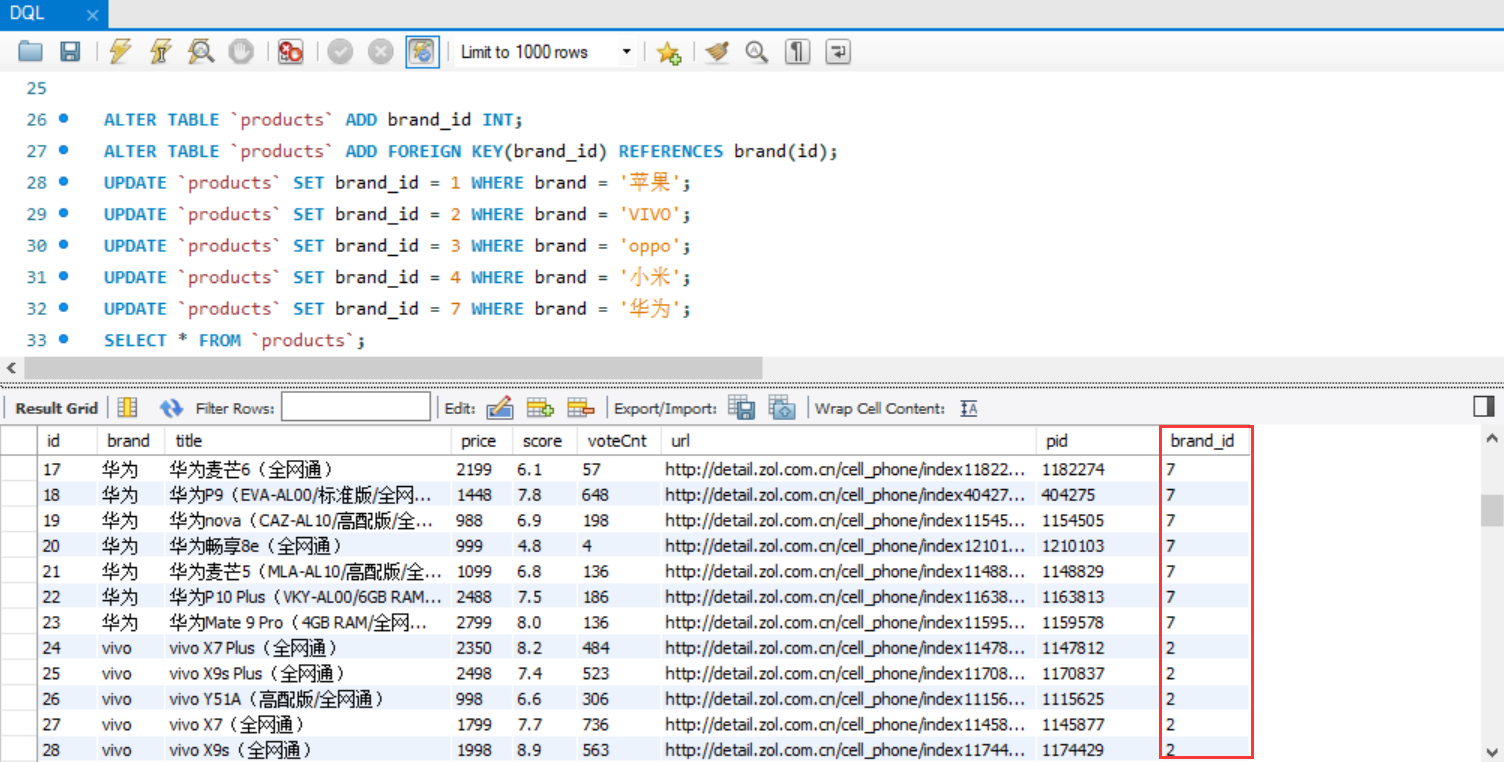
ALTER TABLE `products` ADD brand_id INT;

ALTER TABLE `products` ADD FOREIGN KEY(brand_id) REFERENCES brand(id);

UPDATE `products` SET brand_id = 1 WHERE brand = '苹果';

UPDATE `products` SET brand_id = 2 WHERE brand = 'VIVO';

UPDATE `products` SET brand_id = 3 WHERE brand = 'oppo';

UPDATE `products` SET brand_id = 4 WHERE brand = '小米';

UPDATE `products` SET brand_id = 7 WHERE brand = '华为';

SELECT * FROM `products`;
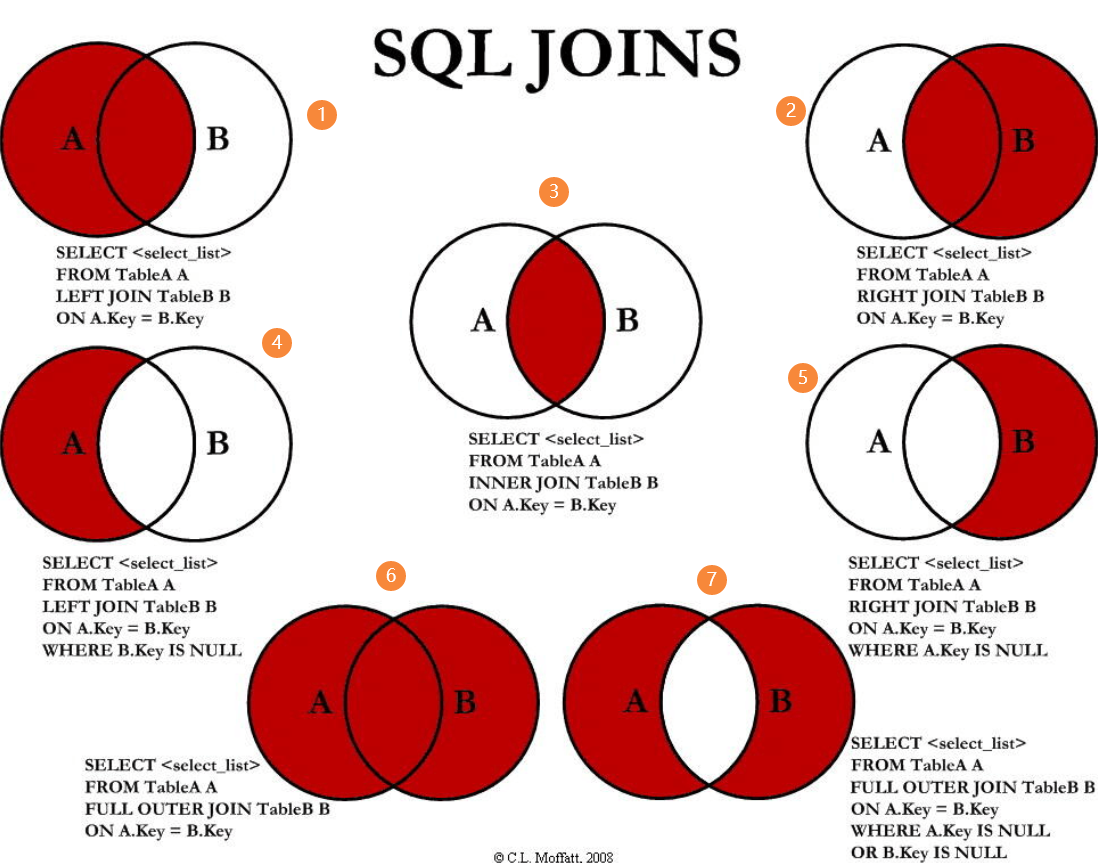
// 左连接,展示所有的商品,无论商品的品牌不在品牌表中,对应上图①

SELECT products.id, products.title, products.price, brand.id, brand.brand, brand.phoneRank, brand.website

FROM `products` LEFT JOIN `brand` ON products.brand_id = brand.id;

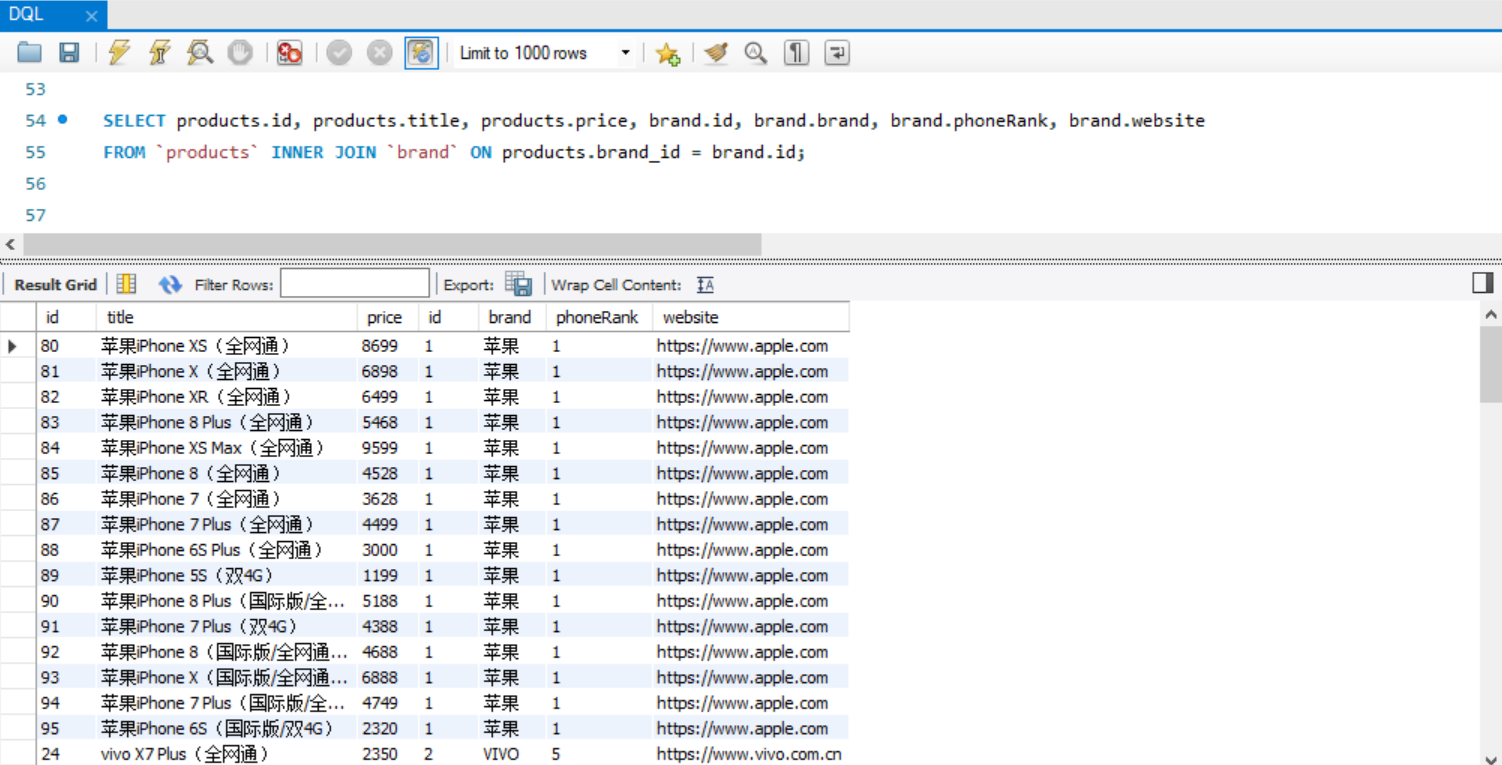
// 内连接,展示所有有brand_id的商品,对应上图 ③

SELECT products.id, products.title, products.price, brand.id, brand.brand, brand.phoneRank, brand.website

FROM `products` INNER JOIN `brand` ON products.brand_id = brand.id;

// 右连接,展示所有的品牌,无论是否存在该品牌的商品,对应上图⑤

SELECT products.id, products.title, products.price, brand.id, brand.brand, brand.phoneRank, brand.website

FROM `products` RIGHT JOIN `brand` ON products.brand_id = brand.id WHERE products.brand_id IS NULL;

// 外连接,展示所有商品和所有的品牌,对应上图 ⑥

(SELECT products.id, products.title, products.price, brand.id, brand.brand, brand.phoneRank, brand.website

FROM `products` LEFT JOIN `brand` ON products.brand_id = brand.id)

UNION

(SELECT products.id, products.title, products.price, brand.id, brand.brand, brand.phoneRank, brand.website

FROM `products` RIGHT JOIN `brand` ON products.brand_id = brand.id)
// 学生表

CREATE TABLE IF NOT EXISTS `students`(

    id INT PRIMARY KEY AUTO_INCREMENT,

    name VARCHAR(20) NOT NULL, age INT

);

// 课程表

CREATE TABLE IF NOT EXISTS `courses`(

    id INT PRIMARY KEY AUTO_INCREMENT,

    name VARCHAR(20) NOT NULL,

    price DOUBLE NOT NULL

);

// 学生选课关系表,设置联合主键,保证学生不会重复选课

CREATE TABLE IF NOT EXISTS `students_select_courses`(

    student_id INT NOT NULL,

    courses_id INT NOT NULL,

    FOREIGN KEY(student_id) REFERENCES students(id) ON UPDATE CASCADE,

    FOREIGN KEY(courses_id) REFERENCES courses(id) ON UPDATE CASCADE,

    PRIMARY KEY(student_id, courses_id)

);
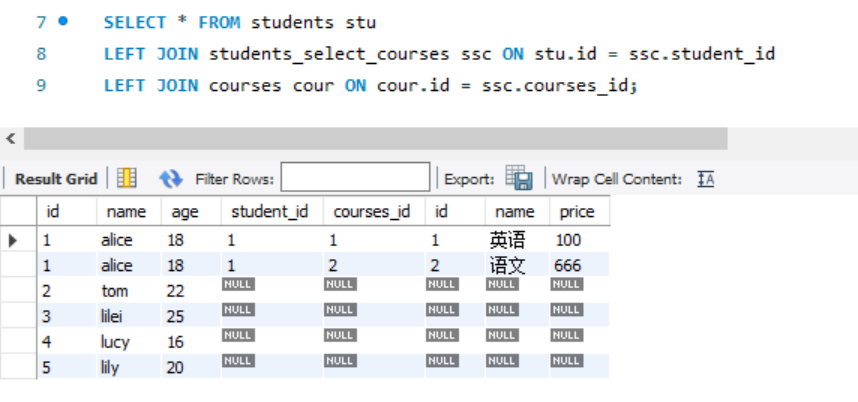
创建三张表,并添加数据后,通过 左连接、右连接、内连接等方式组合在一起查询出所需要的数据
// 左连接,查询所有的学生选课情况

SELECT * FROM students stu

LEFT JOIN students_select_courses ssc ON stu.id = ssc.student_id

LEFT JOIN courses cour ON cour.id = ssc.courses_id;

// 查询所有选课的学生情况

SELECT stu.name stuName, stu.age, cour.name courseName, cour.price courPrice

FROM students stu

LEFT JOIN students_select_courses ssc ON stu.id = ssc.student_id

LEFT JOIN courses cour ON cour.id = ssc.courses_id

WHERE ssc.courses_id IS NOT NULL;

// 哪些课程没有被选择

SELECT stu.name stuName, stu.age, cour.name courseName, cour.price courPrice

FROM students stu

LEFT JOIN students_select_courses ssc ON stu.id = ssc.student_id

RIGHT JOIN courses cour ON cour.id = ssc.courses_id

WHERE stu.id IS NULL;
// 组装成对象

SELECT products.id as id, products.title as title,

products.price as price, products.score as score,

JSON_OBJECT('id', brand.id, 'name', brand.brand, 'rank', brand.phoneRank,

'website', brand.website) as brand FROM products

LEFT JOIN brand ON products.brand_id = brand.id;

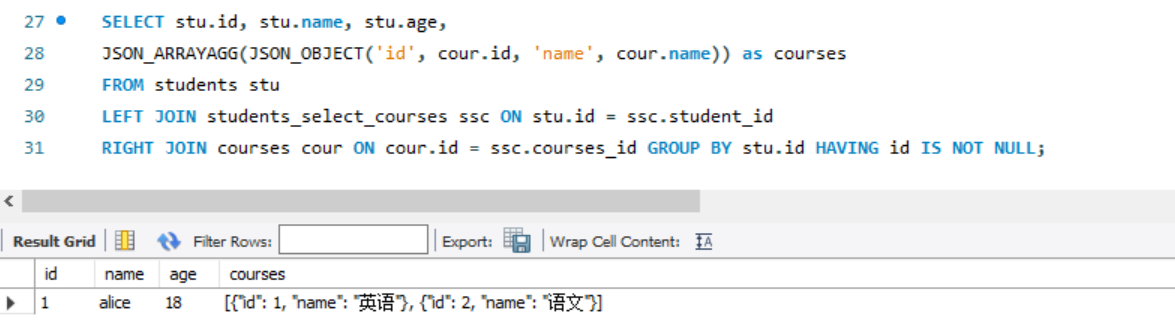
// 数据组装成数组对象

SELECT stu.id, stu.name, stu.age,

JSON_ARRAYAGG(JSON_OBJECT('id', cour.id, 'name', cour.name)) as courses

FROM students stu

LEFT JOIN students_select_courses ssc ON stu.id = ssc.student_id

RIGHT JOIN courses cour ON cour.id = ssc.courses_id GROUP BY stu.id HAVING id IS NOT NULL;
超详细的mysql总结(DQL)的更多相关文章
- 超详细讲解mysql存储过程中的in/out/inout
存储过程 大概定义:用一个别名来描述多个sql语句的执行过程. 最简单 delimiter // create PROCEDURE p1() begin select * from userinfo; ...
- 超详细,多图文使用galera cluster搭建mysql集群并介绍wsrep相关参数
超详细,多图文使用galera cluster搭建mysql集群并介绍wsrep相关参数 介绍galera cluster原理的文章已经有一大堆了,百度几篇看一看就能有相关了解,这里就不赘述了.本文主 ...
- Linux系统部署JavaWeb项目(超详细tomcat,nginx,mysql)
转载自:Linux系统部署JavaWeb项目(超详细tomcat,nginx,mysql) 我的系统是阿里云的,香港的系统,本人选择的是系统镜像:CentOS 7.3 64位. 具体步骤: 配置Jav ...
- 超强、超详细Redis数据库入门教程
这篇文章主要介绍了超强.超详细Redis入门教程,本文详细介绍了Redis数据库各个方面的知识,需要的朋友可以参考下 [本教程目录] 1.redis是什么2.redis的作者何许人也3.谁在使用red ...
- Struts2+Spring4+Hibernate4整合超详细教程
Struts2.Spring4.Hibernate4整合 超详细教程 Struts2.Spring4.Hibernate4整合实例-下载 项目目的: 整合使用最新版本的三大框架(即Struts2.Sp ...
- 超强、超详细Redis数据库入门教程(转载)
这篇文章主要介绍了超强.超详细Redis入门教程,本文详细介绍了Redis数据库各个方面的知识,需要的朋友可以参考下 [本教程目录] 1.redis是什么 2.redis的作者何许人也 3.谁在使 ...
- 详细分析MySQL事务日志(redo log和undo log)
innodb事务日志包括redo log和undo log.redo log是重做日志,提供前滚操作,undo log是回滚日志,提供回滚操作. undo log不是redo log的逆向过程,其实它 ...
- centos7安装zabbix3.0超详细步骤解析
centos7安装zabbix3.0超详细步骤解析 很详细,感谢作者 以下是我操作的history 622 java -version 623 javac -version 624 grep SELI ...
- 详细分析MySQL事务日志(redo log和undo log) 表明了为何mysql不会丢数据
innodb事务日志包括redo log和undo log.redo log是重做日志,提供前滚操作,undo log是回滚日志,提供回滚操作. undo log不是redo log的逆向过程,其实它 ...
- (转)Springboot日志配置(超详细,推荐)
Spring Boot-日志配置(超详细) 更新日志: 20170810 更新通过 application.yml传递参数到 logback 中. Spring Boot-日志配置超详细 默认日志 L ...
随机推荐
- 【Redis】持久化实现(RDB、AOF)
一.Redis RDB 持久化 1.RDB 工作原理 RDB(Redis Database)基于时间进行生成数据快照,默认只保留当前最新数据状态,优点时执行速度较快,但上次数据保存点到当前时间点之间的 ...
- Django-账号用户密码修改
Django账号密码修改命令: python manage.py changepassword python manage.py changepassword 实操分析: 第一次修改失败是因为违反了密 ...
- 解决:Invalid HTTP_HOST header: '192.168.56.1:8001'. You may need to add '192.168.56.1' to ALLOWED_HOSTS.
在setting.py下的ALLOWED_HOSTS=['*']添加'*'就可以解决显示不出来的问题.
- Django date
date根据给定格式对一个日期变量进行格式化. 可用的格式字符串: 格式化字符 描述 示例输出a 'a.m.'或'p.m.' 'a.m.'A 'AM'或'PM' 'AM'b 月份,文字形式,3个字母, ...
- SQL Server修改列的数据类型
ALTER TABLE LJPA001H DROP CONSTRAINT DF_LJPA001H_pa_sex_1 ALTER TABLE LJPA001H ALTER COLUMN pa_sex V ...
- 【HDU】1559 最大子矩阵 (二维前缀和,动态规划)
动态规划之二维前缀和 题目 给你一个m×n的整数矩阵,在上面找一个x×y的子矩阵,使子矩阵中所有元素的和最大. 输入 输入数据的第一行为一个正整数T,表示有T组测试数据.每一组测试数据的第一行为四个正 ...
- nginx发布vue 项目
在本次使用nginx发布vue项目遇到 配置location 始终404 和 在项目子目录点击浏览器刷新出现404问题 使用nginx发布vue项目,为了方便测试就下载了一个nginx 放置自己目录下 ...
- rest-framework 视图类源码分析
从miminx 类开始,依次有子类RetrieveModelMixin(单个get 请求)) ,ListModelMixin(LIST请求),CreateModelMixin(POST请求),Upda ...
- C温故补缺(十八):网络编程
计算机网络 参考:TCP三次握手详解. OSI模型 简单分层: 其中,链路层还可以分出物理层和数据链路层.应用层可以分出会话层,表示层和应用层. 七层模型: 链路层:只是物理的比特流和简单封装的数据帧 ...
- .Net Core后端架构实战【3-介入IOC控制反转】
摘要:基于.NET Core 7.0WebApi后端架构实战[2-介入IOC控制反转] 2023/04/09, ASP.NET Core 7.0, VS2022 引言 Inversion of Co ...