
机器学习-决策树系列-决策树-ID3算法 -C4.5算法-26
1. 决策树
决策树是属于有监督机器学习的一种,起源非常早,符合直觉并且非常直观,
模型生成:通过大量数据生成一颗非常好的树,用这棵树来预测新来的数据
预测:来一条新数据,按照生成好的树的标准,落到某一个叶子节点上
决策树的数学表达,递归 自己调用自己
决策树的生成本质
就是数据不断分裂的递归过程,每一次分裂,尽可能让类别一样的数据在树的一边,当树的叶子节点的数据都是一类的时候,则停止分裂。
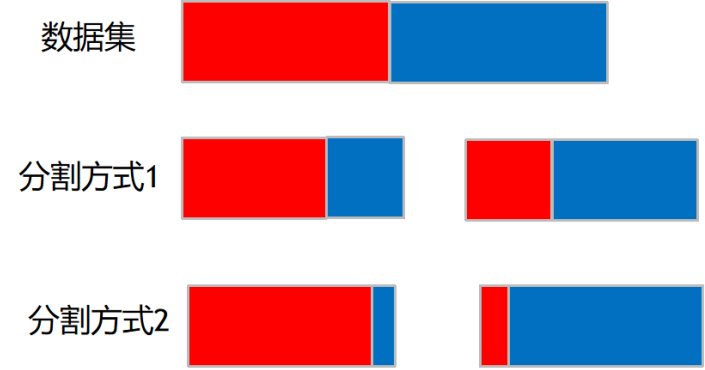
分裂好坏的评判的指标:基尼系数
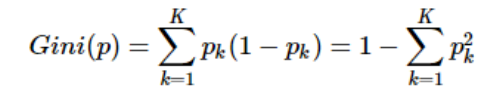
Gini系数越小,代表D集合中的数据越纯,所有我们可以计算分裂前的值
二分的场景:
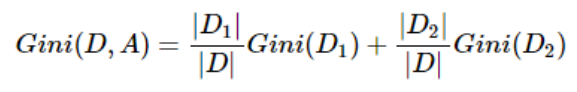
按照某个维度对数据集进行划分,然后可以去计算多个节点的Gini系数
分裂好坏的评判的指标:信息熵
在信息论里熵叫作信息量,即熵是对不确定性的度量。从控制论的角度来看,应叫不确定性。信息论的创始人香农在其著作《通信的数学理论》中提出了建立在概率统计模型上的信息度量。他把信息定义为“用来消除不确定性的东西”。在信息世界,熵越高,则能传输越多的信息,熵越低,则意味着传输的信息越少。
举例说明,假设Kathy在买衣服的时候有颜色,尺寸,款式以及设计年份四种要求,而North只有颜色和尺寸的要求,那么在购买衣服这个层面上Kathy由于选择更多因而不确定性因素更大,最终Kathy所获取的信息更多,也就是熵更大。所以信息量=熵=不确定性,通俗易懂。在叙述决策树时我们用熵表示不纯度(Impurity)。
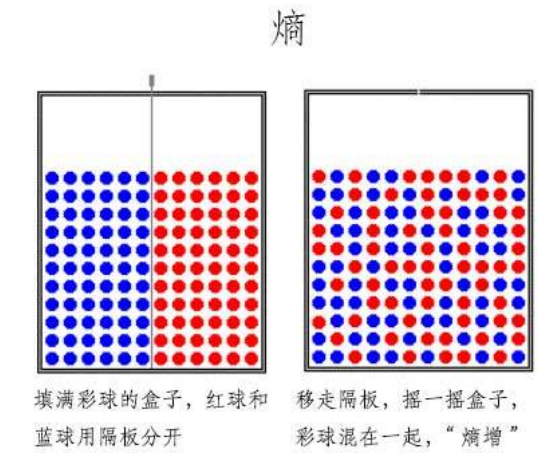
生命的本质在于 抵抗熵增
打扫房间:让你周围的世界变得有序
吃饭:让你体内的分子变得有序 那可不可以这样认为食物里面的熵更低 -->食物里面的更低的熵(更有序的分子排列)是谁实现的 从哪里来的?-->植物的光合作用 -->分子的有序排列是需要消耗能量的
有序 到 无序的过程 能量的耗散过程
无序 到 有序 需要吸收能量 才能实现
息论中熵的概念,熵度量了事物的不确定性,越不确定的事物,它的熵就越大。具体的,随机变量X的熵的表达式如下:

举个例子,比如X有2个可能的取值,而这两个取值各为1/2时X的熵最大,此时X具有最大的不确定性: ,
如果一个值概率大于1/2,另一个值概率小于1/2,则不确定性减少,对应的熵也会减少。比如一个概率1/3,一个概率2/3,则对应熵为: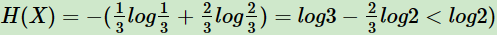
2. 举个例子 计算信息增益
信息增益:分裂前的信息熵 减去 分裂后的信息熵一个分裂导致的信息增益越大,代表这次分裂提升的纯度越高
分裂前的 减去分裂后的。

根节点 没有分裂的时候:

根据性别 分叉

性别这个维度分叉得到的信息增益:
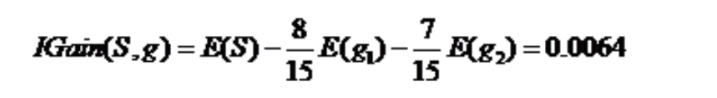
根据活跃度 分裂:
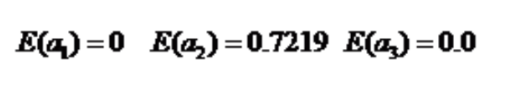
对应的信息增益:
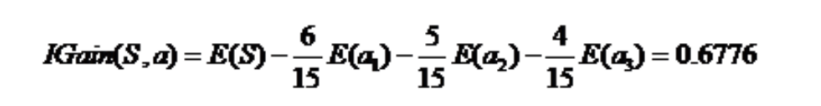
因此, 根据活跃度 来分叉 是更优的
信息熵与Gini指数关系
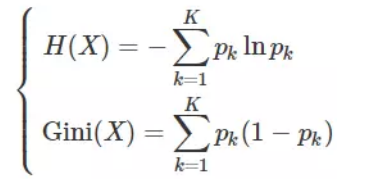
将 f(x) = −lnx 在 x = 1 处进行一阶泰勒展开
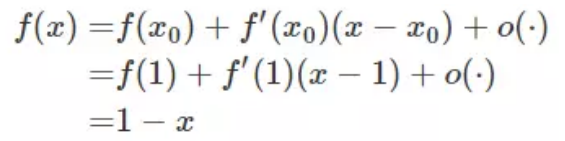

计算信息熵涉及log计算 效率会慢很多 因此很多时候是用gini系数去计算
以上方法叫做 决策树ID3 其缺点:
ID3采用信息增益大的特征优先建立决策树的节点。很快就被人发现,在相同条件下,取值比较多的特征比取值少的特征信息增益大。比如一个变量有2个值,各为1/2,另一个变量为3个值,各为1/3,其实他们都是完全不确定的变量,但是取3个值的比取2个值的信息增益大。如何校正这个问题呢?没有考虑过拟合的问题
ID3 算法的作者昆兰基于上述不足,对ID3算法做了改进,这就是C4.5算法
3. C4.5算法
ID3不足:一是不能处理连续特征,第二个就是用信息增益作为标准容易偏向于取值较多的特征,最后两个是缺失值处理的问和过拟合问题
息增益作为标准容易偏向于取值较多的特征的问题。我们引入一个信息增益比的变量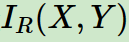
信息增益和特征熵的比值:
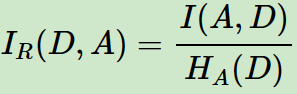
特征熵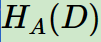 :

特征数越多的特征对应的特征熵越大,它作为分母,得到的信息增益比就会更小,校正信息增益容易偏向于取值较多的特征的问题。
C4.5虽然改进或者改善了ID3算法的几个主要的问题,仍然有优化的空间。
由于决策树算法非常容易过拟合,对于生成的决策树必须要进行剪枝。剪枝的算法有非常多,C4.5的剪枝方法有优化的空间。一种是预剪枝,另一个是后剪枝,即先生成决策树,再通过交叉验证来剪枝
C4.5由于使用了熵模型,里面有大量的耗时的对数运算,如果是连续值还有大量的排序运算。
在CART树里面加以了改进,在普通的决策树算法里,CART算法算是比较优的算法了。
机器学习-决策树系列-决策树-ID3算法 -C4.5算法-26的更多相关文章
- 机器学习总结(八)决策树ID3,C4.5算法,CART算法
本文主要总结决策树中的ID3,C4.5和CART算法,各种算法的特点,并对比了各种算法的不同点. 决策树:是一种基本的分类和回归方法.在分类问题中,是基于特征对实例进行分类.既可以认为是if-then ...
- 《机器学习实战》学习笔记第三章 —— 决策树之ID3、C4.5算法
主要内容: 一.决策树模型 二.信息与熵 三.信息增益与ID3算法 四.信息增益比与C4.5算法 五.决策树的剪枝 一.决策树模型 1.所谓决策树,就是根据实例的特征对实例进行划分的树形结构.其中有两 ...
- 小啃机器学习(1)-----ID3和C4.5决策树
第一部分:简介 ID3和C4.5算法都是被Quinlan提出的,用于分类模型,也被叫做决策树.我们给一组数据,每一行数据都含有相同的结构,包含了一系列的attribute/value对. 其中一个属性 ...
- 机器学习之决策树(ID3 、C4.5算法)
声明:本篇博文是学习<机器学习实战>一书的方式路程,系原创,若转载请标明来源. 1 决策树的基础概念 决策树分为分类树和回归树两种,分类树对离散变量做决策树 ,回归树对连续变量做决策树.决 ...
- 决策树:ID3与C4.5算法
1.基本概念 1)定义: 决策树是一个预测模型:他代表的是对象属性与对象值之间的一种映射关系,树中每个节点代表的某个可能的属性值. 2)表示方法: 通过把实例从根结点排列到某个叶子结点来分类实例,叶子 ...
- 决策树系列(四)——C4.5
预备知识:决策树.ID3 如上一篇文章所述,ID3方法主要有几个缺点:一是采用信息增益进行数据分裂,准确性不如信息增益率:二是不能对连续数据进行处理,只能通过连续数据离散化进行处理:三是没有采用剪枝的 ...
- 机器学习Sklearn系列:(五)聚类算法
K-means 原理 首先随机选择k个初始点作为质心 1. 对每一个样本点,计算得到距离其最近的质心,将其类别标记为该质心对应的类别 2. 使用归类好的样本点,重新计算K个类别的质心 3. 重复上述过 ...
- 数据挖掘领域经典分类算法 —— C4.5算法(附python实现代码)
目录 理论介绍 什么是分类 分类的步骤 什么是决策树 决策树归纳 信息增益 相关理论基础 计算公式 ID3 C4.5 python实现 参考资料 理论介绍 什么是分类 分类属于机器学习中监督学习的一种 ...
- 决策树之ID3、C4.5
决策树是一种类似于流程图的树结构,其中,每个内部节点(非树叶节点)表示一个属性上的测试,每个分枝代表该测试的一个输出,而每个树叶节点(或终端节点存放一个类标号).树的最顶层节点是根节点.下图是一个典型 ...
- 决策树(ID3、C4.5、CART)
ID3决策树 ID3决策树分类的根据是样本集分类前后的信息增益. 假设我们有一个样本集,里面每个样本都有自己的分类结果. 而信息熵可以理解为:“样本集中分类结果的平均不确定性”,俗称信息的纯度. 即熵 ...
随机推荐
- JWT简单使用
创建一个Maven项目,并导入jar包 <?xml version="1.0" encoding="UTF-8"?> <project xml ...
- Cloudeye对接Prometheus实现华为云全方位监控
本文分享自华为云社区<Cloudeye对接Prometheus实现华为云全方位监控>,作者:可以交个朋友 . 一. 背景 云眼系统Cloudeye服务为我们提供了针对弹性云服务器.宽带等资 ...
- 使用dtd定义元素
- k8s~动态生成pvc和pv
有时,我们不想手动建立pv和pvc,这时,我们可以通过strongClass存储类来帮我们实现,动态建立pvc,并动态为它分配pv存储空间,我们以nfs为例,说一下动态分配在nfs存储截至上建立pv的 ...
- K8s和声明式编程
转载:原文链接 认识k8s之后,他的操作模式对我来说是一种很不错的体验.他提供了更接近现实世界的面向对象接口. 什么是k8s? Kubernetes(K8s)是一种开源容器编排平台,用于自动化部署.扩 ...
- docker: 'buildx' is not a docker command
解决方法 sudo apt install docker-buildx-plugin
- nginx在代理到upstream时转换http1.1为http1.0,长连接转为短连接
nginx在代理到upstream时的默认行为 最近准备用openresty替换nginx,替换的效果当然是需要保证效果和nginx一致,不然可能就会导致线上在用的服务出现问题. 替换成openres ...
- 记录:excel导入导出js-xlsx,处理合并
效果 前情提要 后端传excel坐标数据,前端自己处理模板,找资料后,选择直接载入xlsx方式. 准备工作 npm i xlsx import * as XLSX from 'xlsx' 方法一:数据 ...
- 【华为云技术分享】解密如何使用昇腾AI计算解决方案构建业务引擎
摘要:昇腾AI计算解决方案以极致算力,端边云融合.全栈创新,开放生态的硬核实力.用户可以使用标准的Matrix接口实现业务引擎,对外释放昇腾AI加速能力. 从卷积神经网络中的矩阵乘法(GEMM)说起 ...
- 云图说|ModelArts Pro,为企业级AI应用打造的专业开发套件
摘要: ModelArts Pro 为企业级AI应用打造专业开发套件.基于华为云的先进算法和快速训练能力,提供预置工作流和模型,提升企业AI应用的开发效率,降低开发难度. AI技术的高门槛与落地难是中 ...