
骚操作!曾经爱过!用 Python 清理收藏夹里已失效的网站
前言
本文的文字及图片来源于网络,仅供学习、交流使用,不具有任何商业用途,版权归原作者所有,如有问题请及时联系我们以作处理。
作者: 小詹&有乔木
PS:如有需要Python学习资料的小伙伴可以加点击下方链接自行获取
http://note.youdao.com/noteshare?id=3054cce4add8a909e784ad934f956cef
失效的书签们
我们日常浏览网站的时候,时不时会遇到些新奇的东西( 你懂的.jpg ),于是我们就默默的点了个收藏或者加书签。然而当我们面对成百上千的书签和收藏夹的时候,总会头疼不已…… 
尤其是昨天还在更新的程序设计博客,今天就挂了永不更新。或者是昨天看的起劲的电影网站,今天直接404。失效页面这么多,每次我打开才知道失效了,并且需要手动删除,这能是一个程序员干的事情吗?
可是无论是Google浏览器还是国内浏览器,最多也就提供一个对于收藏夹的备份服务,那只能Python走起了。
Python支持的收藏夹文件格式
对于收藏夹提供的支持很少,主要还是因为收藏夹藏在浏览器里面,我们只能手动导出htm文件进行管理

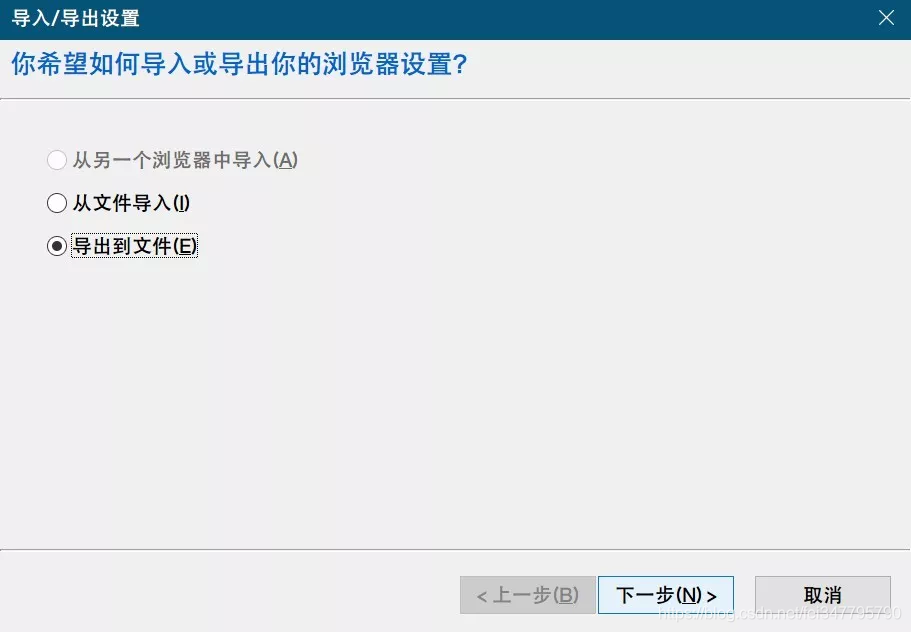
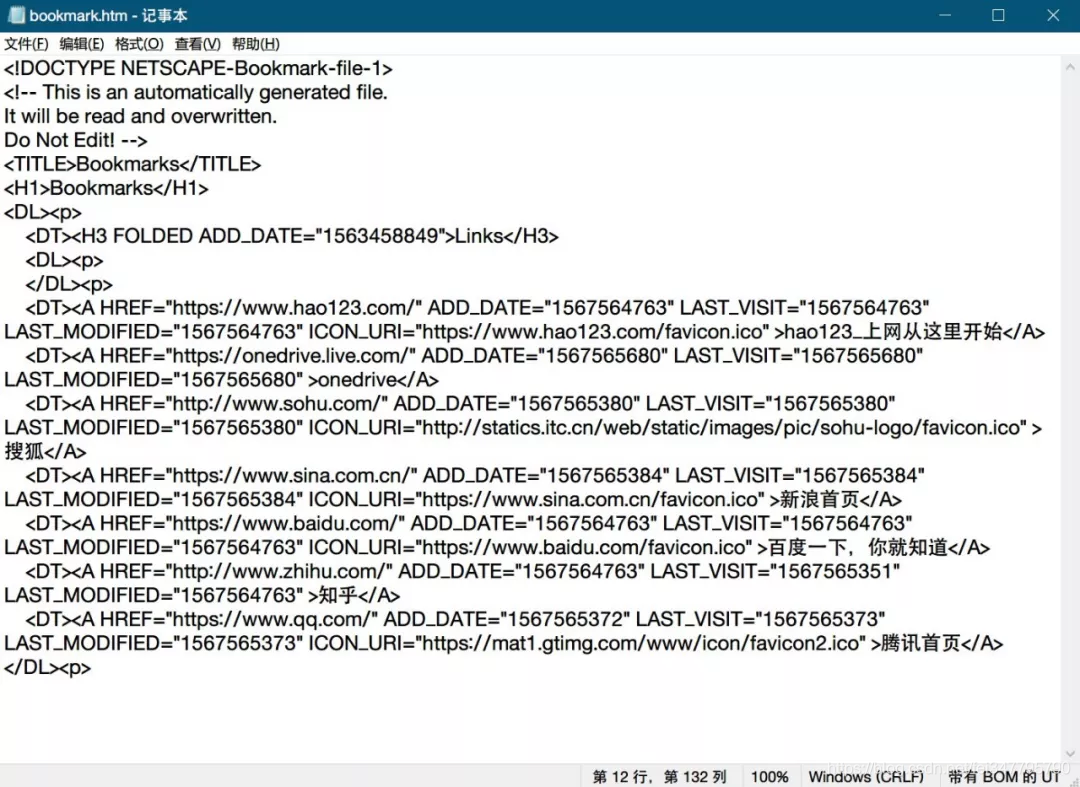
内容比较简单,对前端没什么了解的我,也可以很明显看出其中的树形结构和内在逻辑。 固定格式 网址 固定格式 页面名 固定格式
很简单的想到了正则匹配,其中有两个子串。提取出来再挨个访问,看看哪个失效了,就删除,就能获得清理后的收藏夹了。
读取收藏夹文件
path = "C:\\Users\\XU\\Desktop"
fname = "bookmarks.html"
os.chdir(path)
bookmarks_f = open(fname, "r+" ,encoding='UTF-8')
booklists = bookmarks_f.readlines()
bookmarks_f.close()
因为对于前端的不熟悉,这个导出的收藏夹可以抽象的分
结构代码
保存网页书签的关键代码
其中结构代码我们不能动,要原封不动的保留,而保存网页书签的关键代码,我们要提取内容并且进行判断保留和删除。
所以这里采用readlines函数,每行读取,单独判断。
正则匹配
 pattern = r'HREF="(.*?)" .*?>(.*?)</A>'

 while len(booklists)>0:

     bookmark = booklists.pop(0)

     detail = re.search(pattern, bookmark)
如果是关键代码:提取出的子串在 detail.group(1) 和 detail.group(2) 里面
而如果是结构代码:detail == None
访问页面
 import requests

 r = requests.get(detail.group(1),timeout=500)
编代码尝试之后发现会有这四种情况
r.status_code == requests.codes.ok
r.status_code==404
r.status_code!=404 && 无法访问 (可能是屏蔽爬虫,建议保留)
requests.exceptions.ConnectionError
类似知乎、简书基本都反爬了,所以简单的get还不能有效访问,细节不值得大费周章,直接保留就好。而error,直接用try抛出异常就好,不然程序会停止运行。
添加逻辑后:(代码可左右拖动)
 while len(booklists)>0:

     bookmark = booklists.pop(0)

     detail = re.search(pattern, bookmark)

     if detail:

         #print(detail.group(1) +"----"+ detail.group(2))

         try:

         #访问

             r = requests.get(detail.group(1),timeout=500)

         #如果可则添加

             if  r.status_code == requests.codes.ok:

                 new_lists.append(bookmark)

                 print( "ok------ 保留:"+ detail.group(1)+"   "+ detail.group(2))

             else:

                 if(r.status_code==404):

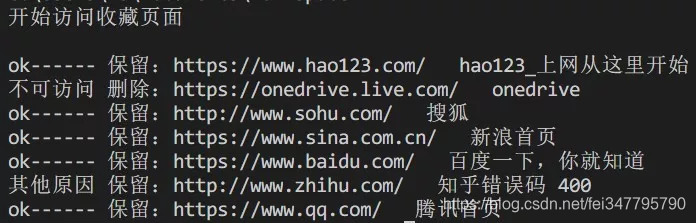
                     print("不可访问 删除:"+ detail.group(1)+"   "+ detail.group(2) +'错误码 '+str(r.status_code))

                 else:

                     print("其他原因 保留:"+ detail.group(1)+"   "+ detail.group(2) +'错误码 '+str(r.status_code))

                     new_lists.append(bookmark)

         except:

             print( "不可访问 删除:"+ detail.group(1)+"   "+ detail.group(2))

             #new_lists.append(bookmark)

     else:#没匹配到是结构语句

         new_lists.append(bookmark)
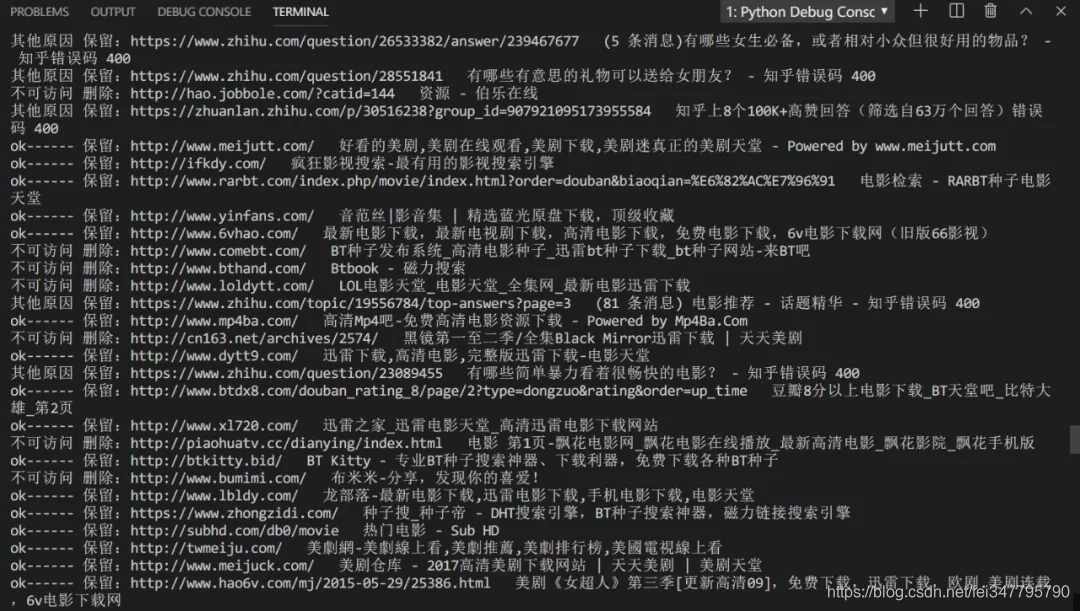
程序执行情况
导出htm
 bookmarks_f = open('new_'+fname, "w+" ,encoding='UTF-8')

 bookmarks_f.writelines(new_lists)

 bookmarks_f.close()
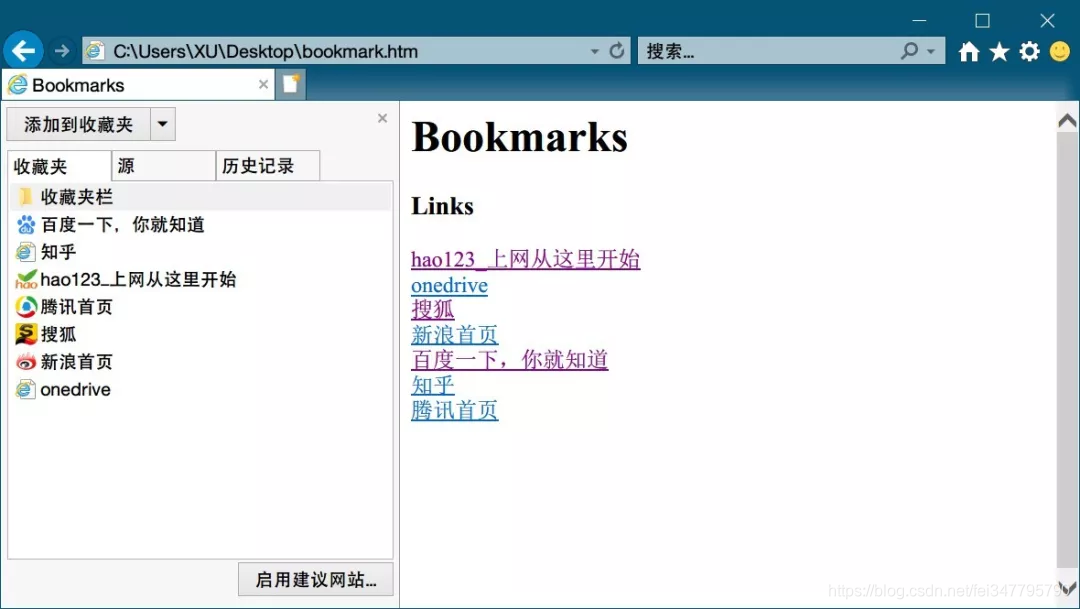
导入浏览器
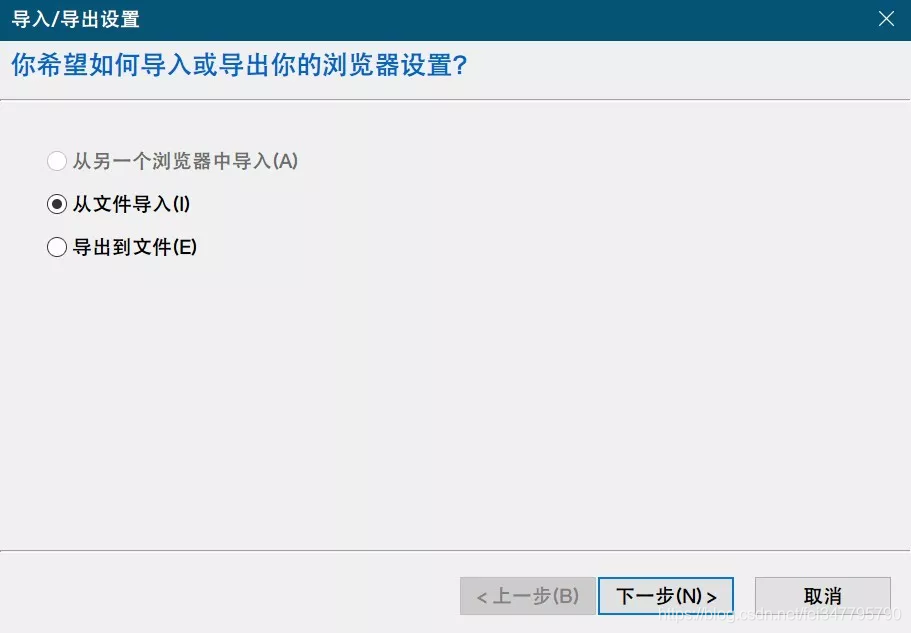
实际应用于我的浏览器
。
骚操作!曾经爱过!用 Python 清理收藏夹里已失效的网站的更多相关文章
- 清理收藏夹中的json
1.json的字符串与对象转换 $.parseJson(str)与JSON.parse(str) 返回值是true.另:json对象和字符串的相互转换 JSON.stringify(obj) 将JSO ...
- SQL优化:清理生产环境中已失效字段基本步骤
1.统计相应字段的数据情况(如:几年没更新,无数据等情况) 2.确认产品逻辑已无效(产品经理邮件确认) 3.数据备份 4.将数据清空(置为0或空) 5.测试环境中删除引用页面 6.修改定时程序,存储过 ...
- 清理收藏夹中的CSS
1.去掉元素的属性, 例如宽度 #blog-calendar { width: initial !important; }
- python 计算文件夹里所有内容的大小总和
计算文件夹里所有内容的大小总和 递归方法 '''计算文件夹的大小''' import os def dir_file_size(path): if os.path.isdir(path): file_ ...
- python骚操作---Print函数用法
---恢复内容开始--- python骚操作---Print函数用法 在 Python 中,print 可以打印所有变量数据,包括自定义类型. 在 3.x 中是个内置函数,并且拥有更丰富的功能. 参数 ...
- Python小白需要知道的 20 个骚操作!
Python小白需要知道的 20 个骚操作! Python 是一个解释型语言,可读性与易用性让它越来越热门.正如 Python 之禅中所述: 优美胜于丑陋,明了胜于晦涩. 在你的日常编码中,以下技巧可 ...
- Python中对 文件 的各种骚操作
Python中对 文件 的各种骚操作 python中对文件.文件夹(文件操作函数)的操作需要涉及到os模块和shutil模块. 得到当前工作目录,即当前Python脚本工作的目录路径: os.getc ...
- Python骚操作从列表推导和生成器表达式开始
序列 序列是指一组数据,按存放类型分为容器序列与扁平序列,按能否被修改分为不可变序列与可变序列. 容器序列与扁平序列 容器序列存放的是对象的引用,包括list.tuple.collections.de ...
- python带你采集不可言说网站数据,并带你多重骚操作~
前言 嗨喽,大佬们好鸭!这里是小熊猫~ 今天我们采集国内知名的shipin弹幕网站! 这里有及时的动漫新番,活跃的ACG氛围,有创意的Up主. 大家可以在这里找到许多欢乐. 目录(可根据个人情况点击你 ...
随机推荐
- PalletOne调色板跨链的BTC实现
之前已经讲到了PalletOne调色板跨链以太坊ETH和ERC20的技术原理,接下来我们来讲解PalletOne跨链比特币BTC的技术原理. 一.BTC充币 假如用户A持有一定数量的比特币BTC,他希 ...
- netcore3.0配置跨域
netcore3.0框架已集成了Microsoft.AspNetCore.Mvc.Cors包,因此不需要单独引用. 在ConfigureServices中添加Cors策略服务 services.Add ...
- es6 之class介绍
class ECMAScript 2015 中引入的 JavaScript 类实质上是 JavaScript 现有的基于原型的继承的语法糖.类语法不会为JavaScript引入新的面向对象的继承模型. ...
- Dynamics 365 Online-Delete Audit History Data
Dynamics 365 CE自带的Audit功能,虽然不会给我们的业务流程带来显著变化,但是这个功能对于我们追溯数据变化的历史,诊断定制触发的执行,以及数据还原等,都是不可或缺的关键先生.尤其是涉及 ...
- hadoop免登录
参考:http://wenku.baidu.com/link?url=n4PT7AhGnV7N8KevSEAMcCVGEaYqTuKmNodCQsUnR7qtAnWM0WDs8pFYLOpCUu9R9 ...
- How To Determine The Cause Of Lots Of Redo Generation Using LogMiner (Doc ID 300395.1)
How To Determine The Cause Of Lots Of Redo Generation Using LogMiner (Doc ID 300395.1) APPLIES TO: O ...
- 如何快速查看 group 对应的id
最近需要获取group 对应的id 数字号码,突然想不起来怎么获得了,现在在这里进行备忘一下: $ cut -d: -f3 < <(getent group sudo) getent gr ...
- MVC(基础一)
MVC学习之前必须掌握的c#基础知识 一.类自动属性 public class Person { //自动属性 public string Name { get; set; } private int ...
- PAT甲级|1151 LCA in a Binary Tree 先序中序遍历建树 lca
给定先序中序遍历的序列,可以确定一颗唯一的树 先序遍历第一个遍历到的是根,中序遍历确定左右子树 查结点a和结点b的最近公共祖先,简单lca思路: 1.如果a和b分别在当前根的左右子树,当前的根就是最近 ...
- c++用流控制成员函数输出数据
#include<iostream> #include<iomanip> using namespace std; int main() { ; double b=314159 ...