
机器学习中的误差 Where does error come from?
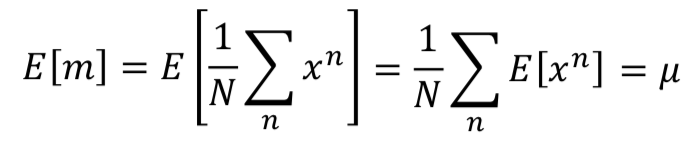 ,所以对随机变量 X 的均值的估计是无偏的。
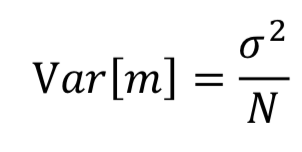
接下来,如何构造 σ2 的 estimator?=> 按照定义应该是对 s2 求期望:
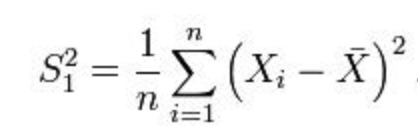
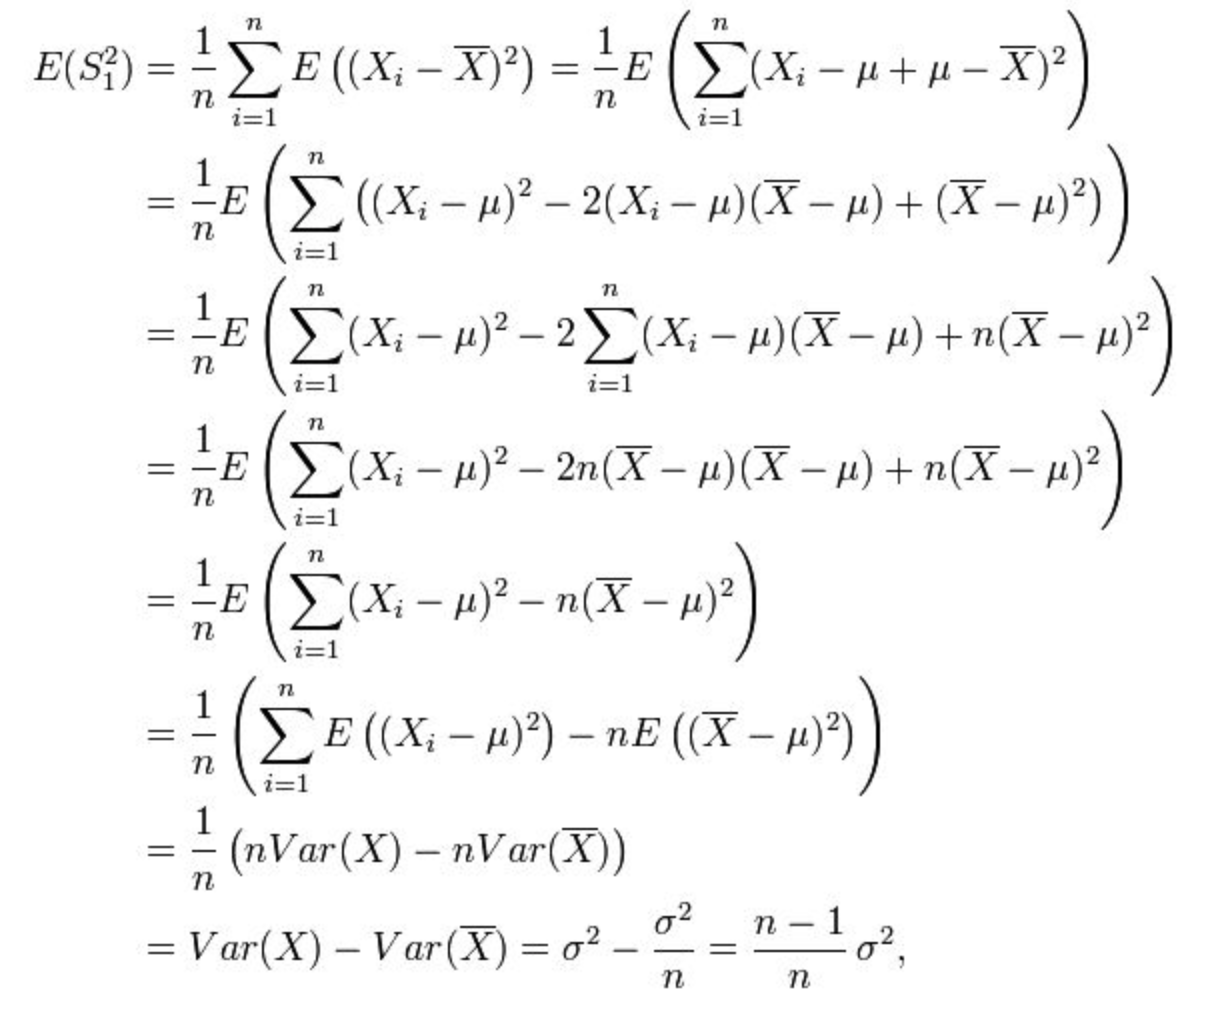
可以发现这个估计是有偏的,修正:
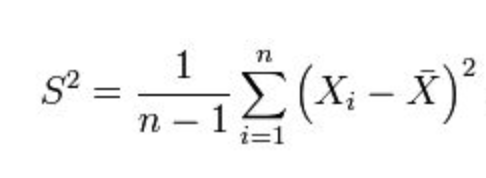
回到机器学习的误差问题上,以 linear regression 为例:
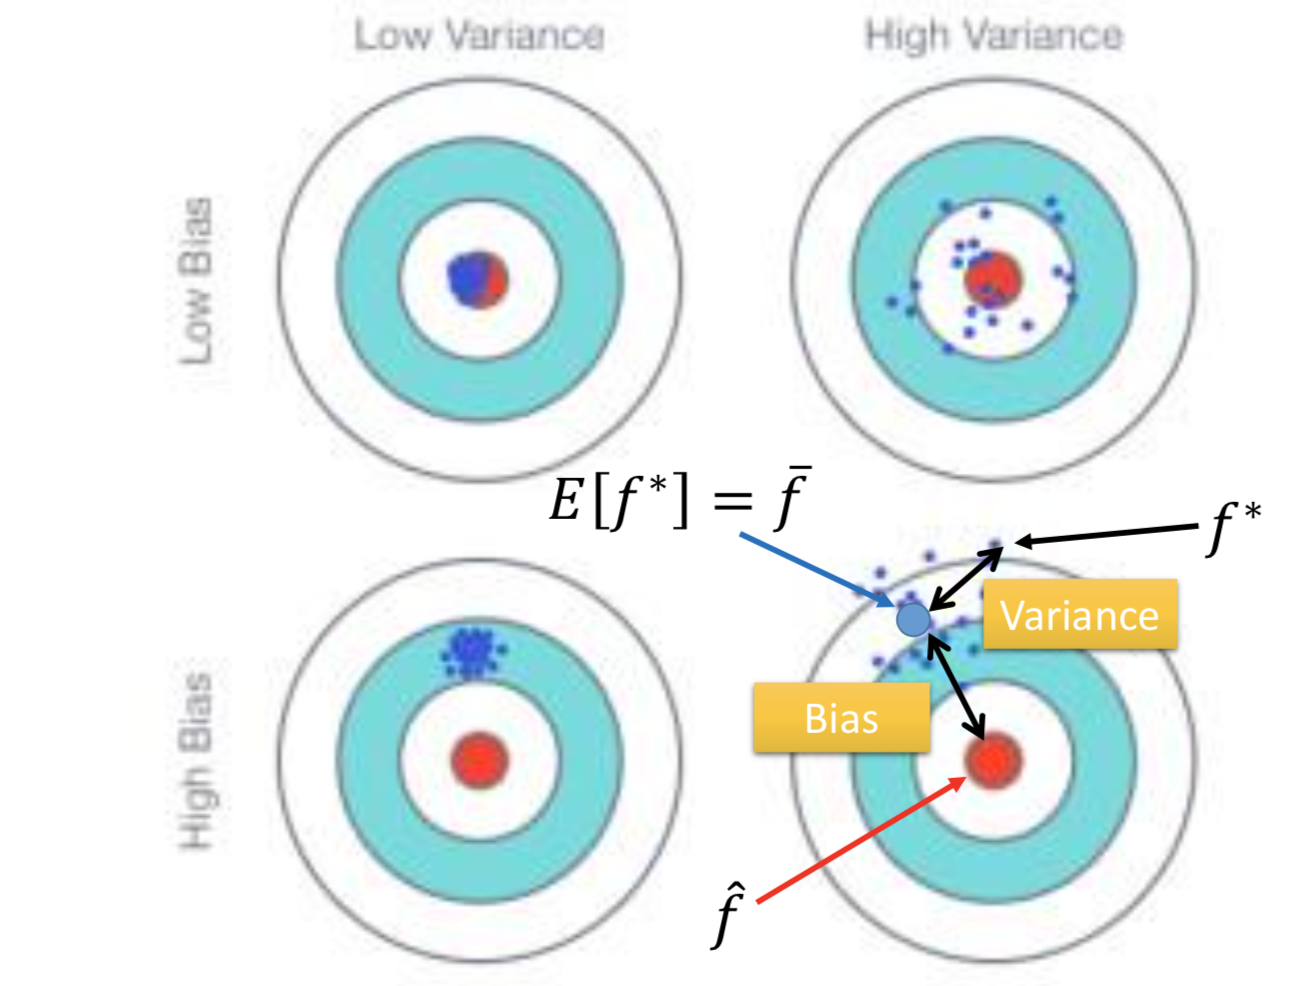
同一个模型,怎么找很多个 f* 呢?——做很多次实验就好了。

underfitting: Large bias, Small variance
overfitting: Large variance, Small bias
机器学习中的误差 Where does error come from?的更多相关文章
- 机器学习中的Bias(偏差),Error(误差),和Variance(方差)有什么区别和联系?
前几天搜狗的一道笔试题,大意是在随机森林上增加一棵树,variance和bias如何变化呢? 参考知乎上的讨论:https://www.zhihu.com/question/27068705 另外可参 ...
- paper 126:[转载] 机器学习中的范数规则化之(一)L0、L1与L2范数
机器学习中的范数规则化之(一)L0.L1与L2范数 zouxy09@qq.com http://blog.csdn.net/zouxy09 今天我们聊聊机器学习中出现的非常频繁的问题:过拟合与规则化. ...
- 机器学习中的范数规则化之(一)L0、L1与L2范数(转)
http://blog.csdn.net/zouxy09/article/details/24971995 机器学习中的范数规则化之(一)L0.L1与L2范数 zouxy09@qq.com http: ...
- 机器学习中的范数规则化之(一)L0、L1与L2范数 非常好,必看
机器学习中的范数规则化之(一)L0.L1与L2范数 zouxy09@qq.com http://blog.csdn.net/zouxy09 今天我们聊聊机器学习中出现的非常频繁的问题:过拟合与规则化. ...
- 机器学习中的K-means算法的python实现
<机器学习实战>kMeans算法(K均值聚类算法) 机器学习中有两类的大问题,一个是分类,一个是聚类.分类是根据一些给定的已知类别标号的样本,训练某种学习机器,使它能够对未知类别的样本进行 ...
- 机器学习中的范数规则化-L0,L1和L2范式(转载)
机器学习中的范数规则化之(一)L0.L1与L2范数 zouxy09@qq.com http://blog.csdn.net/zouxy09 今天我们聊聊机器学习中出现的非常频繁的问题:过拟合与规则化. ...
- 机器学习中模型泛化能力和过拟合现象(overfitting)的矛盾、以及其主要缓解方法正则化技术原理初探
1. 偏差与方差 - 机器学习算法泛化性能分析 在一个项目中,我们通过设计和训练得到了一个model,该model的泛化可能很好,也可能不尽如人意,其背后的决定因素是什么呢?或者说我们可以从哪些方面去 ...
- 偏差(Bias)和方差(Variance)——机器学习中的模型选择zz
模型性能的度量 在监督学习中,已知样本 ,要求拟合出一个模型(函数),其预测值与样本实际值的误差最小. 考虑到样本数据其实是采样,并不是真实值本身,假设真实模型(函数)是,则采样值,其中代表噪音,其均 ...
- 机器学习中的规则化范数(L0, L1, L2, 核范数)
目录: 一.L0,L1范数 二.L2范数 三.核范数 今天我们聊聊机器学习中出现的非常频繁的问题:过拟合与规则化.我们先简单的来理解下常用的L0.L1.L2和核范数规则化.最后聊下规则化项参数的选择问 ...
随机推荐
- vue中修改子组件样式
一.问题叙述 项目里需要新添加一个表单页面,里面就只是几个select,这个几个select是原本封装好的组件,有自己原本的样式,而这次的原型图却没有和之前的样式统一起来,需要微调一下,这里就涉及到父 ...
- SpringMVC——MVC
一.了解MVC mvc这种设计模式,分为三个基本部分:模型(Model).视图(View)和控制器(Controller),不光运用于Web领域,而且也能用于非Web领域:可以特指一种表现层设计模式, ...
- c++学习书籍推荐《Visual C++2008入门经典》下载
百度云及其他网盘下载地址:点我 <Visual C++2008入门经典>学习目标: 使用标准模板库(STL)来组织和操作本地C++程序中的数据 C++程序调试技术 构造Microsoft ...
- 开源SFTP客户端 WinSCP v5.13.5 Build 8967 绿色便携版
下载地址:点我 基本介绍 WinSCP 是一款可以在微软 Windows 系统环境下使用的支持 SSH 命令的开源图形化 SFTP 客户端工具.同时也支持 SCP 文件传输协议,它的主要功能是在本地与 ...
- 20140117-配置文件为什么放在UI层
配置文件为什么放在UI层 (刚才写着代码突然忘了配置文件为什么要放在UI层了,只记得晓虎老师强调过.找了半天视频……) 现总结一下: 晓虎老师给出的理由,大体如下:比如一个web项目,分成三层,DAL ...
- MyBatis 接口多参数的处理方法
From<MyBatis从入门到精通> 1.接口类中增加的方法: /* 2.7 多个接口参数的用法 多个参数时,可以选取的方案有:使用Map类型或者使用@Param注解 使用Map类型作为 ...
- java中this 和 super关键字的作用
emmmmmm也真的是好久没有写过java了,因为项目需要, 最近又必须重新拾起来了,虽然好多东西也都忘得差不多了.... 然后发现 竟然把super和this傻傻分不清.... 开个帖子记录一下: ...
- C#2.0增功能04 可以为 null 的类型
连载目录 [已更新最新开发文章,点击查看详细] 可以为 null 的类型是 System.Nullable<T> 结构的实例. 可以为 null 的类型可表示一个基础类型的所有值 T ...
- python注释-输入输出-基本数据类型-运算符
python注释 用处:注释用来书写一些解释性信息,对代码的逻辑作用等作出描述 单行注释.多行注释 # 这是行注释,注释内容与# 之间要空一格 print("hello world!&quo ...
- 【MySQL】(三)文件
本篇文章分析构成MySQL数据库和InnoDB存储引擎表的各种累类型文件.这些文件有以下这些. 参数文件:告诉MySQL实例启动时在哪里可以找到数据库文件,并且指定某些初始化参数,这些参数定义了某种内 ...