
python requests、xpath爬虫增加博客访问量
这是一个分析IP代理网站,通过代理网站提供的ip去访问CSDN博客,达到以不同ip访同一博客的目的,以娱乐为主,大家可以去玩一下。
首先,准备工作,设置User-Agent:
#1.headers

headers={'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:68.0) Gecko/20100101 Firefox/68.0'}
然后百度一个IP代理网站,我选用的是https://www.kuaidaili.com/free,解析网页,提取其中的ip、端口、类型,并以list保存:
#1.获取IP地址

html=requests.get('https://www.kuaidaili.com/free').content.decode('utf8')

tree = etree.HTML(html)

ip = tree.xpath("//td[@data-title='IP']/text()")

port=tree.xpath("//td[@data-title='PORT']/text()")

model=tree.xpath("//td[@data-title='类型']/text()")
接着分析个人博客下的各篇文章的url地址,以list保存
#2.获取CSDN文章url地址   ChildrenUrl[]

url='https://blog.csdn.net/weixin_43576564'

response=requests.get(url,headers=headers)

Home=response.content.decode('utf8')

Home=etree.HTML(Home)

urls=Home.xpath("//div[@class='article-item-box csdn-tracking-statistics']/h4/a/@href")

ChildrenUrl=[]
然后通过代理ip去访问个人博客的各篇文章,通过for循环,一个ip将所有文章访问一遍,通过解析"我的博客"网页,获取总浏览量,实时监控浏览量是否发生变化,设置任务数,实时显示任务进度,通过random.randint()设置sleep时间,使得spider更加安全。全代码如下:
import os

import time

import random

import requests

from lxml import etree

#准备部分

#1.headers

headers={'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64; rv:68.0) Gecko/20100101 Firefox/68.0'}

#1.获取IP地址

html=requests.get('https://www.kuaidaili.com/free').content.decode('utf8')

tree = etree.HTML(html)

ip = tree.xpath("//td[@data-title='IP']/text()")

port=tree.xpath("//td[@data-title='PORT']/text()")

model=tree.xpath("//td[@data-title='类型']/text()")

#2.获取CSDN文章url地址   ChildrenUrl[]

url='https://blog.csdn.net/weixin_43576564'

response=requests.get(url,headers=headers)

Home=response.content.decode('utf8')

Home=etree.HTML(Home)

urls=Home.xpath("//div[@class='article-item-box csdn-tracking-statistics']/h4/a/@href")

ChildrenUrl=[]

for i in range(1,len(urls)):

    ChildrenUrl.append(urls[i])

oldtime=time.gmtime()

browses=int(input("输入需要访问次数:"))

browse=0

#3.循环伪装ip并爬取文章

for i in range(1,len(model)):

    #设计代理ip

    proxies={model[i]:'{}{}'.format(ip[i],port[i])}

    for Curl in ChildrenUrl:

        try:

            browse += 1

            print("进度:{}/{}".format(browse,browses),end="\t")

            #遍历文章

            response=requests.get(Curl,headers=headers,proxies=proxies)

            #获取访问人数

            look=etree.HTML(response.content)

            Nuwmunber=look.xpath("//div[@class='grade-box clearfix']/dl[2]/dd/text()")

            count=Nuwmunber[0].strip()

            print("总浏览量:{}".format(count),end="\t")

            '''

            重新实现

            #每个IP进行一次查询

            if Curl==ChildrenUrl[5]:

                ipUrl='http://www.ip138.com/'

                response=requests.get(ipUrl,proxies=proxies)

                iphtml=response.content

                ipHtmlTree=etree.HTML(iphtml)

                ipaddress=ipHtmlTree.xpath("//p[@class='result']/text()")

                print(ip[i],ipaddress)

            '''

            i = random.randint(5, 30)

            print("间隔{}秒".format(i),end="\t")

            time.sleep(i)

            print("当前浏览文章地址:{}".format(Curl))

            if browse == browses:

                print("已完成爬取任务,共消耗{}秒".format(int(time.perf_counter())))

                os._exit(0)

        except:

            print('error')

            os._exit(0)

    #打印当前代理ip

    print(proxies)
实际运行效果图: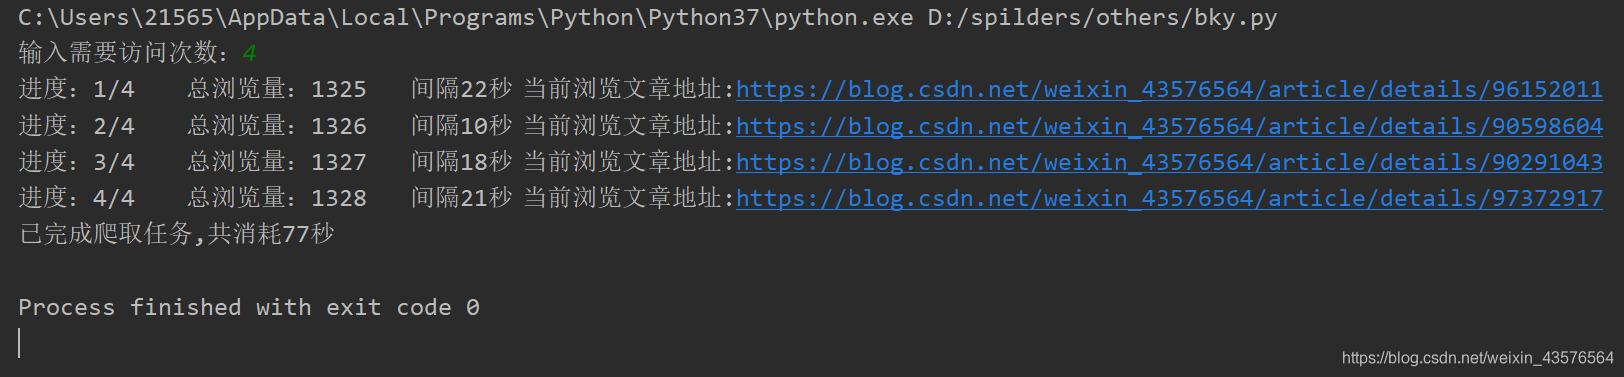
python requests、xpath爬虫增加博客访问量的更多相关文章
- Python爬虫小实践:爬取任意CSDN博客所有文章的文字内容(或可改写为保存其他的元素),间接增加博客访问量
Python并不是我的主业,当初学Python主要是为了学爬虫,以为自己觉得能够从网上爬东西是一件非常神奇又是一件非常有用的事情,因为我们可以获取一些方面的数据或者其他的东西,反正各有用处. 这两天闲 ...
- python之刷博客访问量
通过写刷访问量学习正则匹配 说明信息 说明:仅仅是为了熟悉正则表达式以及网页结构,并不赞成刷访问量操作. 1.刷访问量第一版 1.1 确定网页url结构,构造匹配模式串 首先是要确定刷的网页.第一版实 ...
- python编写的自动获取代理IP列表的爬虫-chinaboywg-ChinaUnix博客
python编写的自动获取代理IP列表的爬虫-chinaboywg-ChinaUnix博客 undefined Python多线程抓取代理服务器 | Linux运维笔记 undefined java如 ...
- 用Python和Django实现多用户博客系统(二)——UUBlog
这次又更新了一大部分功能,这次以app的形式来开发. 增加博客分类功能:博客关注.推荐功能(ajax实现) 增加二级频道功能 更多功能看截图及源码,现在还不完善,大家先将就着看.如果大家有哪些功能觉的 ...
- Orchard官方文档翻译(八) 为站点增加博客
原文地址:http://docs.orchardproject.net/Documentation/Adding-a-blog-to-your-site 想要查看文档目录请用力点击这里 最近想要学习了 ...
- 这几天有django和python做了一个多用户博客系统(可选择模板)
这几天有django和python做了一个多用户博客系统(可选择模板) 没完成,先分享下 断断续续2周时间吧,用django做了一个多用户博客系统,现在还没有做完,做分享下,以后等完善了再慢慢说 做的 ...
- python环境变量配置 - CSDN博客
一.下载: 1.官网下载python3.0系列(https://www.python.org/) 2.下载后图标为: 二.安装: Window下: 1.安装路径: 默认安装路径:C:\python35 ...
- (最新)使用爬虫刷CSDN博客访问量——亲测有效
说明:该篇博客是博主一字一码编写的,实属不易,请尊重原创,谢谢大家! 1.概述 前言:前两天刚写了第一篇博客https://blog.csdn.net/qq_41782425/article/deta ...
- Python网络数据采集(1):博客访问量统计
前言 Python中能够爬虫的包还有很多,但requests号称是“让HTTP服务人类”...口气不小,但的确也很好用. 本文是博客里爬虫的第一篇,实现一个很简单的功能:获取自己博客主页里的访问量. ...
随机推荐
- java多线程之生产者-消费者
public class Product { private String lock; public Product(String lock) { this.lock = lock; } public ...
- python连接数据库(1)——mysql
mysql是世界上应用最广的免费数据库,python当然也提供了对它的调用. 首先pip install pymysql,当然自己要知道数据库的用户名和密码,本地数据库的host就是localhost ...
- Android WebView设置背景透明
Adndroid 2.x的设置 在Android 2.x下,设置webview背景为透明的方法: wvContent.setBackgroundColor(0); Adndroid 4.0 由于硬件加 ...
- Spring Boot的学习之路(02):和你一起阅读Spring Boot官网
官网是我们学习的第一手资料,我们不能忽视它.却往往因为是英文版的,我们选择了逃避它,打开了又关闭. 我们平常开发学习中,很少去官网上看.也许学完以后,我们连官网长什么样子,都不是很清楚.所以,我们在开 ...
- Dynamics 365 Document Management
Dynamics CRM中的Document Management功能需要Dynamics CRM与SharePoint进行集成,也就是实现在CRM中上传Document,实际上Document最终存 ...
- 15 BOM的介绍
avaScript基础分为三个部分: ECMAScript:JavaScript的语法标准.包括变量.表达式.运算符.函数.if语句.for语句等. DOM:文档对象模型,操作网页上的元素的API.比 ...
- Hive 学习之路(三)—— Hive CLI和Beeline命令行的基本使用
一.Hive CLI 1.1 Help 使用hive -H或者 hive --help命令可以查看所有命令的帮助,显示如下: usage: hive -d,--define <key=value ...
- Shell学习笔记1》转载自runnoob
无论是shell 还是bat,都是与操作系统结合非常紧密的东西,所以在此占坑,希望有朝一日能够把这些东西融会贯通,于是在此占坑~ 学习地址:http://www.runoob.com/linux/li ...
- SqlServer导入大文件Sql
sqlcmd -S "192.168.1.218" -U "sa" -P "1qaz~xsw2" -d "SispMain&quo ...
- 渗透测试工具SQLmap
一.简介 SQLmap 是一款用 Python 编写的开源渗透测试工具,用来自动检测和利用 SQL 注入漏洞. 二.Windows 下安装 2.1 安装 Python 环境 注:Python 3.0会 ...