
从当当客户端api抓取书评到词云生成
看了好几本大冰的书,感觉对自己的思维有不少的影响。想看看其他读者的评论。便想从当当下手抓取他们评论做个词云。
想着网页版说不定有麻烦的反爬,干脆从手机客户端下手好了。
果其不然,找到一个书评的api。发送请求就有详情的json返回,简直不要太方便...
要是对手机客户端做信息爬取,建议安装一个手机模拟器。
思路:
在安装好的手机模拟器设置好用来抓包的代理,我用的charles。记得安装证书,不然抓不了https的数据包。
然后安装当当客户端,打开进到书评页面。
KZRBSKE.png)
然后成功在charles找到了这个接口。发送get请求就会返回书评...

然后这个接口只有page参数需要注意下,代表请求的第几页。然后其他参数我照抄过来了。
当当边好像没有对这些参数做检验,用很久之前抓的的链接的参数还是能请求到数据...
之后就是请求链接在脚本里解析返回的json就好了,我只需要评论,十几行代码就行。
如果要抓其他书的书评应该修改参数product_id就好。
爬虫代码:
import requests
import json
import random
import time url='http://api.dangdang.com/community/mobile/get_product_comment_list?access-token=&product_id=25288851&time_code=ae4074539cd0bf4ad526785a9439d756&tc=0cdfe66abc1ef55674c1ca8f815414b0&client_version=8.10.0&source_page=&action=get_product_comment_list&ct=android&union_id=537-100893×tamp=1540121525&permanent_id=20181021192526739954846678302543739&custSize=b&global_province_id=111&cv=8.10.0&sort_type=1&product_medium=0&page_size=15&filter_type=1&udid=c3b0e748134cbd9612e3e8b6a7e52952&main_product_id=&user_client=android&label_id=&page='
headers={
'User-Agent':'Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36'
}
def getComments(url, page):
url = url+str(page) #url拼接,为了获取指定页的评论
html = requests.get(url=url,headers=headers)
res = json.loads(html.text)
result = res.get('review_list') #从字典中获取key为review_list的值,这与当当返回的数据结构有关
comments = []
for comment in result:
comments.append(comment['content']) #评论正文
try:
with open('comments.txt','a',encoding='utf-8') as f:
f.write(comment['content']+'\n') #写入文本中,免不了编码错误,加个try算了
except:
print('第'+str(page)+'页出错')
continue
for i in range(1,100): #爬100页的评论
time.sleep(random.choice([1,2,3])) #每次循环强制停1~3秒,控制下频率...
getComments(url,i)
词云生成,先使用jieba分词对爬到的评论进行分词。
记得分词后要用停用词表将一些没有什么意义的字符删去,比如标点符号,各种人称代词等等...
最后用pyecharts生成词云。
词云生成代码:
import jieba

from pyecharts import options as opts

from pyecharts.charts import Page, WordCloud

from pyecharts.globals import SymbolType

#添加自定义的分词

jieba.add_word('你坏')

jieba.add_word('大冰')

jieba.add_word('江湖')

#文本的名称

text_path='comments.txt'

#一些词要去除,停用词表

stopwords_path='stopwords.txt'

#读取要分析的文本

words_file = open(text_path,'r',encoding='utf-8')

text = words_file.read()

def jiebaClearText(text):

    #分词,返回迭代器

    seg_iter = jieba.cut(text,cut_all=False)

    listStr = list(seg_iter)

    res = {}

    #这个循环用来记录词频

    for i in listStr:

        if i in res:

            res[i] += 1

        else:

            res[i.strip()] = 1

    try:

        #读取停用表

        f_stop = open(stopwords_path,encoding='utf-8')

        f_stop_text = f_stop.read()

    finally:

        f_stop.close()

    #以换行符分开文本,因为每个停用词占一行。返回停用词列表

    f_stop_seg_list = f_stop_text.split('\n')

    #这个循环用来删除评论出现在停用词表的词

    for i in f_stop_seg_list:

        if i in res:

            del res[i]

    words = []

    for k,v in res.items():

        words.append((k,v))

    #words的元素是(词,词出现的次数)

    #下面是以出现的次数将words排序

    words.sort(key=lambda x:x[1],reverse=True)

    return words

words = jiebaClearText(text)

words_file.close()  # 关闭一开始打开的文件

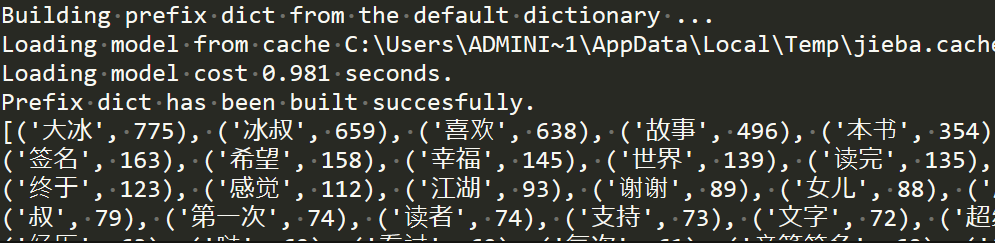
print(words)

#词云生成,用到pyecharts,各参数的含义请到官方文档查看...

worldcloud=(

    WordCloud().add("", words[:60], word_size_range=[10, 100],rotate_step=0, shape='triangle' ).set_global_opts(title_opts=opts.TitleOpts(title="《你坏》"))

    )

worldcloud.render('result.html')  #保存成html文件
结果:
词云:
1V%7DC[JKFBM6.png)
最后,可以看到,其实书评里有很多带正向感情色彩的评论。
内容还是很正能量的哈哈,每天看一遍,赶走抑郁~
所以,容我也向您安利一下大冰的书哈哈。
The End~
从当当客户端api抓取书评到词云生成的更多相关文章
- python抓取数据构建词云
1.词云图 词云图,也叫文字云,是对文本中出现频率较高的"关键词"予以视觉化的展现,词云图过滤掉大量的低频低质的文本信息,使得浏览者只要一眼扫过文本就可领略文本的主旨. 先看几个词 ...
- 百度音乐API抓取
百度音乐API抓取 前段时间做了一个本地音乐的播放器 github地址,想实现在线播放的功能,于是到处寻找API,很遗憾,不是歌曲不全就是质量不高.在网上发现这么一个APIMRASONG博客,有“获取 ...
- python抓取电影<海王>影评词云生成
海王是前段时间大热的影片,个人对这种动漫题材的电影并不是很感兴趣.然鹅,最近这部电影实在太热了,正好最近看自然语言处理的时候,无意间发现了word cloud这个生成词云的库,还蛮好玩的,那就抓抓这部 ...
- Google Map API抓取地图坐标信息小程序
因为实验室需要全国城市乡镇的地理坐标,有Execl的地名信息,需要一一查找地方的经纬度.Google Map地图实验室提供自带的查找经纬度的方法,不过需要一个点一个点的手输入,过于繁琐,所以自己利用G ...
- python抓取百度热词
#baidu_hotword.py #get baidu hotword in news.baidu.com import urllib2 import os import re def getHtm ...
- WireShark系列: 使用WireShark过滤条件抓取特定数据流(zz)
应用抓包过滤,选择Capture | Options,扩展窗口查看到Capture Filter栏.双击选定的接口,如下图所示,弹出Edit Interface Settints窗口. 下图显示了Ed ...
- Twitter数据抓取
说明:这里分三个系列介绍Twitter数据的非API抓取方法.有兴趣的QQ群交流: BitCrawler网络爬虫QQ群 322937592 1.Twitter数据抓取(一) 2.Twitter数据抓取 ...
- 一站式学习Wireshark(八):应用Wireshark过滤条件抓取特定数据流
应用抓包过滤,选择Capture | Options,扩展窗口查看到Capture Filter栏.双击选定的接口,如下图所示,弹出Edit Interface Settints窗口. 下图显示了Ed ...
- Python开发笔记:网络数据抓取
网络数据获取(爬取)分为两部分: 1.抓取(抓取网页) · urlib内建模块,特别是urlib.request · Requests第三方库(中小型网络爬虫的开发) · Scrapy框架(大型网络爬 ...
随机推荐
- CSS-----样式表案例(沃顿商学院)之高级山寨版
HTML-CSS设计----------沃顿商学院(高级山寨版) 1.html代码 <!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Trans ...
- VS2010 常用的快捷键
1.强迫智能感知:Ctrl+J:2.强迫智能感知显示参数信息:Ctrl-Shift-空格:3.格式化整个块:Ctrl+K+F4.检查括号匹配(在左右括号间切换): Ctrl +]5.选中从光标起到行首 ...
- mysql简介/安装以及破解密码等
1.什么是数据库: 数据库即存放数据的仓库,只不过这个仓库是在计算机存储设备上,而且数据是按一定的格式存放的 过去人们将数据存放在文件柜里,现在数据量庞大,已经不再适用 数据库是长期存放在计算机内.有 ...
- G1最佳实践
示例 -Xms1550m -Xmx1550m -XX:+UseG1GC -XX:MaxGCPauseMillis=200 -verbosegc -XX:+PrintGCDateStamps -Xlog ...
- [洛谷P4782] [模板] 2-SAT 问题
NOIp后第一篇题解. NOIp我考的很凉啊...... 题目传送门 之前讲过怎么判断2-SAT是否存在解. 至于如何构造一组解: 我们想到对tarjan缩点后的图进行拓扑排序. 那么对于代表0状态的 ...
- SPA(单页面web应用)和MPA(多页面web应用)的区别
转:https://blog.csdn.net/amaniz/article/details/79203562 vue多页面应用开发请参见: https://github.com/amunamuna/ ...
- !!误解--var vm = new vue({}) 与 export default {} 是一回事儿??
这两者完全不是同一回事.export default {} 是es6的module中的语法, 而var vm = new vue({}) 是创建一个vue实例.引起误解是因为用了webpack开发vu ...
- 树的DFS
Depth-first search (DFS) is an algorithm for traversing or searching tree or graph data structures. ...
- Eclipse添加comment
1.给新增的Java类,自动生成Comment. 打开Preferences,找到Java-->Code Style -->Code Templates-->Comments--&g ...
- Python爬虫-selenium的使用(2)
使用selenium打开chrome浏览器百度进行搜索 12345678910111213141516171819202122232425 from selenium import webdriver ...