
测试 【子牙-writing】 大模型
参考:姜子牙大模型系列 | 写作模型ziya-writing开源!开箱即用,快来认领专属你的写作小助手吧
封神榜:https://github.com/IDEA-CCNL/Fengshenbang-LM

姜子牙大模型:https://huggingface.co/IDEA-CCNL/Ziya-LLaMA-13B-v1.1

子牙-writing大模型:

https://huggingface.co/IDEA-CCNL/Ziya-Writing-LLaMa-13B-v1 【老版】

https://huggingface.co/IDEA-CCNL/Ziya-Writing-13B-v2	【最新】

安装环境:一张4090(24G),需量化
引言
ziya-writing模型基于底座模型ziya-llama-13B-pretrain-v1,使用了高质量的中文写作指令数据进行SFT,同时人工标注了大量排序数据进行RLHF。经过两个阶段的精心训练,使得ziya-writing具备了优秀的写作能力。
安装
- 下载模型
git lfs install

git clone https://huggingface.co/IDEA-CCNL/Ziya-Writing-13B-v2.git
- 安装环境
pip install -r requirement.txt

# requirement.txt

transformers>=4.28.1

bitsandbytes>=0.39.0

torch>=1.12.1

numpy>=1.24.3

llama-cpp-python>=0.1.62
测试
使用量化8bit
简单
from transformers import AutoTokenizer

from transformers import LlamaForCausalLM

import torch

# device = torch.device("cuda")

device = torch.device("cuda" if torch.cuda.is_available() else "cpu")

path = '/home/trimps/llm_model/Ziya-Writing-13B-v2'

query="帮我写一份去西安的旅游计划"

model = LlamaForCausalLM.from_pretrained(path, load_in_8bit=True,torch_dtype=torch.float16)

# 量化

# model = model.quantize(8).cuda()

tokenizer = AutoTokenizer.from_pretrained(path, use_fast=False)

inputs = '<human>:' + query.strip() + '\n<bot>:'

input_ids = tokenizer(inputs, return_tensors="pt").input_ids.to(device)

generate_ids = model.generate(

            input_ids,

            max_new_tokens=2048,

            do_sample = True,

            top_p = 0.85,

            temperature = 0.85,

            repetition_penalty=1.,

            eos_token_id=2,

            bos_token_id=1,

            pad_token_id=0)

output = tokenizer.batch_decode(generate_ids)[0]

print(output)
Web
import json,time
import torch
import streamlit as st
from transformers import AutoModelForCausalLM, AutoTokenizer
from transformers.generation.utils import GenerationConfig
from transformers import LlamaForCausalLM
st.set_page_config(page_title="Ziya-Writing")
st.title("Ziya-Writing")
path = '/home/trimps/llm_model/Ziya-Writing-13B-v2'
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
@st.cache_resource
def init_model():
model = LlamaForCausalLM.from_pretrained(path, load_in_8bit=True,torch_dtype=torch.float16)
tokenizer = AutoTokenizer.from_pretrained(path, use_fast=False)
return model, tokenizer
# 执行模型
def exec_model(model, tokenizer,prompt):
inputs = '<human>:' + prompt.strip() + '\n<bot> '
input_ids = tokenizer(inputs, return_tensors="pt").input_ids.to(device)
generate_ids = model.generate(
input_ids,
max_new_tokens=1024,
do_sample = True,
top_p = 0.85,
temperature = 0.85,
repetition_penalty=1.,
eos_token_id=2,
bos_token_id=1,
pad_token_id=0)
# print(tokenizer.batch_decode(generate_ids)[0].split('<bot>')[1].strip('</s>'))
output = tokenizer.batch_decode(generate_ids)[0].split('<bot>')[1].strip('</s>')
return output
def main():
model, tokenizer = init_model()
with st.chat_message("assistant", avatar=''):
st.markdown("您好,我是Ziya-Writing大模型,很高兴为您服务")
if prompt := st.chat_input("Shift + Enter 换行, Enter 发送"):
with st.chat_message("user", avatar=''):
st.markdown(prompt)
print(f"[user] {prompt}", flush=True)
start = time.time()
with st.chat_message("assistant", avatar=''):
placeholder = st.empty()
response= exec_model(model, tokenizer,prompt)
if torch.backends.mps.is_available():
torch.mps.empty_cache()
placeholder.markdown(response)
end = time.time()
st.write("时间:{}s".format(end-start))
print(response)
if __name__ == "__main__":
main()
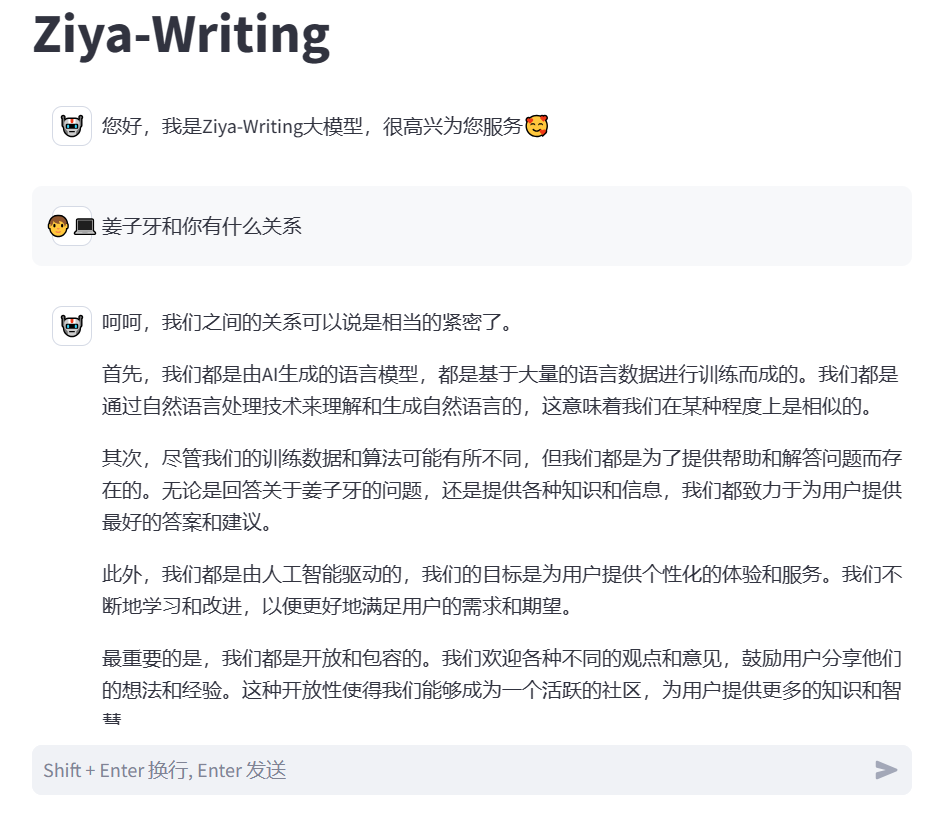
- PS:
- 感觉写作能力和通用的模型差不多,比如同体量的(百川2-13B)
- 一张4090跑起来声音快要炸了。
测试 【子牙-writing】 大模型的更多相关文章
- 【测试分析】HTSM模型
◆版权声明:本文出自胖喵~的博客,转载必须注明出处. 转载请注明出处:http://www.cnblogs.com/by-dream/p/5508428.html 概述 HTSM全称Heuristic ...
- 让Quality Center走下神坛--测试管理工具大PK(转)
让Quality Center走下神坛--测试管理工具QC/ALM 和 RQM.Jira.TP.SCTM大PK 在写完了<让QTP走下神坛>之后,现在来谈谈测试管理工具,献给所有正在或打算 ...
- DeepSpeed Chat: 一键式RLHF训练,让你的类ChatGPT千亿大模型提速省钱15倍
DeepSpeed Chat: 一键式RLHF训练,让你的类ChatGPT千亿大模型提速省钱15倍 1. 概述 近日来,ChatGPT及类似模型引发了人工智能(AI)领域的一场风潮. 这场风潮对数字世 ...
- 无插件的大模型浏览器Autodesk Viewer开发培训-武汉-2014年8月28日 9:00 – 12:00
武汉附近的同学们有福了,这是全球第一次关于Autodesk viewer的教室培训. :) 你可能已经在各种场合听过或看过Autodesk最新推出的大模型浏览器,这是无需插件的浏览器模型,支持几十种数 ...
- Android渗透测试Android渗透测试入门教程大学霸
Android渗透测试Android渗透测试入门教程大学霸 第1章 Android渗透测试 Android是一种基于Linux的自由及开放源代码的操作系统,主要用于移动设备,如智能手机.平板等.目前 ...
- PowerDesigner 学习:十大模型及五大分类
个人认为PowerDesigner 最大的特点和优势就是1)提供了一整套的解决方案,面向了不同的人员提供不同的模型工具,比如有针对企业架构师的模型,有针对需求分析师的模型,有针对系统分析师和软件架构师 ...
- 测试TextKit渲染大文本的效率
测试TextKit渲染大文本的效率 TextKit可以用来做精美的电子书,而电子书通常都是txt格式的,那么渲染txt格式的文本的效率如何呢? 以下来进行测试. #import "RootV ...
- PowerDesigner 15学习笔记:十大模型及五大分类
个人认为PowerDesigner 最大的特点和优势就是1)提供了一整套的解决方案,面向了不同的人员提供不同的模型工具,比如有针对企业架构师的模型,有针对需求分析师的模型,有针对系统分析师和软件架构师 ...
- 华为高级研究员谢凌曦:下一代AI将走向何方?盘古大模型探路之旅
摘要:为了更深入理解千亿参数的盘古大模型,华为云社区采访到了华为云EI盘古团队高级研究员谢凌曦.谢博士以非常通俗的方式为我们娓娓道来了盘古大模型研发的"前世今生",以及它背后的艰难 ...
- 文心大模型api使用
文心大模型api使用 首先,我们要获取硅谷社区的连个key 复制两个api备用 获取Access Token 获取access_token示例代码 之后就会输出 作文创作 作文创作:作文创作接口基于文 ...
随机推荐
- js逆向之jsRpc
github: https://github.com/jxhczhl/JsRpc 简介: 通过远程调用(rpc)的方式免去抠代码补环境 原理: 在网站的控制台新建一个WebScoket客户端链接到服务 ...
- Blazor 小技巧之 lambda传参
我们的按钮点击事件,基本上都是一个无参的方法或者是一个MouseEnvent方法. 这里以BootstrapBlazor的Button为例,它的点击回调是这样的: EventCallback<M ...
- 使用redis 的订阅服务
1.业务使用场景 我们在使用表单动态添加字段,如果新增字段,再保存数据,这个时候就会出错,出错的原因是seata 再本地缓存元数据,修改物理表的时候,这个元数据并没有发生变化,因此需要刷新元数据,因为 ...
- windows 上部署 kafka 做测试
1.下载 需要下载 zookeeper 和kafka 我下载的版本是 2.部署 2.1 部署 zookeeper 2.1.1 新建配置文件 zoo.cfg 内容为 tickTime = 2000 da ...
- 下列哪个选项是对ICMP FLOOD攻击的正确描述?
A. 通过重复发送HTTP GET请求,将内容传输的负载施加到攻击目标服务器上. B. 通过使用ping命令发送大量请求包,导致通向被攻击服务器过载并阻止访问. C. 通过发送与连接启动请求对应 ...
- LeetCode题集-8 - 字符串转换整数 (atoi)
题目:请你来实现一个 myAtoi(string s) 函数,使其能将字符串转换成一个 32 位有符号整数. 01.手动处理每个字符法 最简单的方法永远是脑海中第一个想到的方法,也是最暴力的方法,而这 ...
- 《刚刚问世》系列初窥篇-Java+Playwright自动化测试-7-元素基础定位方式-下篇 (详细教程)
1.简介 上一篇主要是讲解我们日常工作中在使用Playwright进行元素定位的一些比较常用的基础定位方式的理论基础知识以及在什么情况下推荐使用.今天这一篇讲解和分享一下剩下部分的基础定位方式. 2. ...
- WinDbg: SOSEX 下载,加载和使用帮助
SOSex 是 SOS 的扩展,由 Steve Johnson 开发,他是微软的一个员工,开发并免费提供了 SOSex for download 的下载,但该软件并不开源. 通常,该扩展不能与其他 D ...
- 关于 JavaScript 中的 Array.reduce()
关于 JavaScript 中的 Array.reduce() reduce() 方法在 MDN 的定义看起来很复杂: reduce((previousValue, currentValue, cur ...
- 中电金信:基于AI的智能化国内信用证结算系统
2023年<商业银行资本管理办法>正式稿中,明确规定了国内信用证的信用转换系数:与贸易直接相关的短期或有项目,其信用转换系数为20%:而基于服务贸易的国内信用证,其系数为50%. 这一 ...