
Spark 宽窄依赖
面试时被问到spark RDD的宽窄依赖,虽然问题很简单,但是答得很不好。还是应该整理一下描述,这样面试才能答得更好。
看到一篇很好的文章,转载过来了。感觉比《spark技术内幕》这本书讲的好多了。
原文链接:https://www.jianshu.com/p/5c2301dfa360
1.窄依赖
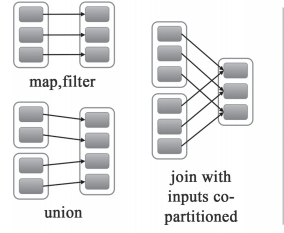
窄依赖就是指父RDD的每个分区只被一个子RDD分区使用,子RDD分区通常只对应常数个父RDD分区,如下图所示【其中每个小方块代表一个RDD Partition】
窄依赖有分为两种:
- 一种是一对一的依赖,即OneToOneDependency
- 还有一个是范围的依赖,即RangeDependency,它仅仅被org.apache.spark.rdd.UnionRDD使用。UnionRDD是把多个RDD合成一个RDD,这些RDD是被拼接而成,即每个parent RDD的Partition的相对顺序不会变,只不过每个parent RDD在UnionRDD中的Partition的起始位置不同
2.宽依赖
宽依赖就是指父RDD的每个分区都有可能被多个子RDD分区使用,子RDD分区通常对应父RDD所有分区,如下图所示【其中每个小方块代表一个RDD Partition】

3.窄依赖与窄依赖比较
- 宽依赖往往对应着shuffle操作,需要在运行的过程中将同一个RDD分区传入到不同的RDD分区中,中间可能涉及到多个节点之间数据的传输,而窄依赖的每个父RDD分区通常只会传入到另一个子RDD分区,通常在一个节点内完成。
- 当RDD分区丢失时,对于窄依赖来说,由于父RDD的一个分区只对应一个子RDD分区,这样只需要重新计算与子RDD分区对应的父RDD分区就行。这个计算对数据的利用是100%的
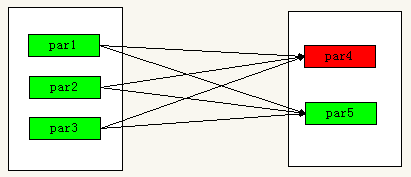
- 当RDD分区丢失时,对于宽依赖来说,重算的父RDD分区只有一部分数据是对应丢失的子RDD分区的,另一部分就造成了多余的计算。宽依赖中的子RDD分区通常来自多个父RDD分区,极端情况下,所有父RDD都有可能重新计算。如下图,par4丢失,则需要重新计算par1,par2,par3,产生了冗余数据par5
4.宽依赖,窄依赖函数
- 窄依赖的函数有:
map, filter, union, join(父RDD是hash-partitioned ), mapPartitions, mapValues - 宽依赖的函数有:
groupByKey, join(父RDD不是hash-partitioned ), partitionBy
作者:不圆的石头
链接:https://www.jianshu.com/p/5c2301dfa360
來源:简书
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
Spark 宽窄依赖的更多相关文章
- 11、spark内核架构剖析与宽窄依赖
一.内核剖析 1.内核模块 1.Application 2.spark-submit 3.Driver 4.SparkContext 5.Master 6.Worker 7.Executor 8.Jo ...
- Spark RDD基本概念、宽窄依赖、转换行为操作
目录 RDD概述 RDD的内部代码 案例 小总结 转换.行动算子 宽.窄依赖 Reference 本文介绍一下rdd的基本属性概念.rdd的转换/行动操作.rdd的宽/窄依赖. RDD:Resilie ...
- spark rdd 宽窄依赖理解
== 转载 == http://blog.csdn.net/houmou/article/details/52531205 Spark中RDD的高效与DAG图有着莫大的关系,在DAG调度中需要对计算过 ...
- Spark RDD 宽窄依赖
RDD 宽窄依赖 RDD之间有一系列的依赖关系, 可分为窄依赖和宽依赖 窄依赖 从 RDD 的 parition 角度来看 父 RRD 的 parition 和 子 RDD 的 parition 之间 ...
- 【Spark-core学习之五】 RDD宽窄依赖 & Stage
环境 虚拟机:VMware 10 Linux版本:CentOS-6.5-x86_64 客户端:Xshell4 FTP:Xftp4 jdk1.8 scala-2.10.4(依赖jdk1.8) spark ...
- Spark 宽窄依赖和stage的划分
窄依赖 父RDD和子RDD partition之间的关系是一对一的,或者父RDD一个partition只对应一个子RDD的partition情况下的父RDD和子RDD partition关系是多对一的 ...
- 关于spark RDD trans action算子、lineage、宽窄依赖详解
这篇文章想从spark当初设计时为何提出RDD概念,相对于hadoop,RDD真的能给spark带来何等优势.之前本想开篇是想总体介绍spark,以及环境搭建过程,但个人感觉RDD更为重要 铺垫 在h ...
- spark优化——依赖包传入HDFS_spark.yarn.jar和spark.yarn.archive的使用
一.参数说明 启动Spark任务时,在没有配置spark.yarn.archive或者spark.yarn.jars时, 会看到不停地上传jar,非常耗时:使用spark.yarn.archive可以 ...
- 通过 spark.files 传入spark任务依赖的文件源码分析
版本:spak2.3 相关源码:org.apache.spark.SparkContext 在创建spark任务时候,往往会指定一些依赖文件,通常我们可以在spark-submit脚本使用--file ...
随机推荐
- 巨蟒python全栈开发数据库前端6:事件onclick的两种绑定方式&&onblur和onfocus事件&&window.onload解释&&小米商城讲解
1.回顾上节内容(JavaScript) 一.JavaScript概述 1.ECMAScript和JavaScript的关系 2.ECMAScript的历史 3.JavaScript是一门前后端都可以 ...
- 四、H5 录制视频 Web Real-Time Communication
Web Real-Time Communication HTML5实现视频直播功能思路详解_html5教程技巧_脚本之家 https://m.jb51.net/html5/587215.html
- Web Tracking
采集方式_数据采集_用户指南_日志服务-阿里云 https://help.aliyun.com/document_detail/28981.html http://docs-aliyun.cn-han ...
- Taylor's theorem
w https://en.wikipedia.org/wiki/Taylor_series
- 第05章—Swagger2打造在线接口文档
spring boot 系列学习记录:http://www.cnblogs.com/jinxiaohang/p/8111057.html 码云源码地址:https://gitee.com/jinxia ...
- awesome-modern-cpp
Awesome Modern C++ A collection of resources on modern C++. The goal is to collect a list of resouce ...
- shell判断文件/目录是否存在
https://www.cnblogs.com/37yan/p/6962563.html caution!!! if should be end with fi caution!!! there sh ...
- django 表单系统 之 forms.ModelForm
继承forms.ModelForm类实现django的表单系统 有时,我们在前端定义的<form>表单和后端定义的model结构基本上是一样的,那么我们可以直接在后端定义model后,定义 ...
- Ubuntu系统Python3相关环境或模块安装
前提:一般用户安装都命令前都需要sudo ,或者在root用户下 1.Ubuntu 16.04 安装PyCharm Ubuntu 16.04 安装PyCharm 本文通过第三方源安装PyCharm,好 ...
- python通过原生sql查询数据库(共享类库)
#!/usr/bin/python # -*- coding: UTF-8 -*- """DB共享类库""" # 使用此类,先实例化一个Da ...