
一文解析Apache Avro数据
摘要:本文将演示如果序列化生成avro数据,并使用FlinkSQL进行解析。
本文分享自华为云社区《【技术分享】Apache Avro数据的序列化、反序列&&FlinkSQL解析Avro数据》,作者: 南派三叔。
技术背景
随着互联网高速的发展,云计算、大数据、人工智能AI、物联网等前沿技术已然成为当今时代主流的高新技术,诸如电商网站、人脸识别、无人驾驶、智能家居、智慧城市等等,不仅方面方便了人们的衣食住行,背后更是时时刻刻有大量的数据在经过各种各样的系统平台的采集、清晰、分析,而保证数据的低时延、高吞吐、安全性就显得尤为重要,Apache Avro本身通过Schema的方式序列化后进行二进制传输,一方面保证了数据的高速传输,另一方面保证了数据安全性,avro当前在各个行业的应用越来越广泛,如何对avro数据进行处理解析应用就格外重要,本文将演示如果序列化生成avro数据,并使用FlinkSQL进行解析。
本文是avro解析的demo,当前FlinkSQL仅适用于简单的avro数据解析,复杂嵌套avro数据暂时不支持。
场景介绍
本文主要介绍以下三个重点内容:
- 如何序列化生成Avro数据
- 如何反序列化解析Avro数据
- 如何使用FlinkSQL解析Avro数据
前提条件
- 了解avro是什么,可参考apache avro官网快速入门指南
- 了解avro应用场景
操作步骤
1、新建avro maven工程项目,配置pom依赖
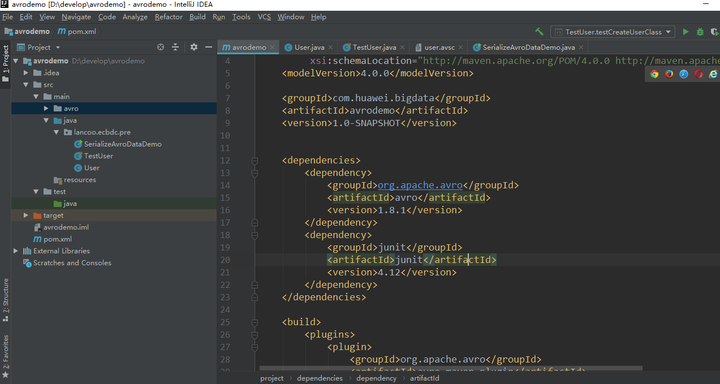
pom文件内容如下:
<?xml version="1.0" encoding="UTF-8"?>

<project xmlns="http://maven.apache.org/POM/4.0.0"

         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"

         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd">

    <modelVersion>4.0.0</modelVersion>

    <groupId>com.huawei.bigdata</groupId>

    <artifactId>avrodemo</artifactId>

    <version>1.0-SNAPSHOT</version>

    <dependencies>

        <dependency>

            <groupId>org.apache.avro</groupId>

            <artifactId>avro</artifactId>

            <version>1.8.1</version>

        </dependency>

        <dependency>

            <groupId>junit</groupId>

            <artifactId>junit</artifactId>

            <version>4.12</version>

        </dependency>

    </dependencies>

    <build>

        <plugins>

            <plugin>

                <groupId>org.apache.avro</groupId>

                <artifactId>avro-maven-plugin</artifactId>

                <version>1.8.1</version>

                <executions>

                    <execution>

                        <phase>generate-sources</phase>

                        <goals>

                            <goal>schema</goal>

                        </goals>

                        <configuration>

                            <sourceDirectory>${project.basedir}/src/main/avro/</sourceDirectory>

                            <outputDirectory>${project.basedir}/src/main/java/</outputDirectory>

                        </configuration>

                    </execution>

                </executions>

            </plugin>

            <plugin>

                <groupId>org.apache.maven.plugins</groupId>

                <artifactId>maven-compiler-plugin</artifactId>

                <configuration>

                    <source>1.6</source>

                    <target>1.6</target>

                </configuration>

            </plugin>

        </plugins>

    </build>

</project>
注意:以上pom文件配置了自动生成类的路径,即${project.basedir}/src/main/avro/和${project.basedir}/src/main/java/,这样配置之后,在执行mvn命令的时候,这个插件就会自动将此目录下的avsc schema生成类文件,并放到后者这个目录下。如果没有生成avro目录,手动创建一下即可。
2、定义schema
使用JSON为Avro定义schema。schema由基本类型(null,boolean, int, long, float, double, bytes 和string)和复杂类型(record, enum, array, map, union, 和fixed)组成。例如,以下定义一个user的schema,在main目录下创建一个avro目录,然后在avro目录下新建文件 user.avsc :
{"namespace": "lancoo.ecbdc.pre",

 "type": "record",

 "name": "User",

 "fields": [

     {"name": "name", "type": "string"},

     {"name": "favorite_number",  "type": ["int", "null"]},

     {"name": "favorite_color", "type": ["string", "null"]}

 ]

}
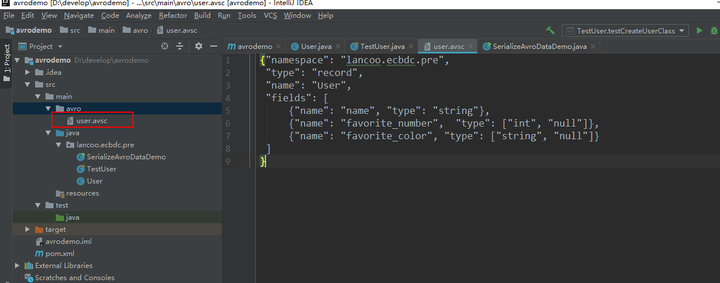
3、编译schema
点击maven projects项目的compile进行编译,会自动在创建namespace路径和User类代码

4、序列化
创建TestUser类,用于序列化生成数据
User user1 = new User();

user1.setName("Alyssa");

user1.setFavoriteNumber(256);

// Leave favorite col or null

// Alternate constructor

User user2 = new User("Ben", 7, "red");

// Construct via builder

User user3 = User.newBuilder()

        .setName("Charlie")

        .setFavoriteColor("blue")

        .setFavoriteNumber(null)

        .build();

// Serialize user1, user2 and user3 to disk

DatumWriter<User> userDatumWriter = new SpecificDatumWriter<User>(User.class);

DataFileWriter<User> dataFileWriter = new DataFileWriter<User>(userDatumWriter);

dataFileWriter.create(user1.getSchema(), new File("user_generic.avro"));

dataFileWriter.append(user1);

dataFileWriter.append(user2);

dataFileWriter.append(user3);

dataFileWriter.close();
执行序列化程序后,会在项目的同级目录下生成avro数据
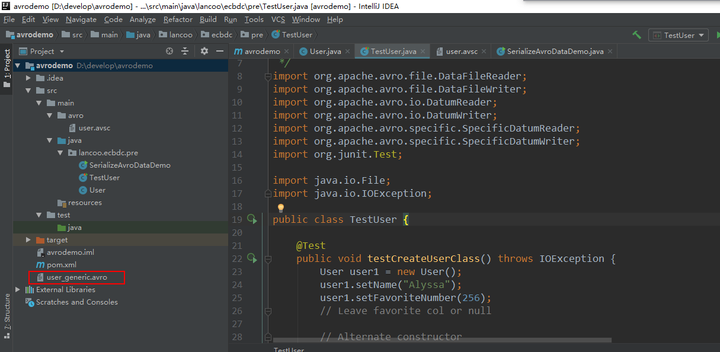
user_generic.avro内容如下:
Objavro.schema�{"type":"record","name":"User","namespace":"lancoo.ecbdc.pre","fields":[{"name":"name","type":"string"},{"name":"favorite_number","type":["int","null"]},{"name":"favorite_color","type":["string","null"]}]}
至此avro数据已经生成。
5、反序列化
通过反序列化代码解析avro数据
// Deserialize Users from disk

DatumReader<User> userDatumReader = new SpecificDatumReader<User>(User.class);

DataFileReader<User> dataFileReader = new DataFileReader<User>(new File("user_generic.avro"), userDatumReader);

User user = null;

while (dataFileReader.hasNext()) {

    // Reuse user object by passing it to next(). This saves us from

    // allocating and garbage collecting many objects for files with

    // many items.

    user = dataFileReader.next(user);

    System.out.println(user);

}
执行反序列化代码解析user_generic.avro
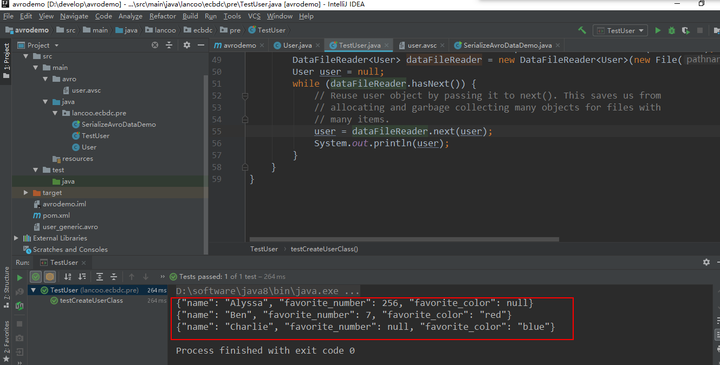
avro数据解析成功。
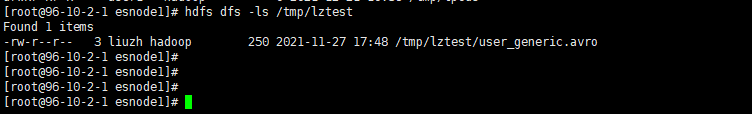
6、将user_generic.avro上传至hdfs路径
hdfs dfs -mkdir -p /tmp/lztest/

hdfs dfs -put user_generic.avro /tmp/lztest/
7、配置flinkserver
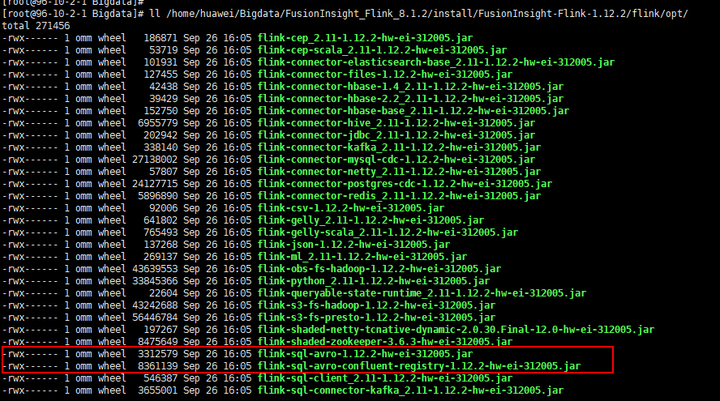
- 准备avro jar包
将flink-sql-avro-*.jar、flink-sql-avro-confluent-registry-*.jar放入flinkserver lib,将下面的命令在所有flinkserver节点执行
cp /opt/huawei/Bigdata/FusionInsight_Flink_8.1.2/install/FusionInsight-Flink-1.12.2/flink/opt/flink-sql-avro*.jar /opt/huawei/Bigdata/FusionInsight_Flink_8.1.3/install/FusionInsight-Flink-1.12.2/flink/lib

chmod 500 flink-sql-avro*.jar

chown omm:wheel flink-sql-avro*.jar
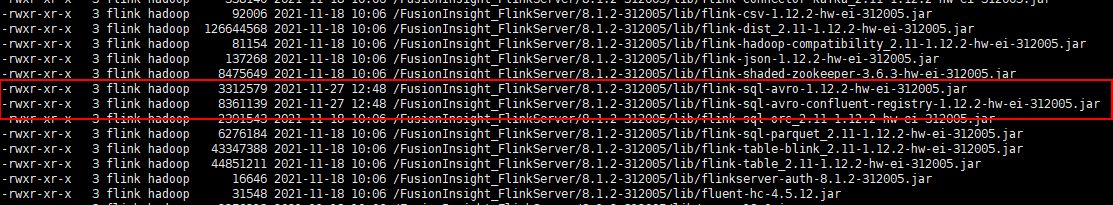
- 同时重启FlinkServer实例,重启完成后查看avro包是否被上传
hdfs dfs -ls /FusionInsight_FlinkServer/8.1.2-312005/lib
8、编写FlinkSQL
CREATE TABLE testHdfs(

  name String,

  favorite_number int,

  favorite_color String

) WITH(

  'connector' = 'filesystem',

  'path' = 'hdfs:///tmp/lztest/user_generic.avro',

  'format' = 'avro'

);CREATE TABLE KafkaTable (

  name String,

  favorite_number int,

  favorite_color String

) WITH (

  'connector' = 'kafka',

  'topic' = 'testavro',

  'properties.bootstrap.servers' = '96.10.2.1:21005',

  'properties.group.id' = 'testGroup',

  'scan.startup.mode' = 'latest-offset',

  'format' = 'avro'

);

insert into

  KafkaTable

select

  *

from

  testHdfs;
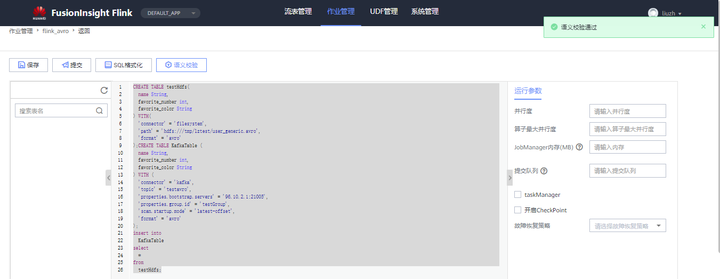
保存提交任务
9、查看对应topic中是否有数据
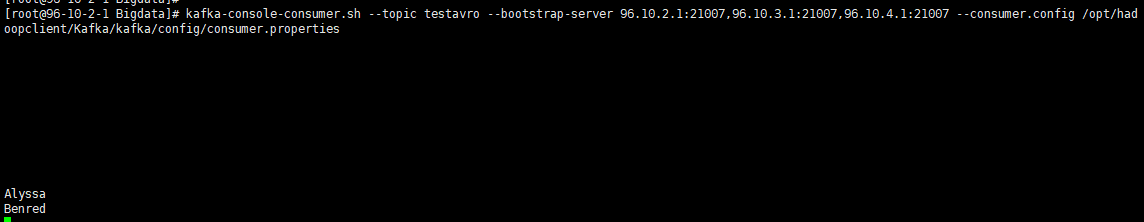
FlinkSQL解析avro数据成功。
一文解析Apache Avro数据的更多相关文章
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(二十九):推送avro格式数据到topic,并使用spark structured streaming接收topic解析avro数据
推送avro格式数据到topic 源代码:https://github.com/Neuw84/structured-streaming-avro-demo/blob/master/src/main/j ...
- Apache Avro:一个新的数据交换格式
原文: http://blog.cloudera.com/blog/2009/11/avro-a-new-format-for-data-interchange/ 注:由于个人英语能力有限,翻译不准确 ...
- Apache Avro# 1.8.2 Specification (Avro 1.8.2规范)一
h4 { text-indent: 0.71cm; margin-top: 0.49cm; margin-bottom: 0.51cm; direction: ltr; color: #000000; ...
- Apache Avro & Avro Schema简介
为什么需要schema registry? 首先我们知道: Kafka将字节作为输入并发布 没有数据验证 但是: 如果Producer发送了bad data怎么办? 如果字段被重命名怎么办? 如果数据 ...
- Apache Avro 与 Thrift 比较
http://www.tbdata.org/archives/1307 Avro和Thrift都是跨语言,基于二进制的高性能的通讯中间件. 它们都提供了数据序列化的功能和RPC服务. 总体功能上类似, ...
- Apache Avro# 1.8.2 Specification (Avro 1.8.2规范)二
h5 { text-indent: 0.71cm; margin-top: 0.49cm; margin-bottom: 0.51cm; direction: ltr; color: #000000; ...
- spark使用scala读取Avro数据(转)
这是一篇翻译,原文来自:How to load some Avro data into Spark. 首先,为什么使用 Avro ? 最基本的格式是 CSV ,其廉价并且不需要顶一个一个 schema ...
- Hadoop基础-Apache Avro串行化的与反串行化
Hadoop基础-Apache Avro串行化的与反串行化 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.Apache Avro简介 1>.Apache Avro的来源 ...
- Swift - 解析XML格式数据(分别使用GDataXML和DDXML)
在做一些应用的时候经常需要用到XML解析,比如获取Web Service数据,读取RSS新闻或者博客数据源.下面演示了两个非常方便高效的XML库在Swift里的调用方法. 假设需要被解析的XML数据文 ...
随机推荐
- keil 报错 expected an identifier
该报错是因为命名重复,可能是因为你加的头文件里面的命名和原程序中的有重复,所以产生了错误.
- 案例分析 CAN OPEN 调试记录 进度
2020.12.29 发现一片博客:https://blog.csdn.net/harrycomeon/article/details/94650103 需要一个硬件:CAN分析仪,网上200元左右. ...
- [学习总结]6、Android异步消息处理机制完全解析,带你从源码的角度彻底理解
开始进入正题,我们都知道,Android UI是线程不安全的,如果在子线程中尝试进行UI操作,程序就有可能会崩溃.相信大家在日常的工作当中都会经常遇到这个问题,解决的方案应该也是早已烂熟于心,即创建一 ...
- java代码从出生到执行的过程浅析
阅读<深入理解java虚拟机 第二版 JVM高级特性与最佳实践> - jdk版本为1.6 1.什么是编译型语言.解释型语言 解释型语言:源代码不是直接翻译成机器语言,而是先翻译成中间代码, ...
- 了解LINQ
本文主要的是泛谈LINQ是啥?以及常见的用法大纲如下: LINQ的那些根基 LINQ的一些基本用法 LINQ的根基 IEnumerable和IEnumerator 为啥能够被foreach? 实际上, ...
- spring切面-单线程简单权限判定
spring切面简单模拟用户权限判定 需求: 游客:仅注册用户 用户:修改,注册 管理员:删除,查询,修改,注册 1,文件配置 导包 src下创建applicationContext.xml文件配置如 ...
- 位置式PID讲解
table { margin: auto } 一.公式拆解 \(PID\)公式展示: \[u(t)=K_p(e(t)+\frac{1}{T_t } ∫_0^te(t)dt+T_D \frac {de( ...
- java 多线程:线程通信-等待通知机制wait和notify方法;(同步代码块synchronized和while循环相互嵌套的差异);管道通信:PipedInputStream;PipedOutputStream;PipedWriter; PipedReader
1.等待通知机制: 等待通知机制的原理和厨师与服务员的关系很相似: 1,厨师做完一道菜的时间不确定,所以厨师将菜品放到"菜品传递台"上的时间不确定 2,服务员什么时候可以取到菜,必 ...
- 动态导入模块__import__("str") importlib标准库
解释器内部使用的为__import__('str') #!/usr/bin/env python # Author:Zhangmingda print('我是aa类 ') #被import的时候就执行 ...
- 如何在java web工程下建立存储property文件的文件夹,让Java程序直接读取
如何在java web工程下建立存储property文件的文件夹,让Java程序直接读取: 步骤如下: