
ELk架构解析和部署
目录
一、什么是elk. 1
二、ELK 常用架构及使用场景介绍... 2
1、最简单架构... 2
2、以Logstash 作为日志搜集器... 2
3、以Beats 作为日志搜集器... 3
4、引入消息队列模式... 3
三、基于 Filebeat+ELK架构的配置部署详解... 4
1、安装jdk. 5
2、安装elasticsearch. 5
3、安装kibana. 7
4、安装logstash. 8
5、安装filebeats. 9
一、什么是elk
ELK 不是一款软件,而是 Elasticsearch、Logstash 和 Kibana 三种软件产品的首字母缩写。这三者都是开源软件,通常配合使用,而且又先后归于 Elastic.co 公司名下,所以被简称为 ELK Stack。根据 Google Trend 的信息显示,ELK Stack 已经成为目前最流行的集中式日志解决方案。
- Elasticsearch:分布式搜索和分析引擎,具有高可伸缩、高可靠和易管理等特点。基于 Apache Lucene 构建,能对大容量的数据进行接近实时的存储、搜索和分析操作。通常被用作某些应用的基础搜索引擎,使其具有复杂的搜索功能;
- Logstash:数据收集引擎。它支持动态的从各种数据源搜集数据,并对数据进行过滤、分析、丰富、统一格式等操作,然后存储到用户指定的位置;
- Kibana:数据分析和可视化平台。通常与 Elasticsearch 配合使用,对其中数据进行搜索、分析和以统计图表的方式展示;
- Filebeat:ELK 协议栈的新成员,一个轻量级开源日志文件数据搜集器,基于 Logstash-Forwarder 源代码开发,是对它的替代。在需要采集日志数据的 server 上安装 Filebeat,并指定日志目录或日志文件后,Filebeat 就能读取数据,迅速发送到 Logstash 进行解析,亦或直接发送到 Elasticsearch 进行集中式存储和分析。
二、ELK 常用架构及使用场景介绍
1、最简单架构
在这种架构中,只有一个 Logstash、Elasticsearch 和 Kibana 实例。Logstash 通过输入插件从多种数据源(比如日志文件、标准输入 Stdin 等)获取数据,再经过滤插件加工数据,然后经 Elasticsearch 输出插件输出到 Elasticsearch,通过 Kibana 展示。
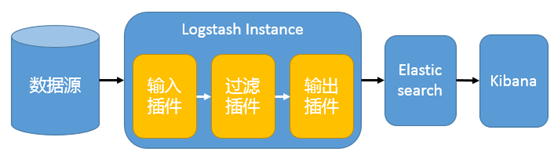
这种架构非常简单,使用场景也有限。初学者可以搭建这个架构,了解 ELK 如何工作
2、以Logstash 作为日志搜集器

这种结构因为需要在各个服务器上部署 Logstash,而它比较消耗 CPU 和内存资源,所以比较适合计算资源丰富的服务器,否则容易造成服务器性能下降,甚至可能导致无法正常工作。
3、以Beats 作为日志搜集器
这种架构引入 Beats 作为日志搜集器。目前 Beats 包括四种:
- Packetbeat(搜集网络流量数据);
- Topbeat(搜集系统、进程和文件系统级别的 CPU 和内存使用情况等数据);
- Filebeat(搜集文件数据);
- Winlogbeat(搜集 Windows 事件日志数据)。
Beats 将搜集到的数据发送到 Logstash,经 Logstash 解析、过滤后,将其发送到 Elasticsearch 存储,并由 Kibana 呈现给用户。
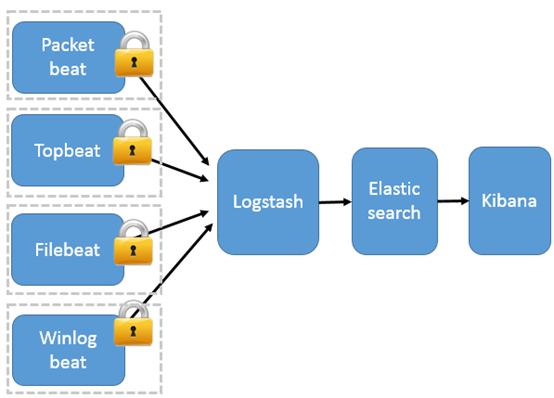
这种架构解决了 Logstash 在各服务器节点上占用系统资源高的问题。相比 Logstash,Beats 所占系统的 CPU 和内存几乎可以忽略不计。另外,Beats 和 Logstash 之间支持 SSL/TLS 加密传输,客户端和服务器双向认证,保证了通信安全。
因此这种架构适合对数据安全性要求较高,同时各服务器性能比较敏感的场景。
4、引入消息队列模式
Beats 还不支持输出到消息队列(新版本除外:5.0版本及以上),所以在消息队列前后两端只能是 Logstash 实例。logstash从各个数据源搜集数据,不经过任何处理转换仅转发出到消息队列(kafka、redis、rabbitMQ等),后logstash从消息队列取数据进行转换分析过滤,输出到elasticsearch,并在kibana进行图形化展示
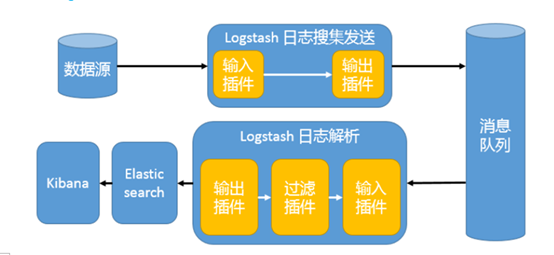
模式特点:这种架构适合于日志规模比较庞大的情况。但由于 Logstash 日志解析节点和 Elasticsearch 的负荷比较重,可将他们配置为集群模式,以分担负荷。引入消息队列,均衡了网络传输,从而降低了网络闭塞,尤其是丢失数据的可能性,但依然存在 Logstash 占用系统资源过多的问题
工作流程:Filebeat采集—> logstash转发到kafka—> logstash处理从kafka缓存的数据进行分析—> 输出到es—> 显示在kibana
三、基于 Filebeat+ELK架构的配置部署详解
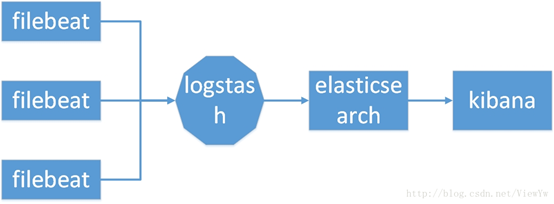
1、Filebeat负责收集应用写到磁盘上的日志,并将日志发送给logstash
2、logstash处理来自filebeat的日志,并将处理后的日志保存elasticsearch索引库。
3、elasticsearch存储来自logstash的日志。
4、kibana从elasticsearch搜索日志,并展示到页面。
系统环境及软件:
centos7.5,java8
Filebeat,logstash,elasticsearch,kibana(可以去官网下载,这里用的版本是6.8.1)
1、安装jdk
至少jdk 7以上。一般推荐使用 Oracle JDK 1.8 或者 OpenJDK 1.8。我们这里使用 Oracle JDK 1.8。
mkdir /usr/java

tar xf jdk-8u171-linux-x64.tar.gz

mv jdk1..0_171/ /usr/java/jdk1.
#添加java环境变量
echo 'export JAVA_HOME=/usr/java/jdk1.8' >>/etc/profile

echo 'export CLASSPATH=$CLASSPATH:$JAVA_HOME/lib:$JAVA_HOME/lib/tools.jar' >>/etc/profile

echo 'export PATH=$JAVA_HOME/bin:$JAVA_HOME/jre/bin:$PATH' >>/etc/profile

source /etc/profile

java -version
2、安装elasticsearch
2.1创建用户
出于安全考虑,elasticsearch默认不允许以root账号运行。
groupadd es

useradd -g es es

echo ""|passwd --stdin es
2.2 调整系统参数
echo "vm.max_map_count = 655360" >> /etc/sysctl.conf

sysctl -p


vim /etc/security/limits.conf  ==》新增如下内容

* soft nofile

* hard nofile

* soft nproc

* hard nproc
2.3 安装配置es
[root@linux01 ~]# tar xf elasticsearch-6.8..tar.gz

[root@linux01 ~]# mv elasticsearch-6.8. /usr/local/elasticsearch

[root@linux01 ~]# cd /usr/local/elasticsearch/config/

[root@linux01 config]# cp elasticsearch.yml elasticsearch.yml.bak

[root@linux01 config]# > elasticsearch.yml

[root@linux01 config]# vim elasticsearch.yml   #配置文件修改成如下

cluster.name: "elasticsearch_petition"

node.name: node-

transport.host: 0.0.0.0

transport.publish_host: 0.0.0.0

transport.bind_host: 0.0.0.0

network.host: 0.0.0.0

http.port:

path.data: /usr/local/elasticsearch/data

path.logs: /usr/local/elasticsearch/logs

http.cors.enabled: true

http.cors.allow-origin: "*"

[root@linux01 config]# mkdir /usr/local/elasticsearch/data

[root@linux01 config]# mkdir /usr/local/elasticsearch/logs

[root@linux01 ~]# chown -R es.es /usr/local/elasticsearch/
2.4启动
su - es

/usr/local/elasticsearch/bin/elasticsearch &

#启动比较慢,稍等几分钟
2.5 验证 elasticsearch
[es@linux01 ~]$ curl 127.0.0.1:   #出来以下内容,安装成功

{

  "name" : "node-01",

  "cluster_name" : "elasticsearch_petition",

  "cluster_uuid" : "jPmcOZu5Rfi5JOq1wsWUSQ",

  "version" : {

    "number" : "6.8.1",

    "build_flavor" : "default",

    "build_type" : "tar",

    "build_hash" : "1fad4e1",

    "build_date" : "2019-06-18T13:16:52.517138Z",

    "build_snapshot" : false,

    "lucene_version" : "7.7.0",

    "minimum_wire_compatibility_version" : "5.6.0",

    "minimum_index_compatibility_version" : "5.0.0"

  },

  "tagline" : "You Know, for Search"

}
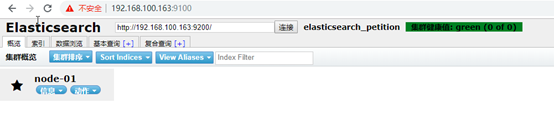
2.6 安装head插件(非必须安装)
elasticsearch-head是Elasticsearch的图形化界面,方便用户对数据进行增删改查,基于REST的进行数据交互。
head插件维护地址:https://github.com/mobz/elasticsearch-head
直接使用docker启动head
docker run -p : mobz/elasticsearch-head:
访问:
3、安装kibana
3.1解压
[root@linux01 ~]# tar xf kibana-6.8.-linux-x86_64.tar.gz

[root@linux01 ~]# mv kibana-6.8.-linux-x86_64 /usr/local/kibana
3.2修改配置文件
[root@linux01 ~]# grep '^[a-Z]' /usr/local/kibana/config/kibana.yml

server.port:

server.host: "0.0.0.0"  #监听地址

elasticsearch.hosts: ["http://192.168.100.163:9200"]   #es地址

kibana.index: ".kibana"  #在es中添加.kibana索引

i18n.locale: "zh-CN"  #设置为中文
3.3 后台运行 Kibana:
[root@linux01 ~]# /usr/local/kibana/bin/kibana &
3.4 浏览器访问:http://ip:5601
4、安装logstash
4.1解压文件
tar xf logstash-6.8..tar.gz

mv logstash-6.8. /usr/local/logstash
4.2新增测试配置文件
[root@linux01 ~]# cat /usr/local/logstash/config/logstash-sample.conf

input {

beats {

port => ""}

}

output {

elasticsearch {hosts => "192.168.100.163:9200" } #elasticsearch服务地址

stdout { codec=> rubydebug }

}
4.3 启动
[root@linux01 config]# /usr/local/logstash/bin/logstash -f /usr/local/logstash/config/logstash-sample.conf
5、安装filebeats
5.1解压
[root@linux01 ~]# tar xf filebeat-6.8.-linux-x86_64.tar.gz

[root@linux01 ~]# mv filebeat-6.8.-linux-x86_64 /usr/local/filebeat
5.2修改配置文件
cd /usr/local/filebeat/

vim filebeat.yml

#=========================== Filebeat inputs ====================

filebeat.inputs:

# Each - is an input. Most options can be set at the input level, so

# you can use different inputs for various configurations.

# Below are the input specific configurations.

- type: log

  # Change to true to enable this input configuration.

  enabled: true   #注意是否为true

  # Paths that should be crawled and fetched. Glob based paths.

  paths:

    - /var/log/messages   #收集日志路径

    #- c:\programdata\elasticsearch\logs\*

  # Exclude lines. A list of regular expressions to match. It drops the lines that are

  # matching any regular expression from the list.

  #exclude_lines: ['^DBG']

#-------------------------- Elasticsearch output ------------------------------

# Elasticsearch这部分全部注释掉

#output.elasticsearch:

  # Array of hosts to connect to.

  #hosts: ["localhost:9200"]

#----------------------------- Logstash output --------------------------------

output.logstash:    #去掉注释

  # The Logstash hosts

  hosts: ["192.168.100.163:5044"]   #logstash地址
filebeat.yml 配置的主要有两个部分,一个是日志收集,一个是日志输出的配置。
配置解释:
type: log 读取日志文件的每一行(默认)
enabled: true 该配置是否生效,如果改为false,将不收集该配置的日志
paths: 要抓取日志的全路径
fields: 自定义属性,可以定义多个,继续往下排就行
multiline.pattern: 正则表达式
multiline.negate: true 或 false;默认是false,匹配pattern的行合并到上一行;true,不匹配pattern的行合并到上一行
multiline.match: after 或 before,合并到上一行的末尾或开头
exclude_lines: ['DEBUG'] 该属性配置不收集DEBUG级别的日志,如果配置多行 这个配置也要放在多行的后面
192.168.100.163:5044 为输出到Logstash的地址和端口。
5.3
启动服务
./filebeat -e -c filebeat.yml
5.4 添加索引到kibana

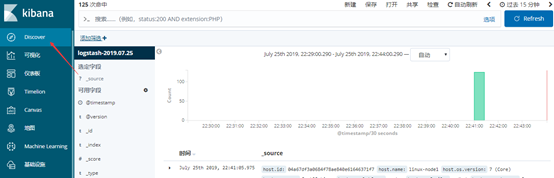
至此ELK+Filebeat已全部连通
ELk架构解析和部署的更多相关文章
- 万字长文:ELK(V7)部署与架构分析
ELK(7版本)部署与架构分析 1.ELK的背景介绍与应用场景 在项目应用运行的过程中,往往会产生大量的日志,我们往往需要根据日志来定位分析我们的服务器项目运行情况与BUG产生位置.一般情况下直接在日 ...
- ELK(V7)部署与架构分析
1.ELK的背景介绍与应用场景 在项目应用运行的过程中,往往会产生大量的日志,我们往往需要根据日志来定位分析我们的服务器项目运行情况与BUG产生位置.一般情况下直接在日志文件中tailf. grep. ...
- ELK 架构之 Elasticsearch 和 Kibana 安装配置
阅读目录: 1. ELK Stack 简介 2. 环境准备 3. 安装 Elasticsearch 4. 安装 Kibana 5. Kibana 使用 6. Elasticsearch 命令 最近在开 ...
- ELK学习笔记之ELK架构与介绍
0x00 为什么用到ELK 一般我们需要进行日志分析场景:直接在日志文件中 grep.awk 就可以获得自己想要的信息.但在规模较大的场景中,此方法效率低下,面临问题包括日志量太大如何归档.文本搜索太 ...
- Magento的基本架构解析
Magento的基本架构解析 magento 是在Zend框架基础上建立起来的,这点保证了代码的安全性及稳定性.选择Zend的原因有很多,但是最基本的是因为 zend框架提供了面向对象的代码库并且有很 ...
- Hadoop工程包架构解析
Hadoop源码解析 1 --- Hadoop工程包架构解析 1 Hadoop中各工程包依赖简述 Google的核心竞争技术是它的计算平台.Google的大牛们用了下面5篇文章,介绍了它们的计算 ...
- OpenStack最新版本Folsom架构解析
OpenStack最新版本Folsom架构解析摘要:OpenStack的第6版,版本代号为Folsom的最新版于今年九月底正式发布,Folsom将支持下一代软件定义网络(SDN)作为其核心组成部分.F ...
- ELK 架构之 Logstash 和 Filebeat 安装配置
上一篇:ELK 架构之 Elasticsearch 和 Kibana 安装配置 阅读目录: 1. 环境准备 2. 安装 Logstash 3. 配置 Logstash 4. Logstash 采集的日 ...
- ELK 架构之 Logstash 和 Filebeat 配置使用(采集过滤)
相关文章: ELK 架构之 Elasticsearch 和 Kibana 安装配置 ELK 架构之 Logstash 和 Filebeat 安装配置 ELK 使用步骤:Spring Boot 日志输出 ...
随机推荐
- Vue $root、$parent、$refs
Vue处理边界parent.$refs 下面的功能都是有风险的,尽量避免使用 Vue 子组件可以通过 $root 属性访问父组件实例的属性和方法 <div id="app"& ...
- win10激活方法 windows 10 最简单的激活方法
1.首先,要用管理员权限打开cmd命令行窗口,可以搜索框中输入“cmd”,在出现的“命令行提示符”,图标上右击“以管理员身份运行”. 2.为了让其它激活工具的密钥清除,先卸载密钥,在命令行输入 ...
- oracle基本语句(第七章、数据库逻辑对象管理)
索引.实体化视图.簇.散列簇.序列.同义词 1.创建表 CREATE TABLE <表名>(<列名1> <数据类型>,……); CREATE GLOBAL TEMP ...
- package.json文件
http://javascript.ruanyifeng.com/nodejs/packagejson.html#toc7(copy) 通常我们使用npm init命令来创建一个npm程序时,会自动生 ...
- Halcon10.0 + VS2010
新建一个C++空项目 添加c1.pp 复制example1.cpp的代码 配置include\lib\bin\Linker之后
- jdbcTemplate进行CRUD,查询结果转json
通过Spring的jdbcTemplate作为dao层的框架,将获取到的字段名,及其值,通过put放在jsonObject或jsonArray中,将json返回. public class Sprin ...
- Spring Cloud云架构 - SSO单点登录之OAuth2.0 根据token获取用户信息(4)
上一篇我根据框架中OAuth2.0的使用总结,画了SSO单点登录之OAuth2.0 登出流程,今天我们看一下根据用户token获取yoghurt信息的流程: /** * 根据token获取用户信息 * ...
- Oracle数据库锁表查询
--查看数据库最大连接数 select value from v$parameter where name = 'processes'; --更改数据库连接数 alter system scope = ...
- [CSP-S模拟测试]:旅行计划(分块+DP)
题目传送门(内部题83) 输入格式 第一行两个整数$n,m$ 接下来$m$行,每行三个整数,$u,v,w$,表示从$u$到$v$有一条权值为$w$的边 接下来一行有一个整数$q$,表示$q$天 接下来 ...
- maven 配置私服 连接
两种方法: 1.在单个项目的pom.xml中使用 私服的连接地址,这样只对该项目起作用. 2.在maven的setting.xml配置中添加私服的连接地址.这样对所有项目起作用. 本文章只演示第二种方 ...