
汇编学习:float与double速度问题
X86处理器包含两种类型的浮点数寄存器。第一种使用8个浮点寄存器组成浮点寄存器栈,另一种为向量寄存器(XMM,YMM),它们对于单双精度的处理是不同的。本文将讨论两种模式下的浮点数计算速度问题。
一、当我们编译32位程序时,使用的是x87指令集,即使用浮点寄存器堆栈进行浮点计算。此种情况下,单精度与双精度的处理是统一的,故计算速度上没有差异。我们可以做如下验证:
float a,b,c;

c=a*b;

汇编:

fld         dword ptr [a]  //将a加载到浮点栈顶,即ST(0)=a;

fmul        dword ptr [b]  //将栈顶元素与b相乘,结果仍存于栈顶,即ST(0)=ST(0)*b

fstp        dword ptr [c]  //将栈顶元素弹出并保存于c,即c=ST(0),POP();
double  a,b,c;

c=a*b;

汇编:

fld         qword ptr [a]

fmul        qword ptr [b]

fstp        qword ptr [c]
可以发现,上述两段代码的汇编代码完全相同.
因此,此种情况下,float与double的计算速度没有差异。在精度满足要求的情况下,可以使用float以便加载更多数据到cache,以提高cache命中率。
二、当编译64 位程序或打开MMX ,SSE,AVX指令集优化时,则使用向量寄存器。在此情况下,float与double的处理使用的是不同汇编指令,关于二者的计算速度,可以参考《Optimizing software in C++》中的一段话:
Single precision division, square root and mathematical functions are calculated faster than double precision when the XMM registers are used, while the speed of addition, subtraction, multiplication, etc. is still the same regardless of precision on most processors (when vector operations are not used).
意思是当使用XMM寄存器时,单精度浮点的除法、开根及一些数学函数的执行要比双精度快,但加法,减法、乘法的计算速度二者没有差异(在没有使用向量操作时)。
此处的向量操作指SIMD,即单指令多数据流。基本思想是将若干个数据加载到一个寄存器内部,一条指令可以同时处理多个数据,一个XMM(128位)可同时装载4个double或8个float,因此在使用SIMD时,一次处理的float数据量为double的两倍。
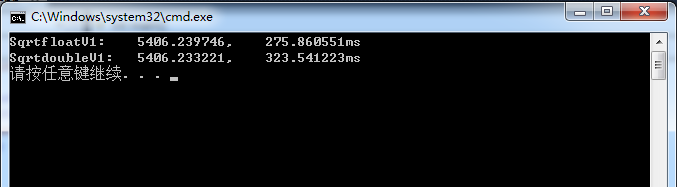
为了验证64位程序中的float和double的速度差异,下面给出测试程序:
float SqrtfloatV1(float *A,const int len)

{

    float fSum=;

    for (int i=;i<len;i++)

    {

        fSum+=sqrt(A[i]);

    }

    return fSum;

}

double SqrtdoubleV1(double *A,const int len)

{

    double dSum=;

    for(int i=;i<len;i++)

    {

        dSum+=sqrt(A[i]);

    }

    return dSum;

}
测试结果:
注意事项:
一、浮点数到整数(直接截断)的转换是很低效的,使用浮点堆栈(32位程序)时需要调用函数_ftol2_sse.
double  a,b;

int c;

c=a*b;

汇编:

fld         qword ptr [a]

fmul        qword ptr [b]

call        @ILT+(__ftol2_sse) (0EC10CDh) //调用函数_ftol2_sse实现浮点数到整数的转换

mov         dword ptr [c],eax
使用XMM寄存器(64位程序)需要指令cvttsd2si:
double  a,b;

int c;

c=a*b;

汇编:

movsd       xmm0,mmword ptr [a]

mulsd       xmm0,mmword ptr [b]

cvttsd2si   eax,xmm0  //cvttsd2si指令实现

mov         dword ptr [c],eax
下面是测试程序,对一个浮点数组求和:
float AddfloatV1(float *A,const int len)

{

    int iSum=;

    for (int i=;i<len;i++)

    {

        iSum+=A[i];//转成整数再求和

    }

    return (float)iSum;

}

float AddfloatV2(float *A,const int len)

{

    float fSum=;

    for (int i=;i<len;i++)

    {

        fSum+=A[i];

    }

    return fSum;

}
对于32位程序,测试结果如下:

于64位程序,测试结果如下:
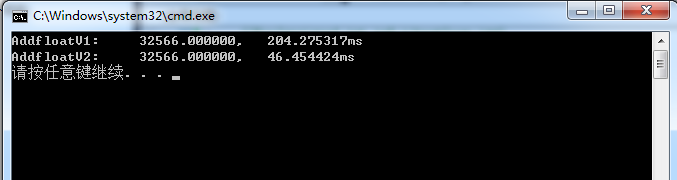
可以看出不管是32位还是64位程序,将浮点数转为整数再求和都会造成效率的大大降低。
关于浮点转整数的优化的讨论,可以参考一篇博文[1].
二、使用XMM寄存器(即当编译64位程序或打开SSE2指令集时),应避免float与double混用,因为编译器需要在计算过程中进行转换。如下:
(1)float与double混用(默认的浮点常量为double)
float a,b;

a=b*1.2;

汇编

movd        xmm0,dword ptr [b]

cvtps2pd    xmm0,xmm0

mulsd       xmm0,mmword ptr [__real@3ff3333333333333 (13F646790h)]

cvtsd2ss    xmm0,xmm0

movss       dword ptr [a],xmm0
(2)纯float
float a,b;

a=b*1.2f;

汇编

movss       xmm0,dword ptr [b]

mulss       xmm0,dword ptr [__real@3f99999a (13F84678Ch)]

movss       dword ptr [a],xmm0
可以看到,(1)中多了两个指令,即cvtps2pd,cvtsd2ss,它们分别实现float转double,double转float。
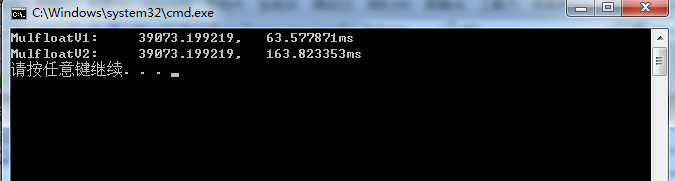
下面是一段测试程序:
float MulfloatV1(float *A,const int len)

{

    float fSum=;

    for (int i=;i<len;i++)

    {

        fSum+=A[i]*1.2f;

    }

    return fSum;

}

float MulfloatV2(float *A,const int len)

{

    float fSum=;

    for (int i=;i<len;i++)

    {

        fSum+=A[i]*1.2;//默认的浮点常数是double

    }

    return fSum;

}
测试结果:
完整的测试程序:
#include <stdio.h>

#include <time.h>

#include <stdlib.h>

#include <math.h>

#include "Timing.h"

const int BUFSIZE =;

float buf[BUFSIZE];

double buf2[BUFSIZE];

//测试64位下float与double的速度差

float SqrtfloatV1(float *A,const int len);

double SqrtdoubleV1(double *A,const int len);

//测试浮点数转整数的速度

float AddfloatV1(float *A,const int len);

float AddfloatV2(float *A,const int len);

//测试64位下float与double混用速度

float MulfloatV2(float *A,const int len);

float MulfloatV1(float *A,const int len);

int main()

{

    const int testloop=;

    double interval;

    srand( (unsigned)time( NULL ) );

    for (int i = ; i < BUFSIZE; i++)

    {

        buf[i] = (float)(rand() & 0x3f);

        buf2[i]= (double)(buf[i]);

    }

    //*****************************************************************//

    //测试64位下float与double的速度差(32位无明显差异)

    volatile float result1=;

    startTiming();

    for(unsigned int i=;i<testloop;i++)

    {

        result1=SqrtfloatV1(buf,BUFSIZE);

    }

    interval=stopTiming();

    printf("SqrtfloatV1:\t%f,\t%lfms\n",result1,interval);

    volatile double result2=;

    startTiming();

    for(unsigned int i=;i<testloop;i++)

    {

        result2=SqrtdoubleV1(buf2,BUFSIZE);

    }

    interval=stopTiming();

    printf("SqrtdoubleV1:\t%lf,\t%lfms\n",result2,interval);

    //*****************************************************************//

    //*****************************************************************//

    //测试浮点数转整数的速度(32为与64位均有明显差异)

    volatile float result3=;

    startTiming();

    for(unsigned int i=;i<testloop;i++)

    {

        result3=AddfloatV1(buf,BUFSIZE);

    }

    interval=stopTiming();

    printf("AddfloatV1:\t%f,\t%lfms\n",result3,interval);

    volatile float result4=;

    startTiming();

    for(unsigned int i=;i<testloop;i++)

    {

        result4=AddfloatV2(buf,BUFSIZE);

    }

    interval=stopTiming();

    printf("AddfloatV2:\t%f,\t%lfms\n",result4,interval);

    //*****************************************************************//

    //*****************************************************************//

    //测试64位下float与double混用速度(32位无差异,因统一处理)

    volatile float result5=;

    startTiming();

    for(unsigned int i=;i<testloop;i++)

    {

        result5=MulfloatV1(buf,BUFSIZE);

    }

    interval=stopTiming();

    printf("MulfloatV1:\t%f,\t%lfms\n",result5,interval);

    volatile float result6=;

    startTiming();

    for(unsigned int i=;i<testloop;i++)

    {

        result6=MulfloatV2(buf,BUFSIZE);

    }

    interval=stopTiming();

    printf("MulfloatV2:\t%f,\t%lfms\n",result6,interval);

    //*****************************************************************//

    return ;

}

float SqrtfloatV1(float *A,const int len)

{

    float fSum=;

    for (int i=;i<len;i++)

    {

        fSum+=sqrt(A[i]);

    }

    return fSum;

}

double SqrtdoubleV1(double *A,const int len)

{

    double dSum=;

    for(int i=;i<len;i++)

    {

        dSum+=sqrt(A[i]);

    }

    return dSum;

}

float AddfloatV1(float *A,const int len)

{

    int iSum=;

    for (int i=;i<len;i++)

    {

        iSum+=A[i];//转成整数再求和

    }

    return (float)iSum;

}

float AddfloatV2(float *A,const int len)

{

    float fSum=;

    for (int i=;i<len;i++)

    {

        fSum+=A[i];

    }

    return fSum;

}

float MulfloatV1(float *A,const int len)

{

    float fSum=;

    for (int i=;i<len;i++)

    {

        fSum+=A[i]*1.2f;

    }

    return fSum;

}

float MulfloatV2(float *A,const int len)

{

    float fSum=;

    for (int i=;i<len;i++)

    {

        fSum+=A[i]*1.2;//默认的浮点常数是double

    }

    return fSum;

}
参考:
[1]http://blog.csdn.net/housisong/article/details/1616026
汇编学习:float与double速度问题的更多相关文章
- 从数据表字段 float 和 double 说起
今天在公司讨论项目重构的问题时,公司的 DBA 针对表中的字段大概介绍了一下 float 和 double 的存储方式.然后,我发现这个问题又回到了浮点数类型在内存中的存储方式,即 IEEE 对浮点数 ...
- 第48条:如果需要精确的答案,请避免使用float和double
float和double主要为了科学计算和工程计算而设计,执行二进制浮点运算,这是为了在广泛的数值范围上提供较为精确的快速近似计算而精心设计的.然而,它们没有提供完全精确的结果,所以不适合用于需要精确 ...
- 【转】JAVA程序中Float和Double精度丢失问题
原文网址:http://blog.sina.com.cn/s/blog_827d041701017ctm.html 问题提出:12.0f-11.9f=0.10000038,"减不尽" ...
- Effective Java 第三版——60. 需要精确的结果时避免使用float和double类型
Tips 书中的源代码地址:https://github.com/jbloch/effective-java-3e-source-code 注意,书中的有些代码里方法是基于Java 9 API中的,所 ...
- Sql的decimal、float、double类型的区别
三者的区别介绍 float:浮点型,含字节数为4,32bit,数值范围为-3.4E38~3.4E38(7个有效位) double:双精度实型,含字节数为8,64bit数值范围-1.7E308~1.7E ...
- float和double的精度
作者: jillzhang 联系方式:jillzhang@126.com 原网址:http://blog.csdn.net/wuna66320/article/details/1691734 1 范围 ...
- float和double精度问题
System.out.println(new BigDecimal(253.90).doubleValue() * 100);25390.0精度正确 System.out.println(new Bi ...
- float和double在内存中的存储方式
本文转载于:http://wenku.baidu.com/link?url=ARfMiXVHCwCZJcqfA1gfeVkMOj9RkLlR9fIexbgs9gDdV8rIS48A1_xe1y6YgX ...
- float、double的有效位数
Java中的浮点类型有两类,分别是float和double类型,其中float取_7__位有效数据,double取_15__位有效数据
随机推荐
- 一个非常棒的html5框架-ionic
http://ionicframework.com/ 之前用过app.js,相比ionic,真是弱爆了! http://learn.ionicframework.com/formulas/ 上面的链接 ...
- 源代码目录结构--AngularJS学习笔记(一)
最近开始接触AngularJS,确实是一个相当不错的东西,可以把很多东西简化掉.又对于其中的双向绑定等的实现很好奇,加之正在学习Javascript的东西,所以觉得从源代码这块开始深入学习Angula ...
- AWVS漏洞测试-01节-AWVS的主要作用
AWVS漏洞工具简单介绍 AWVS全称: Acunetix Web Vulnerability Scanner 中文翻译就是:Acunetix网站攻击扫描器 扫描网站漏洞,通过网络爬虫Crawler的 ...
- ViewPager中使用PhotoView时出现pointerIndex out of range异常
问题描述: 当PhotoView 和 ViewPager 组合时 ,用双指进行放大时 是没有问题的,但是用双指进行缩小的时候,程序就会崩掉,并且抛出java.lang.IllegalArgumentE ...
- Ehcache 使用
自从Ehcache 到了1.2+的版本,就支持分布式缓存了 Spring + Hibernate的结构 ,ehcache的对这几个框架的支持较好,就采用这个缓存方案 下面是配置文件: <ehca ...
- Sass for循环中编译%时报错解决方案
sass功能强大,特别是支持for循环,节省大量开发时间,但是在开发时遇到一个问题,直接使用%时没有问题,当有变量时再加% 单位在编译时报错: 这样没有问题: @for $width from 0 t ...
- 在使用sqlite时淌过的坑
以前一直用sqlite.net 1.0.66.0版本,在.net4下面程序写好了部署到目的地机器时winform程序总是出现缺少运行时的问题.有时装了运行时也还是出问题,后来发现是混合模式的问题,当时 ...
- WCF多种调用方式兼容
1.能被ajax get 2.能post 3.wcf正常调用 实现: [AspNetCompatibilityRequirements(RequirementsMode = AspNetCompati ...
- nginx重定向规则入门
nginx重定向规则的入门实例 时间:2015-12-17 15:18:03来源:网络 导读:nginx重定向规则,Nginx的重定向模块HttpRewriteModule的用法说明,nginx重定向 ...
- CM: 如何自己build一个官方版本出来,使用官方release中的manifests.xml
This can be accomplished in one of two ways: 1) Pull the file from your device:cd /your/repo/pathadb ...