
关于Java序列化和Hadoop的序列化
 import java.io.DataInput;

 import java.io.DataOutput;

 import java.io.DataOutputStream;

 import java.io.FileOutputStream;

 import java.io.IOException;

 import java.io.ObjectOutputStream;

 import java.io.Serializable;

 import org.apache.hadoop.io.Writable;

 public class Test2 {

     public static void main(String[] args) throws IOException {

         Student stu = new Student(1, "张三");

         FileOutputStream fileOutputStream = new FileOutputStream("d:/111");

         ObjectOutputStream objectOutputStream = new ObjectOutputStream(fileOutputStream);

         objectOutputStream.writeObject(stu);

         objectOutputStream.close();

         fileOutputStream.close();

         //我们一般只关注stu对象的id和name两个属性总共12个字节.但是Java的序列化到硬盘上的文件有175个字节.

         //Java序列化了很多没有必要的信息.如果要序列化的数据有很多,那么序列化到磁盘上的数据会更多,非常的浪费.

         //Hadoop没有使用Java的序列化机制.如果采用会造成集群的网络传输的时间和流量都集聚的增长.

         //Hadoop中自己定义了一个序列化的接口Writable.

         //Java序列化中之所以信息多是因为把 类之间的的继承多态信息都包含了.

         StuWritable stu2 = new StuWritable(1, "张三");

         FileOutputStream fileOutputStream2 = new FileOutputStream("d:/222");

         DataOutputStream dataOutputStream2 = new DataOutputStream(fileOutputStream2);

         stu2.write(dataOutputStream2);

         fileOutputStream2.close();

         dataOutputStream2.close();

     }

 }

 class Student implements Serializable{

     private Integer id;

     private String name;

     public Student() {

         super();

     }

     public Student(Integer id, String name) {

         super();

         this.id = id;

         this.name = name;

     }

     public Integer getId() {

         return id;

     }

     public void setId(Integer id) {

         this.id = id;

     }

     public String getName() {

         return name;

     }

     public void setNameString(String name) {

         this.name = name;

     }

 }

 class StuWritable  implements Writable{

     private Integer id;

     private String name;

     public StuWritable() {

         super();

     }

     public StuWritable(Integer id, String name) {

         super();

         this.id = id;

         this.name = name;

     }

     public Integer getId() {

         return id;

     }

     public void setId(Integer id) {

         this.id = id;

     }

     public String getName() {

         return name;

     }

     public void setNameString(String name) {

         this.name = name;

     }

     public void write(DataOutput out) throws IOException {

         out.writeInt(id);

         out.writeUTF(name);

     }

     public void readFields(DataInput in) throws IOException {

         this.id = in.readInt();

         this.name = in.readUTF();

     }

 }
使用Java序列化接口对应的磁盘上的文件: 共175个字节

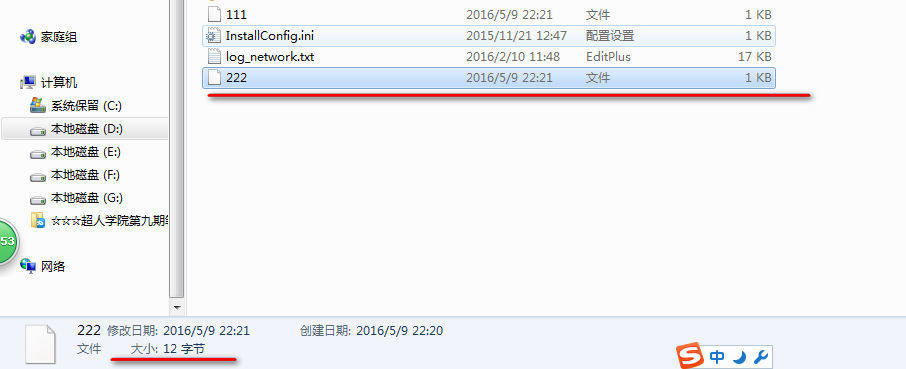
使用Hadoop序列化机制对应的磁盘文件: 共12字节
如果类中有继承关系:
 import java.io.DataInput;

 import java.io.DataOutput;

 import java.io.DataOutputStream;

 import java.io.FileOutputStream;

 import java.io.IOException;

 import java.io.ObjectOutputStream;

 import java.io.Serializable;

 import org.apache.hadoop.io.Writable;

 public class Test2 {

     public static void main(String[] args) throws IOException {

         //我们一般只关注stu对象的id和name两个属性总共12个字节.但是Java的序列化到硬盘上的文件有175个字节.

         //Java序列化了很多没有必要的信息.如果要序列化的数据有很多,那么序列化到磁盘上的数据会更多,非常的浪费.

         //Hadoop没有使用Java的序列化机制.如果采用会造成集群的网络传输的时间和流量都集聚的增长.

         //Hadoop中自己定义了一个序列化的接口Writable.

         //Java序列化中之所以信息多是因为把 类之间的的继承多态信息都包含了.再重新构建的时候可以保持原有的关系.

         StuWritable stu2 = new StuWritable(1, "张三");

         stu2.setSex(true);

         FileOutputStream fileOutputStream2 = new FileOutputStream("d:/222");

         DataOutputStream dataOutputStream2 = new DataOutputStream(fileOutputStream2);

         stu2.write(dataOutputStream2);

         fileOutputStream2.close();

         dataOutputStream2.close();

     }

 }

 class StuWritable extends Person implements Writable{

     private Integer id;

     private String name;

     public StuWritable() {

         super();

     }

     public StuWritable(Integer id, String name) {

         super();

         this.id = id;

         this.name = name;

     }

     public Integer getId() {

         return id;

     }

     public void setId(Integer id) {

         this.id = id;

     }

     public String getName() {

         return name;

     }

     public void setNameString(String name) {

         this.name = name;

     }

     public void write(DataOutput out) throws IOException {

         out.writeInt(id);

         out.writeBoolean(super.isSex());

         out.writeUTF(name);

     }

     public void readFields(DataInput in) throws IOException {

         this.id = in.readInt();

         super.setSex(in.readBoolean());

         this.name = in.readUTF();

     }

 }

 class Person{

     private boolean sex;

     public boolean isSex() {

         return sex;

     }

     public void setSex(boolean sex) {

         this.sex = sex;

     }

 }
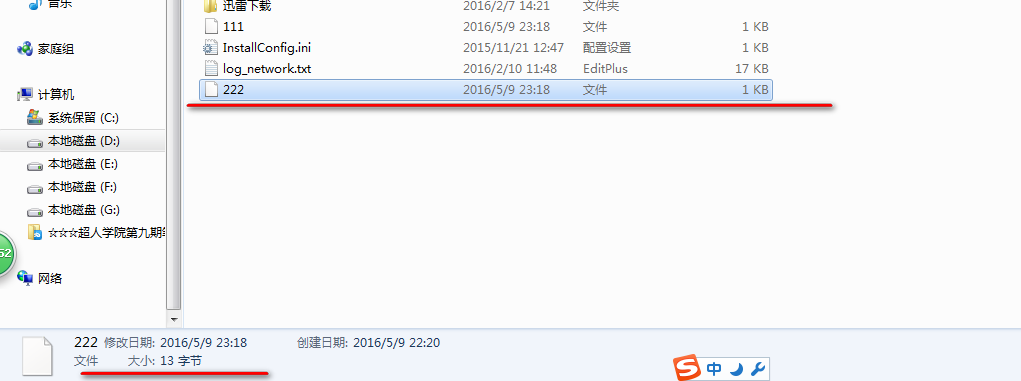
这样序列化到磁盘上的文件: 13个字节 多了一个boolean属性,相比上面多了一个字节.
如果实例化对象中含有类对象.
 import java.io.DataInput;

 import java.io.DataOutput;

 import java.io.DataOutputStream;

 import java.io.FileOutputStream;

 import java.io.IOException;

 import java.io.ObjectOutputStream;

 import java.io.Serializable;

 import org.apache.hadoop.io.Writable;

 public class Test2 {

     public static void main(String[] args) throws IOException {

         //我们一般只关注stu对象的id和name两个属性总共12个字节.但是Java的序列化到硬盘上的文件有175个字节.

         //Java序列化了很多没有必要的信息.如果要序列化的数据有很多,那么序列化到磁盘上的数据会更多,非常的浪费.

         //Hadoop没有使用Java的序列化机制.如果采用会造成集群的网络传输的时间和流量都集聚的增长.

         //Hadoop中自己定义了一个序列化的接口Writable.

         //Java序列化中之所以信息多是因为把 类之间的的继承多态信息都包含了.再重新构建的时候可以保持原有的关系.

         StuWritable stu2 = new StuWritable(1, "张三");

         stu2.setSex(true);

         FileOutputStream fileOutputStream2 = new FileOutputStream("d:/222");

         DataOutputStream dataOutputStream2 = new DataOutputStream(fileOutputStream2);

         stu2.write(dataOutputStream2);

         fileOutputStream2.close();

         dataOutputStream2.close();

     }

 }

 class StuWritable extends Person implements Writable{

     private Integer id;

     private String name;

     private Student student;

     public StuWritable() {

         super();

     }

     public StuWritable(Integer id, String name) {

         super();

         this.id = id;

         this.name = name;

     }

     public Integer getId() {

         return id;

     }

     public void setId(Integer id) {

         this.id = id;

     }

     public String getName() {

         return name;

     }

     public void setNameString(String name) {

         this.name = name;

     }

     public void write(DataOutput out) throws IOException {

         out.writeInt(id);

         out.writeBoolean(super.isSex());

         out.writeUTF(name);

         out.writeInt(student.getId());

         out.writeUTF(student.getName());

     }

     public void readFields(DataInput in) throws IOException {

         this.id = in.readInt();

         super.setSex(in.readBoolean());

         this.name = in.readUTF();

         this.student = new Student(in.readInt(),in.readUTF());

     }

 }

 class Person{

     private boolean sex;

     public boolean isSex() {

         return sex;

     }

     public void setSex(boolean sex) {

         this.sex = sex;

     }

 }
如果我们Student中有个字段是Writable类型的.
怎么样序列化?
关于Java序列化和Hadoop的序列化的更多相关文章
- 为什么hadoop中用到的序列化不是java的serilaziable接口去序列化而是使用Writable序列化框架
继上一个模块之后,此次分析的内容是来到了Hadoop IO相关的模块了,IO系统的模块可谓是一个比较大的模块,在Hadoop Common中的io,主要包括2个大的子模块构成,1个是以Writable ...
- Hadoop 的序列化
1. 序列化 1.1 序列化与反序列化的概念 序列化:是指将结构化对象转化成字节流在网上传输或写到磁盘进行永久存储的过程 反序列化:是指将字节流转回结构化对象的逆过程 1.2 序列化的应用 序列化用于 ...
- Hadoop基础-序列化与反序列化(实现Writable接口)
Hadoop基础-序列化与反序列化(实现Writable接口) 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 一.序列化简介 1>.什么是序列化 序列化也称串行化,是将结构化 ...
- 大数据框架hadoop的序列化机制
Java内建序列化机制 在Windows系统上序列化的Java对象,可以在UNIX系统上被重建出来,不需要担心不同机器上的数据表示方法,也不需要担心字节排列次序. 在Java中,使一个类的实例可被序列 ...
- java中可定制的序列化过程 writeObject与readObject
来源于:[http://bluepopopo.iteye.com/blog/486548] 什么是writeObject 和readObject?可定制的序列化过程 这篇文章很直接,简单易懂.尝试着翻 ...
- java io系列06之 序列化总结(Serializable 和 Externalizable)
本章,我们对序列化进行深入的学习和探讨.学习内容,包括序列化的作用.用途.用法,以及对实现序列化的2种方式Serializable和Externalizable的深入研究. 转载请注明出处:http: ...
- spring mvc返回json字符串数据,只需要返回一个java bean对象就行,只要这个java bean 对象实现了序列化serializeable
1.spring mvc返回json数据,只需要返回一个java bean对象就行,只要这个java bean 对象实现了序列化serializeable 2. @RequestMapping(val ...
- Java中对文件的序列化和反序列化
public class ObjectSaver { public static void main(String[] args) throws Exception { /*其中的 D:\\objec ...
- Java复习——I/O与序列化
File类 java.io.File只用于表示文件(目录)的信息(名称.大小等),不能用于文件内容的访问,我们可以通过通过给其构造函数传一个路径来构建以文件,传入的路径名有一个小问题,就是Window ...
随机推荐
- Apache Spark Streaming的简介
Spark Streaming通过将流数据按指定时间片累积为RDD,然后将每个RDD进行批处理,进而实现大规模的流数据处理.其吞吐量能够超越现有主流流处理框架Storm,并提供丰富的API用于流数据计 ...
- DBMS_ERRLOG记录DML错误日志(二)
上一篇简单介绍了DML记录语句的限制,虽然所有的例子都是利用INSERT语句,但是LOG ERRORS语句并没有这个限制,UPDATE.DELETE和MERGE都可以使用这个语句.下面要说的就是这篇的 ...
- linux下面的查找命令
在linux下面经常用查找命令,我自己最常用的是find whereis locate 关于find 我常用find的基本功能,如 find / -name filename 在某个目录下寻找文件. ...
- hdu 2824 The Euler function
The Euler function Time Limit: 2000/1000 MS (Java/Others) Memory Limit: 32768/32768 K (Java/Other ...
- Java NIO类库Selector机制解析(下)
五. 迷惑不解 : 为什么要自己消耗资源? 令人不解的是为什么我们的Java的New I/O要设计成这个样子?如果说老的I/O不能多路复用,如下图所示,要开N多的线程去挨个侦听每一个Channel ...
- 用6个字符写出任意的Javascript代码
博客搬到了fresky.github.io - Dawei XU,请各位看官挪步.最新的一篇是:用6个字符写出任意的Javascript代码.
- python常用字符串操作
#!/usr/bin/env python name='cunzhang' print(name.capitalize())#首字母大写 print(name.count('n'))#统计字符有几个 ...
- squid添加用户名密码认证
国内私募机构九鼎控股打造APP,来就送 20元现金领取地址:http://jdb.jiudingcapital.com/phone.html 内部邀请码:C8E245J (不写邀请码,没有现金送) 国 ...
- Hyper-V故障转移群集
Hyper-V故障转移群集配置完成后,在故障转移群集管理器中新建虚机:角色-虚拟机-新建虚拟机 如果直接在Hyper-V管理器中新建虚机,则不是高可用,需要在故障转移群集管理器中将其添加进来使其成为高 ...
- python写的多线程下载工具
其实只是想练习一下threading的用法. 写完后发现其实下载速度也没增加多少,略显尴尬,汗 # -*- coding: cp936 -*- import urllib2 import thread ...