
Ubuntu16.04 hadoop 伪分布式 的文件配置
首先需要完成java环境的配置,这里就省略了。
完成 hadoop 伪分布(pesudo distribution),只需配置下面 五 个文件即可:
- hadoop-env.sh
- core-site.xml
- hdfs-site.xml
- yarn-site.xml
- mapred-site.xml
这些配置文件都在解压后的hadoop目录中的 etc/hadoop 目录下,下面是它们的具体作用和配置:
1 hadoop-env.sh
这个用来配置 Java 环境的路径,在hadoop-env.sh中找到这一行:
export JAVA_HOME=
并将等号后面的内容替换成自己的java环境路径即可,如果不确定,执行sudo update-alternatives --config java 就能看到了,如果安装了多个java环境,可以从这儿选择某一个,每个条目的路径就是所需的java环境了, 比如我的执行结果是这样的:
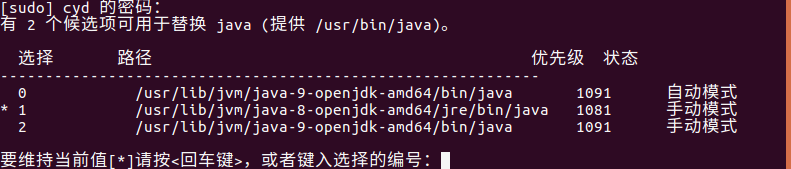
我目前用的是第二个条目的java环境,取bin之前的路径就是: /usr/lib/jvm/java-8-openjdk-amd64/jre
2 core-site.xml
指定HDFS的通信地址和缓存存储的路径:
在core-site.xml的 configure 中分别加入这些片段,如下:
<configuration>

<property>

        <name>fs.defaultFS</name>

        <value>hdfs://localhost:9000</value>

</property>

<property>

        <name>hadoop.tmp.dir</name>

        <value>/home/hadoop/hadoop_installs/tmp</value>

</property>

</configuration>
3 hdfs-site.xml
指定hdfs的副本数量,这里就假设是 1 个:
<configuration>

<property>

        <name>dfs.replication</name>

        <value>1</value>

</property>

</configuration>
4 yarn-site.xml
yarn 是hadoop的统一资源管理器:
<configuration>

<property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

</property>

<property>

        <name>yarn.resourcemanager.hostname</name>

        <value>localhost</value>

</property>

</configuration>
5 mapred-site.xml
mapred是一种计算模型, 这里就指定 它使用yarn 来管理资源
<configuration>

<property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

</property>

</configuration>
这里要把原来的mapred-site.xml.template 改成 mapred-site.xml 再编辑.
6 参考博客:
https://www.cnblogs.com/gyouxu/p/4183417.html
Ubuntu16.04 hadoop 伪分布式 的文件配置的更多相关文章
- Ubuntu16.04下伪分布式环境搭建之hadoop、jdk、Hbase、phoenix的安装与配置
一.准备工作 安装包链接: https://pan.baidu.com/s/1i6oNmOd 密码: i6nc 环境准备 修改hostname: $ sudo vi /etc/hostname why ...
- Data - Hadoop伪分布式配置 - 使用Hadoop2.8.0和Ubuntu16.04
系统版本 anliven@Ubuntu1604:~$ uname -a Linux Ubuntu1604 4.8.0-36-generic #36~16.04.1-Ubuntu SMP Sun Feb ...
- Hadoop伪分布式环境搭建+Ubuntu:16.04+hadoop-2.6.0
Hello,大家好 !下面就让我带大家一起来搭建hadoop伪分布式的环境吧!不足的地方请大家多交流.谢谢大家的支持 准备环境: 1, ubuntu系统,(我在16.04测试通过.其他版本请自行测试, ...
- 在Linux(Centos7)系统上对进行Hadoop分布式配置以及运行Hadoop伪分布式实例
在Linux(Centos7)系统上对进行Hadoop分布式配置以及运行Hadoop伪分布式实例 ...
- Linux下配置Hadoop伪分布式环境
1. 准备Linux环境 提示:我用的系统是CentOS 6.4. 1.0点击VMware快捷方式,右键打开文件所在位置 -> 双击vmnetcfg.exe -> VMnet1 host- ...
- Ubuntu15.10下Hadoop2.6.0伪分布式环境安装配置及Hadoop Streaming的体验
Ubuntu用的是Ubuntu15.10Beta2版本,正式的版本好像要到这个月的22号才发布.参考的资料主要是http://www.powerxing.com/install-hadoop-clus ...
- Hadoop伪分布式模式搭建
title: Hadoop伪分布式模式搭建 Quitters never win and winners never quit. 运行环境: Ubuntu18.10-server版镜像:ubuntu- ...
- Hadoop伪分布式集群环境搭建
本教程讲述在单机环境下搭建Hadoop伪分布式集群环境,帮助初学者方便学习Hadoop相关知识. 首先安装Hadoop之前需要准备安装环境. 安装Centos6.5(64位).(操作系统再次不做过多描 ...
- hadoop伪分布式平台搭建(centos 6.3)
最近要写一个数据量较大的程序,所以想搭建一个hbase平台试试.搭建hbase伪分布式平台,需要先搭建hadoop平台.本文主要介绍伪分布式平台搭建过程. 目录: 一.前言 二.环境搭建 三.命令测试 ...
随机推荐
- string中执行sql语句
Spring(JdbcTemplate.class)中的queryForMap().queryForObject().queryForLong().queryForInt()等方法都会去调用publi ...
- Sort HDU - 5884 哈夫曼权值O(n)
http://acm.hdu.edu.cn/showproblem.php?pid=5884 原来求一次哈夫曼可以有O(n)的做法. 具体是,用两个队列,一个保存原数组,一个保存k个节点合并的数值,然 ...
- 高可用数据同步方案-SqlServer迁移Mysql实战
简介 随着业务量的上升,以前的架构已经不满足业务的发展,数据作为业务中最重要的一环,需要有更好的架构作为支撑.目前我司有sql server转mysql的需求,所以结合当前业务,我挑选了阿里云开源的一 ...
- CentOS6.x之emacs安装配置编译
刚开始学习linux,干学没什么意思,想在linux下写写程序,了解到linux下使用较多的是emacs和vim,在youtobe上分别看了看这两个工具进行开发的视频,个人感觉emacs比较酷一点,所 ...
- case 范围取值
你可以在单个case标签中指定一系列连续的值,就像这样: case low ... high: 这和单独的case标签的合适数字有同样的效果,每个对应包含在从low到high中的一个整数值. 这个 ...
- HTML <pre> 标签
需求 错落有致的规则说明 ps.我真的是一个后端开发... pre 元素中的文本通常会保留空格和换行符.而文本也会呈现为等宽字体.
- ECShop配置文件解析
1. 配置文件位置:/upload/data/config.php 2. 配置解析 <?php // 主机地址 $db_host = ""; // 数据库名称 $db_nam ...
- git 如何生成 SSH 公钥
1.打开你的git bash 窗口 2.进入.ssh目录:cd ~/.ssh 3.找到id_rsa.pub文件:ls 4.查看公钥:cat id_rsa.pub 或者vim id_rsa.pub ...
- BZOJ3693: 圆桌会议(Hall定理 线段树)
题意 题目链接 Sol 好的又是神仙题... 我的思路:对于区间分两种情况讨论,一种是完全包含,另一种是部分包含.第一种情况非常好判断,至于计算对于一个区间[l, r]的$\sum a[i]$就可以了 ...
- PHP中XML和数组互相转换的方法
转换代码如下 //数组转XML function arrayToXml($arr) { $xml = "<xml>"; foreach ($arr as $key=&g ...