
Spark编程模型(下)
创建Pair RDD
什么是Pair RDD
- 包含键值对类型的RDD类型被称作Pair RDD;
- Pair RDD通常用来进行聚合计算;
- Pair RDD通常由普通RDD做ETL转化而来。
Python:

    pairs = lines.map(lambda x: (x.split(" ")[], x))

Scala:

    val pairs = lines.map(x => (x.split(" ")(), x))

Java:

    PairFunction<String, String, String> keyData = new PairFunction<String, String, String>() {

    public Tuple2<String, String> call(String x){

         return new Tuple(x.split(" ")[], x);

    }

};

    JavaPairRDD<String, String> pairs = lines.mapToPair(keyData);
Pair RDD的transformation操作
Pair RDD可以使用所有标准RDD上的转化操作(见博文Spark编程模型(中)),还提供了特有的转换操作。
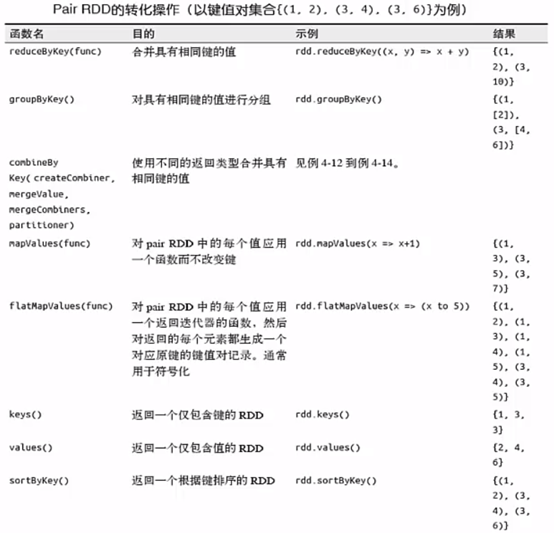
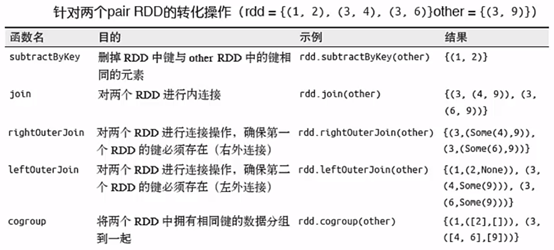
下面给大家示范一个操作,其它的自行去尝试。
[hadoop@masternode ~]$ cd /home/hadoop/app/spark-2.2./bin/

[hadoop@masternode bin]$ ./spark-shell  //进入Spark Shell模式

scala> val rdd = sc.parallelize(Array((,),(,),(,)))

rdd: org.apache.spark.rdd.RDD[(Int, Int)] = ParallelCollectionRDD[] at parallelize at <console>:

    //其中parallelize()方法的作用是从一个集合创建RDD,本例中时从一个Array()创建

scala> rdd.take()

res0: Array[(Int, Int)] = Array((,), (,), (,))

scala> rdd.reduceByKey((x,y)=>x+y).take()  //合并key相同的项

res3: Array[(Int, Int)] = Array((,), (,))
Pair RDD的action控制
所有的基础RDD支持的行动操作也都在Pair RDD上可用。

Pair RDD的分区控制
- Spark 中所有的键值对RDD 都可以进行分区控制---自定义分区
- 自定义分区的好处:
1)避免数据倾斜
2)控制task并行度
自定义分区方式:
class DomainNamePartitioner(numParts: Int) extends Partitioner {

    override def numPartitions: Int = numParts

    override def getPartition(key: Any): Int = {

        val domain = new Java.net.URL(key.toString).getHost()

        val code = (domain.hashCode % numPartitions)

        if(code < ) {

            code + numPartitions // 使其非负

        }else{

            code

        }

    }

    // 用来让Spark区分分区函数对象的Java equals方法

    override def equals(other: Any): Boolean = other match {

        case dnp: DomainNamePartitioner =>

            dnp.numPartitions == numPartitions

        case _ =>

            false

    }

}
以上就是博主为大家介绍的这一板块的主要内容,这都是博主自己的学习过程,希望能给大家带来一定的指导作用,有用的还望大家点个支持,如果对你没用也望包涵,有错误烦请指出。如有期待可关注博主以第一时间获取更新哦,谢谢!
Spark编程模型(下)的更多相关文章
- Spark编程模型(博主推荐)
福利 => 每天都推送 欢迎大家,关注微信扫码并加入我的4个微信公众号: 大数据躺过的坑 Java从入门到架构师 人工智能躺过的坑 Java全栈大联盟 ...
- Spark入门实战系列--3.Spark编程模型(下)--IDEA搭建及实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 . 安装IntelliJ IDEA IDEA 全称 IntelliJ IDEA,是java语 ...
- Spark入门实战系列--3.Spark编程模型(上)--编程模型及SparkShell实战
[注]该系列文章以及使用到安装包/测试数据 可以在<倾情大奉送--Spark入门实战系列>获取 .Spark编程模型 1.1 术语定义 l应用程序(Application): 基于Spar ...
- Spark:Spark 编程模型及快速入门
http://blog.csdn.net/pipisorry/article/details/52366356 Spark编程模型 SparkContext类和SparkConf类 代码中初始化 我们 ...
- Spark编程模型(RDD编程模型)
Spark编程模型(RDD编程模型) 下图给出了rdd 编程模型,并将下例中用 到的四个算子映射到四种算子类型.spark 程序工作在两个空间中:spark rdd空间和 scala原生数据空间.在原 ...
- Spark中文指南(入门篇)-Spark编程模型(一)
前言 本章将对Spark做一个简单的介绍,更多教程请参考:Spark教程 本章知识点概括 Apache Spark简介 Spark的四种运行模式 Spark基于Standlone的运行流程 Spark ...
- Spark编程模型几大要素
不多说,直接上干货! Spark编程模型几大要素 Driver Program 输入-Transformation-Action 缓存 共享变量
- 转载:Spark中文指南(入门篇)-Spark编程模型(一)
原文:https://www.cnblogs.com/miqi1992/p/5621268.html 前言 本章将对Spark做一个简单的介绍,更多教程请参考:Spark教程 本章知识点概括 Apac ...
- Spark编程模型
主要参考: Spark官方文档:http://spark.apache.org/docs/latest/programming-guide.html 炼数成金PPT:02Spark编程模型和解析 本文 ...
随机推荐
- ES6学习之字符串的扩展
字符的Unicode表示法 \uxxxx可以表示一个双字节的字符(xxxx表示字符编码,范围在0000---FFFF),超出此范围用两个双字节表示. console.log("\u0061& ...
- C#动态给EXCEL列添加下拉选项
Microsoft.Office.Interop.Excel.Application excel=new Microsoft.Office.Interop.Excel.Application(); M ...
- 13、Actor
1.介绍 Scala的Actor类似于Java中的多线程编程.但是不同的是,Scala的Actor提供的模型与多线程有所不同. Scala的Actor尽可能地避免锁和共享状态,从而避免多线程并发时出现 ...
- JavaScript学习系列6 -- JavaScript中的垃圾回收(内存释放)
程序开发中,涉及到的内存生命周期基本是一样的,分为以下三步 1. 分配需要的内存 2. 使用分配到的内存 3. 释放其内存 ----什么时候释放内存,以及需要释放哪些变量的内存, 就是垃圾回收机 ...
- Win10不能直接拖文件/Foxmail不能拖文件解决办法
在桌面新建一个文本文档 打开文本文档复制下面的文字然后保存. Windows Registry Editor Version 5.00 [HKEY_LOCAL_MACHINE\SOFTWARE\M ...
- 【本人译作推荐】Windows 8应用开发:C#和XAML卷(原名:Building Windows 8 Apps with C# and XAML)
[图书推荐] 译名:Windows 8应用开发:C#和XAML卷 原名:Building Windows 8 Apps with C# and XAML 编辑推荐 国内第一本使用XAML与C#语言 ...
- Ping++中的AlipaySDK和AlicloudUTDID冲突解决方案
今天维护一个老项目发现阿里框架冲突 问题截图: 解决方案: 去阿里文档中心 https://docs.open.alipay.com/54/104509 重新下载没有UTDID冲突的库 下载SDK解压 ...
- fs-hasher工具介绍
工具列表 hf-stat hf-simdex fs-hasher hf-stat工具 使用方法 以-f参数为例 Usage: ./hf-stat -f hashfile 参数用途 -f : 显示.ha ...
- 聚类算法(二)--BIRCH
BIRCH (balanced iterative reducing and clustering using hierarchies)(名字太长不用管了) 无监督,适合大样本的聚类方法.大多数情况只 ...
- http://lorempixel.com/ 可以快速产生假图
http://lorempixel.com/可以快速产生假图