
Spark学习进度-Spark环境搭建&Spark shell
Spark环境搭建
下载包
所需Spark包:我选择的是2.2.0的对应Hadoop2.7版本的,下载地址:https://archive.apache.org/dist/spark/spark-2.2.0/
Spark 集群高可用搭建
对于 Spark Standalone 集群来说, 当 Worker 调度出现问题的时候, 会自动的弹性容错, 将出错的 Task 调度到其它 Worker 执行
但是对于 Master 来说, 是会出现单点失败的, 为了避免可能出现的单点失败问题, Spark 提供了两种方式满足高可用
使用 Zookeeper 实现 Masters 的主备切换
使用文件系统做主备切换
Step 1 停止 Spark 集群
cd /export/servers/spark

sbin/stop-all.sh
Step 2 修改配置文件, 增加 Spark 运行时参数, 从而指定 Zookeeper 的位置
进入
spark-env.sh所在目录, 打开 vi 编辑cd /export/servers/spark/conf
vi spark-env.sh编辑
spark-env.sh, 添加 Spark 启动参数, 并去掉 SPARK_MASTER_HOST 地址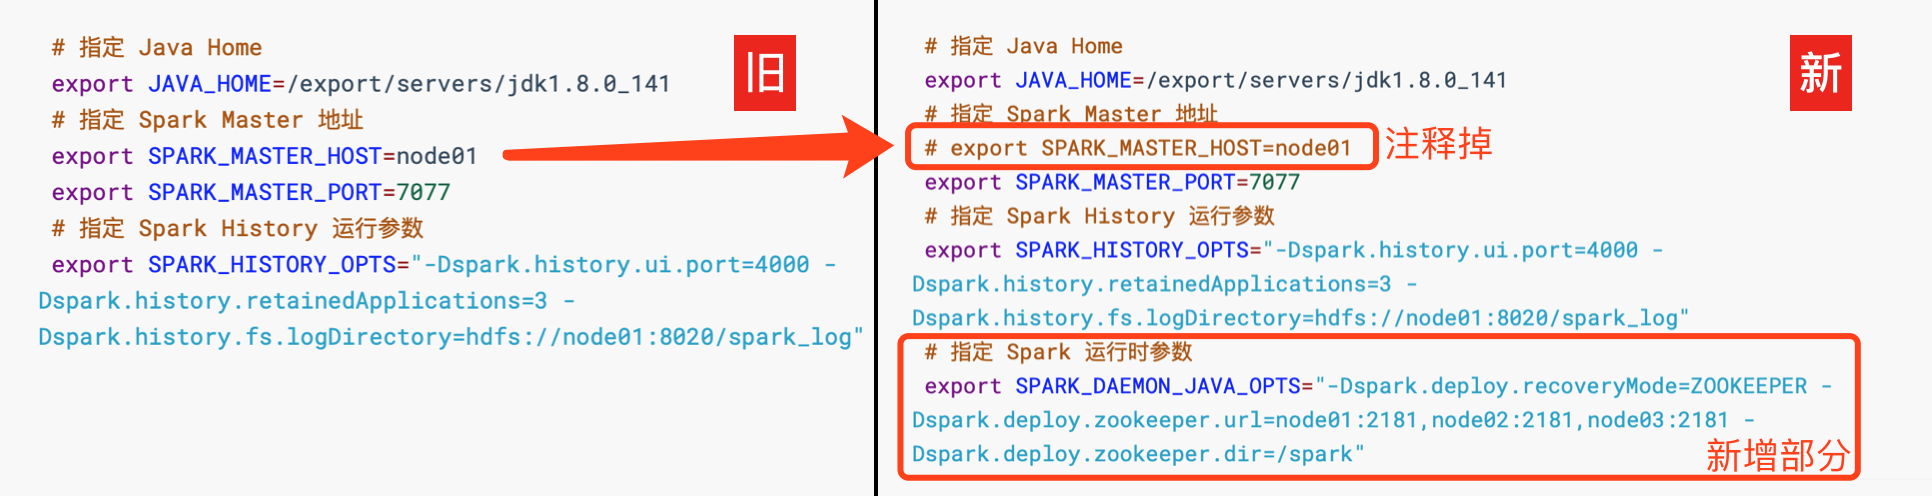
# 指定 Java Home

export JAVA_HOME=/export/servers/jdk1.8.0_141

# 指定 Spark Master 地址

# export SPARK_MASTER_HOST=node01

export SPARK_MASTER_PORT=7077

# 指定 Spark History 运行参数

export SPARK_HISTORY_OPTS="-Dspark.history.ui.port=4000 -Dspark.history.retainedApplications=3 -Dspark.history.fs.logDirectory=hdfs://node01:8020/spark_log"

# 指定 Spark 运行时参数

export SPARK_DAEMON_JAVA_OPTS="-Dspark.deploy.recoveryMode=ZOOKEEPER -Dspark.deploy.zookeeper.url=node01:2181,node02:2181,node03:2181 -Dspark.deploy.zookeeper.dir=/spark"
Step 3 分发配置文件到整个集群
cd /export/servers/spark/conf

scp spark-env.sh node02:$PWD

scp spark-env.sh node03:$PWD
Step 4 启动
在
node01上启动整个集群cd /export/servers/spark
sbin/start-all.sh
sbin/start-history-server.sh在
node02上单独再启动一个 Mastercd /export/servers/spark
sbin/start-master.sh
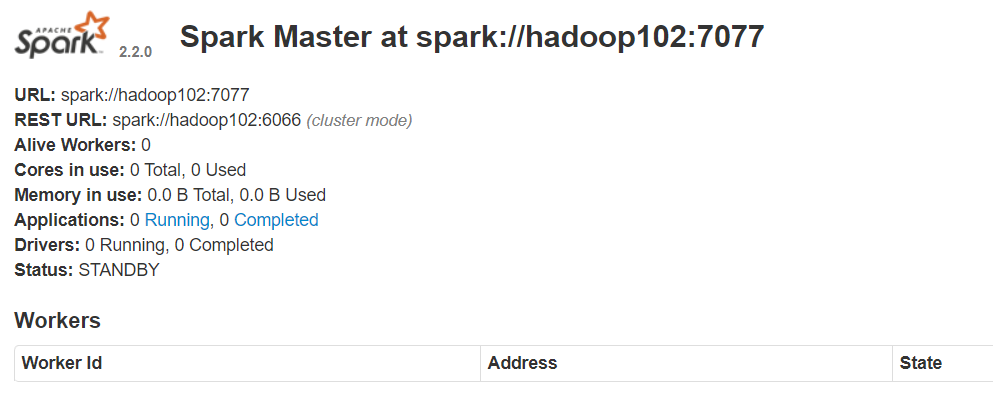
Step 5 查看 node01 master 和 node02 master 的 WebUI
你会发现一个是
ALIVE(主), 另外一个是STANDBY(备)

Spark shell
简单介绍
Spark shell 是 Spark 提供的一个基于 Scala 语言的交互式解释器, 类似于 Scala 提供的交互式解释器, Spark shell 也可以直接在 Shell 中编写代码执行
这种方式也比较重要, 因为一般的数据分析任务可能需要探索着进行, 不是一蹴而就的, 使用 Spark shell 先进行探索, 当代码稳定以后, 使用独立应用的方式来提交任务, 这样是一个比较常见的流程
Spark shell 的方式编写 WordCount
|
Spark shell 简介
|
|
Master地址的设置
Master 的地址可以有如下几种设置方式
|
Step 1 准备文件
在 hadoop01 中创建文件 /export/data/wordcount.txt,文件内容如下
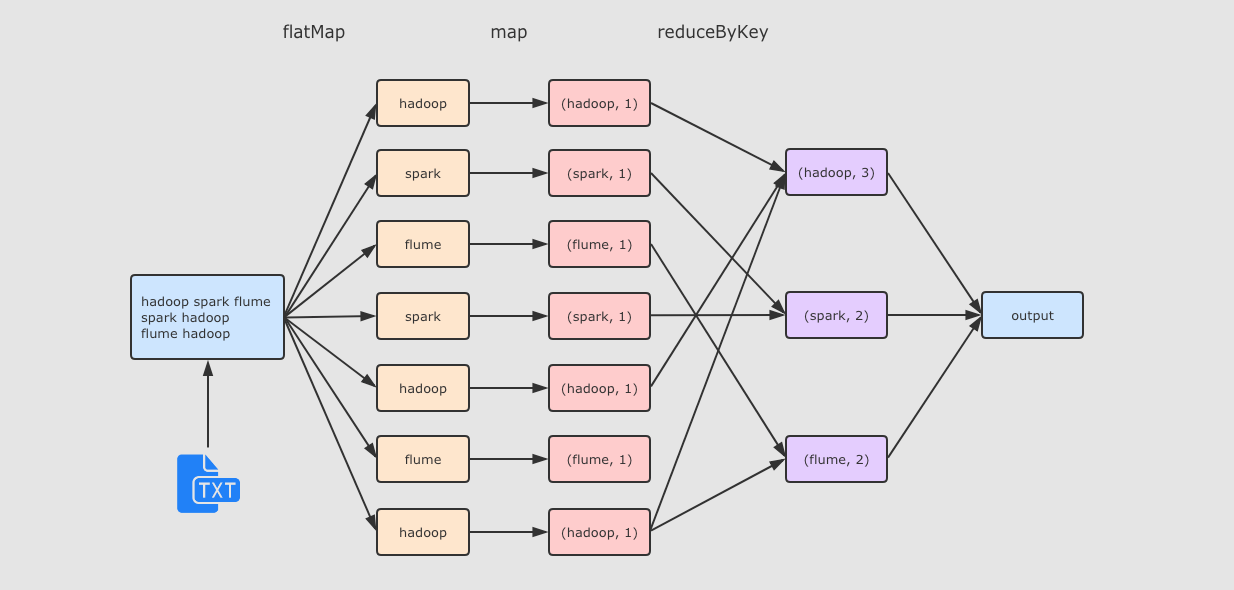
hadoop spark flume

spark hadoop

flume hadoop
Step 2 启动 Spark shell
cd /export/servers/spark

bin/spark-shell --master local[2]
Step 3 执行如下代码

运行流程
Spark学习进度-Spark环境搭建&Spark shell的更多相关文章
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十)安装hadoop2.9.0搭建HA
如何搭建配置centos虚拟机请参考<Kafka:ZK+Kafka+Spark Streaming集群环境搭建(一)VMW安装四台CentOS,并实现本机与它们能交互,虚拟机内部实现可以上网.& ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(九)安装kafka_2.11-1.1.0
如何搭建配置centos虚拟机请参考<Kafka:ZK+Kafka+Spark Streaming集群环境搭建(一)VMW安装四台CentOS,并实现本机与它们能交互,虚拟机内部实现可以上网.& ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(二十一)NIFI1.7.1安装
一.nifi基本配置 1. 修改各节点主机名,修改/etc/hosts文件内容. 192.168.0.120 master 192.168.0.121 slave1 192.168.0.122 sla ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十三)kafka+spark streaming打包好的程序提交时提示虚拟内存不足(Container is running beyond virtual memory limits. Current usage: 119.5 MB of 1 GB physical memory used; 2.2 GB of 2.1 G)
异常问题:Container is running beyond virtual memory limits. Current usage: 119.5 MB of 1 GB physical mem ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十二)VMW安装四台CentOS,并实现本机与它们能交互,虚拟机内部实现可以上网。
Centos7出现异常:Failed to start LSB: Bring up/down networking. 按照<Kafka:ZK+Kafka+Spark Streaming集群环境搭 ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(十一)定制一个arvo格式文件发送到kafka的topic,通过Structured Streaming读取kafka的数据
将arvo格式数据发送到kafka的topic 第一步:定制avro schema: { "type": "record", "name": ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(八)安装zookeeper-3.4.12
如何搭建配置centos虚拟机请参考<Kafka:ZK+Kafka+Spark Streaming集群环境搭建(一)VMW安装四台CentOS,并实现本机与它们能交互,虚拟机内部实现可以上网.& ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(三)安装spark2.2.1
如何搭建配置centos虚拟机请参考<Kafka:ZK+Kafka+Spark Streaming集群环境搭建(一)VMW安装四台CentOS,并实现本机与它们能交互,虚拟机内部实现可以上网.& ...
- Kafka:ZK+Kafka+Spark Streaming集群环境搭建(二)安装hadoop2.9.0
如何搭建配置centos虚拟机请参考<Kafka:ZK+Kafka+Spark Streaming集群环境搭建(一)VMW安装四台CentOS,并实现本机与它们能交互,虚拟机内部实现可以上网.& ...
- Spark学习笔记1——第一个Spark程序:单词数统计
Spark学习笔记1--第一个Spark程序:单词数统计 笔记摘抄自 [美] Holden Karau 等著的<Spark快速大数据分析> 添加依赖 通过 Maven 添加 Spark-c ...
随机推荐
- 转:【Python3网络爬虫开发实战】 requests基本用法
1. 准备工作 在开始之前,请确保已经正确安装好了requests库.如果没有安装,可以参考1.2.1节安装. 2. 实例引入 urllib库中的urlopen()方法实际上是以GET方式请求网页,而 ...
- 性能测试学习之路 (二)jmeter详解(jmeter执行顺序 && 作用域 && 断言 && 事务 &&集合点 )
1 Jmeter 工作区介绍 jmeter工作区分为3个部分:目录树.测试计划编辑区域.菜单栏. 2 Jmeter 执行顺序规则 Jmeter执行顺序规则如下: 配置元件 前置处理器 定时器 采样器s ...
- 快速排序(c++,递归)quick_sort
放上c++代码,模板 1 #include <iostream> 2 #include<bits/stdc++.h> 3 using namespace std; 4 5 in ...
- jquery 执行a 标签 点击事件 跳转href 路径
<a href="./export.pdf" id="pdfdown" download="文件名.pdf">下载</a& ...
- js已知A,B两点坐标,在线段AB上有C点,已知AC的距离,求C点的坐标
/** * @param {Number} _x1 A点坐标 * @param {Number} _y1 A点坐标 * @param {Number} _x2 B点坐标 * @param {Numbe ...
- 落谷P3041 [USACO12JAN]Video Game G
题目链接 多模式匹配问题,先建 AC 自动机. 套路性的搞个 DP: \(f[i][j]\) 表示前 \(i\) 个字符,当前在 \(AC\) 自动机上的节点是 \(j\) 能匹配到的最多分. 初始化 ...
- uwsgi+nginx 基于linux的各种离谱错误
1.常见的排查方法 1.nginx错误 启动报错 systemctl restart nginx tail -f /var/log/nginx/error.log 在浏览器中访问抱错 tail -f ...
- html 05-HTML标签图文详解(二)
05-HTML标签图文详解(二) #本文主要内容 列表标签:<ul>.<ol>.<dl> 表格标签:<table> 框架标签及内嵌框架<ifram ...
- 初始Node
node是什么? 一句话: 服务器 什么是服务器: 一句话: 客户端访问 并且能够响应 为什么: 一句话: 执行效率高 #安装 #控制台 切换磁盘: e: 改变目录: cd 目录 cd.. ...
- fMRI数据分析学习笔记——常用工具
背景 在学习fMRI数据处理的过程中,通过其他的资料看到了别人推荐的有用的fMRI数据处理软件和小插件,在此记录一下,以便后期慢慢学习使用. 1.NeuroImaging Analysis Kit ( ...