
爬取json Swaggerui界面

对一个静态的网页进行爬取。
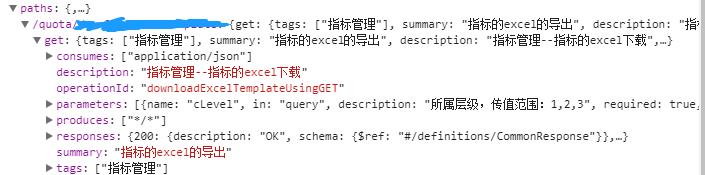
要获取的内容分别为 paths 标签下的
1./quota/开头的路径
2. get 这样的httpmode
3 description对应的描述
4 summary
5 tags 里存放着的服务名
6 服务名所对应的副描述(不在paths标签下)
7总的title(只有一个
import requests

import json

import pymysql

import urllib

from urllib.request import urlopen

from bs4 import BeautifulSoup

import re

url = 'http://192.168.101.213:7027/v2/api-docs'

headers = {"User-Agent": "Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3325.181 Safari/537.36)"}

response = requests.get(url,headers=headers).text

json_str = json.loads(response)#转化为字符串

aa1 = json_str['info']['title']#大title

aa2=[]

aa2.append(aa1)

aa=aa2*42

cc1 = json_str['paths']#提取在整个paths标签下的数据

cc = [] #微服务路径

dd = [] #获取方式

for key in cc1.keys():#获得字典的key值

    cc.append(key)

for m in cc:

        dd1 = json_str['paths'][m]#在cc这个list中进行遍历

        for key2 in dd1.keys():

                        dd.append(key2)

ee = []#扩展操作

bb = []#微服务名

gg = []#微服务描述

ff = []#主描述

for o,p in zip(cc,dd):#同时遍历 cc和dd两个list 用zip对他们进行封装

                try:

                    ee1 = json_str['paths'][o][p]['summary']

                    bb1 = json_str['paths'][o][p]['tags'][0]

                    gg1 = json_str['paths'][o][p]['description']

                    bb.append(bb1)

                    ee.append(ee1)

                    gg.append(gg1)

                except(KeyError):#因为有两个要爬取的内容是没有 description这个key值的 所以遇到keyerror时继续爬取

                    continue

hh=[]#这一部爬取6个微服务名 因为相应description没有被一起存放在paths标签下面

for n1 in range (0,6):

                        hh1 = json_str['tags'][n1]['name']

                        hh.append(hh1)

list3 = [hh.index(num) for num in bb]#将存放在bb中的微服务名拿到hh中进行对比 获得他们的num值存放在list3中

for n3 in list3:

                ff1 = json_str['tags'][n3]['description']#遍历list3获得他们想对应的description值

                ff.append(ff1)

db = pymysql.connect('localhost', 'root', '******', 'languid')

cursor = db.cursor()

for z, x, c, v, z1, x1 ,c1 in zip(aa,bb,gg,cc,dd,ff,ee):#遍历6个列表并对他们封装

                    sql = """insert into swaggerui(Platform,Microservice,Microservicedescrption,MicroPaths,Httpmode,Microdescrption,MicroNotes)VALUES ('%s','%s','%s','%s','%s','%s','%s')"""%(z, x, c, v, z1, x1, c1)

                    cursor.execute(sql)

                    db.commit()
1).主要在于标签名字的获取,因为想要获取的内容被存放在了标签名。
for key in cc1.keys():

            cc.append(key)
所以要用for循环来获得字典的键值。
相当于
dic ={"name"="香蕉","种类"=“水果","sales”=“1000”}

for ke in dic.keys():

                        print(ke)

name

种类

sales

也可以用items()的方法

for ke in dic.items():

                            print(ke[0])

name

种类

sales
2).用一个if语句 对比两个list取得需要的值
list1=[a,b,c,d,e,a,c,e,a,b,d,c,a,e,b,c,e,a,d,e](顺序是随机的但是都是a-e)

list2=[a,b,c,d,e]
用索引的方法我们可以获得对应的num值
list3 = [list2.index(num) for num in list1]

[0, 1, 2, 3, 4, 0, 2, 4, 0, 1, 3, 2, 0, 4, 1, 2, 4, 0, 3, 4]
再用一个for循环遍历list3就可以获得相应的数据了。
最后存放到mysql里面的显示是这样的

爬取json Swaggerui界面的更多相关文章
- 豆瓣电影信息爬取(json)
豆瓣电影信息爬取(json) # a = "hello world" # 字符串数据类型# b = {"name":"python"} # ...
- 基于nodejs模拟浏览器post请求爬取json数据
今天想爬取某网站的后台传来的数据,中间遇到了很多阻碍,花了2个小时才请求到数据,所以我在此总结了一些经验. 首先,放上我所爬取的请求地址http://api.chuchujie.com/api/?v= ...
- 2019-04-23-Python爬取有声小说
目录 Python爬取有声小说 摘要 1.获取下载链接 2.分析规律,循环爬取 3.保存到本地,批量命名 4.界面设计 5.效果展示 Python爬取有声小说 通过python爬取网站的资源,实现批量 ...
- python 手机app数据爬取
目录 一:爬取主要流程简述 二:抓包工具Charles 1.Charles的使用 2.安装 (1)安装链接 (2)须知 (3)安装后 3.证书配置 (1)证书配置说明 (2)windows系统安装证书 ...
- 直接请求json文件爬取天眼查企业信息(未解决验证码问题)——python3实现
几个月前...省略一堆剧情...直接请求json文件爬取企业信息未成功,在知乎提问后,得到解决,有大佬说带上全部headers和cookie是可以的,我就又去试了下,果然可以(之前自己试的时候不行,没 ...
- 关于爬取数据保存到json文件,中文是unicode解决方式
流程: 爬取的数据处理为列表,包含字典.里面包含中文, 经过json.dumps,保存到json文件中, 发现里面的中文显示未\ue768这样子 查阅资料发现,json.dumps 有一个参数.ens ...
- 第三天,爬取伯乐在线文章代码,编写items.py,保存数据到本地json文件中
一. 爬取http://blog.jobbole.com/all-posts/中的所有文章 1. 编写jobbole.py简单代码 import scrapy from scrapy. ...
- <day003>登录+爬取淘宝商品信息+字典用json存储
任务1:利用cookie可以免去登录的烦恼(验证码) ''' 只需要有登录后的cookie,就可以绕过验证码 登录后的cookie可以通过Selenium用第三方(微博)进行登录,不需要进行淘宝的滑动 ...
- android高仿抖音、点餐界面、天气项目、自定义view指示、爬取美女图片等源码
Android精选源码 一个爬取美女图片的app Android高仿抖音 android一个可以上拉下滑的Ui效果 android用shape方式实现样式源码 一款Android上的新浪微博第三方轻量 ...
随机推荐
- ios端阻止页面滚动露底
转自 http://www.eboy.me/archives/129: 在IOS端的微信中使用H5页面,页面滑动到底部时,再向上拉或页面在顶部时下拉,总会露出微信自带的底色:总是会让人不爽. 以下是一 ...
- Comet OJ Contest #2
A:暴力,显然每两次至少翻一倍. #include<bits/stdc++.h> using namespace std; #define ll long long #define inf ...
- 数据分析三剑客之pandas
Pandas 引入 前面一篇文章我们介绍了numpy,但numpy的特长并不是在于数据处理,而是在它能非常方便地实现科学计算,所以我们日常对数据进行处理时用的numpy情况并不是很多,我们需要处理的数 ...
- openflow控制器和交换机之间的消息
openflow控制器和交换机之间的消息 消息格式 openflow消息由64bit,8个字节组成 Openflow协议数据包由Openflow Header和Openflow Message两部分组 ...
- 使用sshpass同时更新一台ubuntu和一台CentOS
1.在ubuntu上安装sshpass sudo apt install sshpass 2.分别在两台的root路径下放上升级脚本: cent:/root/upgrade.sh #!/bin/bas ...
- linux的/etc/profile、~/.profile、~/.bashrc、~./bash_profile这几个配置文件
在添加环境变量的时候,我们会去修改配置文件 如果留意过,网上博文,有些在/etc/profile文件中配置的,有些是在~./bash_profile文件中配置的,等等 那么,/etc/profile. ...
- centos7环境搭建命令List
npm -ivh jdk-8u191-linux-x64.rpm adduser sai passwd sai whereis sudoers vim /etc/sudoers rpm -qa | g ...
- 51nod 1630(定积分 + 期望)
51nod1630 每个人进入竞技场后,会等概率随机匹配一个人,匹配到的人与当前胜利和失败场数无关. 胜利达到x场,或失败达到y场后,退出竞技场,根据退出时的胜利场数获得奖励,不能中途放弃. 水平高的 ...
- maven的安装教程
一.准备工作 1.确定电脑上已经成功安装jdk7.0以上版本 2.win10操作系统 3.maven安装包 下载 ...
- openssl实现自签名证书
前言 证书的作用 加密通信数据,验证对象身份,保证数据完整性 什么是自签名证书 公认的证书往往都需要收费,如果客户端与服务端都是由我们自己来操控,那便可以使用自签名证书(说白了就是只是自己认可的证书) ...