
HttpClient拉取连载小说
上午刚入手的小说,下午心血来潮想从网站上拉取下来做成电子书,呵呵,瞎折腾~说做就做~
【抓包】
这一步比什么都重要,如果找不到获取真正资源的那个请求,就什么都不用做了~
先是打算用迅雷把所有页面都下载下来然后本地处理,结果发现保存下来的页面都只有界面没有内容~看了看Javascript的代码,原来是ready的时候再ajax发送post到另一个网址取内容。
于是再抓包核实一下。抓包工具真难搞,试了两三个都没成功,最后还是用firefox搞定了~打开页面共发送了50个请求,不过post只有两个,很快就看到http包的内容了。
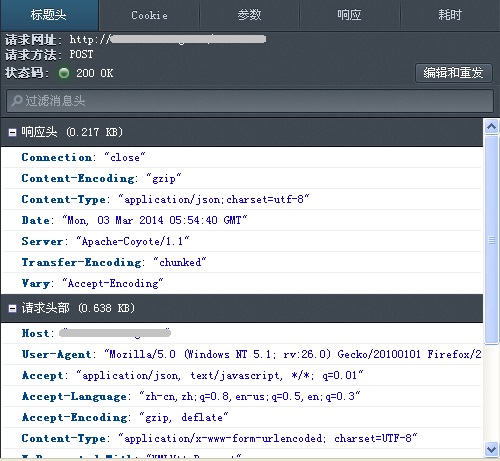
【写程序拉取】
网址,请求的header,表单 都具备了,还等什么,赶紧码字爬取啦~本来还担心要伪装浏览器,要填入cookies内容,调试起来发现是想太多了,直奔网址带上表单就够了~
HttpClient的用法是现炒现卖,官方example的QuickStart.java就够很清晰了。再有就是debug进去看请求和响应。
用法见HttpPost和crawlOnePage(HttpRequestBase)。MyFileWriter就不贴出来献丑了,反正就是个I/O。
遇到并解决的问题:
1.响应回来的资源是gzip压缩过的,要用对应的类去解码;
2.网址序列号中个别缺页,通过判断响应里的状态码跳过即可。
(全文完,以下是代码。)
 package mycrawl;

 import java.io.IOException;

 import java.util.ArrayList;

 import java.util.List;

 import org.apache.http.HttpEntity;

 import org.apache.http.NameValuePair;

 import org.apache.http.client.ClientProtocolException;

 import org.apache.http.client.entity.GzipDecompressingEntity;

 import org.apache.http.client.entity.UrlEncodedFormEntity;

 import org.apache.http.client.methods.CloseableHttpResponse;

 import org.apache.http.client.methods.HttpPost;

 import org.apache.http.client.methods.HttpRequestBase;

 import org.apache.http.impl.client.CloseableHttpClient;

 import org.apache.http.impl.client.HttpClients;

 import org.apache.http.message.BasicNameValuePair;

 import org.apache.http.util.EntityUtils;

 import crawl.common.MyFileWriter;

 public class MyCrawl {

     private static CloseableHttpClient httpclient = HttpClients.createDefault();

     /**

      * (1)建立post对象,包括网址和表单 (2)循环抓取每页并处理输出

      *

      * @param args

      * @throws IOException

      */

     public static void main(String[] args) throws IOException {

         final int startChapter = 页面序列号;

         final int endChapter = 页面序列号;
         final Integer bookId = bookid;

         String outPattern = "c:\\book*.txt";

         MyFileWriter fw = new MyFileWriter(outPattern);

         // 创建post操作

         HttpPost httpPost = new HttpPost("网址");

         List<NameValuePair> nvps = new ArrayList<NameValuePair>(2);

         try {

             // post的表单内容

             nvps.add(new BasicNameValuePair("b", bookId.toString()));

             nvps.add(new BasicNameValuePair("c", "placeholder"));

             for (Integer i = startChapter, j = 0; i <= endChapter; i++, j++) {

                 // 循环抓取连续章节

                 nvps.set(1, new BasicNameValuePair("c", i.toString()));

                 httpPost.setEntity(new UrlEncodedFormEntity(nvps));

                 String outStr = MyCrawl.crawlOnePage(httpPost);

                 if (outStr == null || outStr.isEmpty()) {

                     j--;

                     continue;

                 }

                 // 处理章节标题,懒得去抓取标题页了。

                 outStr = "====== " + MyCrawl.chapterArr[j] + "\r\n"

                         + MyCrawl.prettyTxt(outStr);

                 // System.out.println(outStr);

                 fw.rollingAppend(outStr);

             }

             fw.getFileWriter().flush();

             fw.getFileWriter().close();

             System.out.println("已完成");

         } finally {

             httpclient.close();

         }

     }

     /**

      * 抓取单页

      *

      * @param req

      * @return result

      * @throws ClientProtocolException

      * @throws IOException

      */

     public static String crawlOnePage(HttpRequestBase req)

             throws ClientProtocolException, IOException {

         String result;

         CloseableHttpResponse resp = httpclient.execute(req);

         // 处理返回码

         int status = resp.getStatusLine().getStatusCode();

         if (status < 200 || status >= 300) {

             System.out.println("[Error] " + resp.getStatusLine().toString());

             return "";

         } else if (status != 200) {

             System.out.println("[Warn] " + resp.getStatusLine().toString());

             return "";

         }

         HttpEntity entity = resp.getEntity();

         if (entity instanceof GzipDecompressingEntity) {

             // 解压缩内容

             GzipDecompressingEntity gEntity = (GzipDecompressingEntity) entity;

             result = EntityUtils.toString(gEntity);

         } else {

             result = EntityUtils.toString(entity);

         }

         EntityUtils.consume(entity);

         resp.close();

         return result;

     }

     /**

      * 处理换行等特殊字符

      *

      * @param txt

      * @return string

      */

     public static String prettyTxt(String txt) {

         if (txt == null || txt.isEmpty()) {

             return "";

         }

         int contentStart = txt.indexOf("content") + 10;

         int contentEnd = txt.indexOf("  <br/><br/>  \",\"next");

         txt = txt.substring(contentStart, contentEnd);

         return txt.replace("<br/><br/>", "\r\n");

     }

     // 章节标题

     private static final String[] chapterArr = new String[] { "第一章",

             "第二章" };

 }
HttpClient拉取连载小说的更多相关文章
- 《破碎的残阳,我们逆光》连载小说- HashMap剖析
破碎的残阳,我们逆光[连载小说]- HashMap剖析 "行到水穷处,坐看云起时" 前言: 偶尔翻阅了自己当时高中时代写的日志,发现了几篇自己多年未打开的自写小说草本 ...
- Python的scrapy之爬取顶点小说网的所有小说
闲来无事用Python的scrapy框架练练手,爬取顶点小说网的所有小说的详细信息. 看一下网页的构造: tr标签里面的 td 使我们所要爬取的信息 下面是我们要爬取的二级页面 小说的简介信息: 下面 ...
- 一步步教你用Prometheus搭建实时监控系统系列(二)——详细分析拉取和推送两种不同模式
前言 本系列着重介绍Prometheus以及如何用它和其周边的生态来搭建一套属于自己的实时监控告警平台. 本系列受众对象为初次接触Prometheus的用户,大神勿喷,偏重于操作和实战,但是重要的概念 ...
- github拉取和推送
登入github 创建一个开源项目 然后打开安装好的git 首先进入一个指定的文件夹 例如: 1)E:\>cd miaov/testGit 回车 进入E盘的testGit文件夹 2)E:\mia ...
- git&sourcetree安装及在IntelliIJ下拉取项目基础使用
be careful: 1)git版本与Sourcetree版本最好一致 ,不能git为2.5,sourcetree为1.8 2)先安装git再安装Sourcetree 3)拥有git和sourcet ...
- ***git 本地提交后如果让服务器上的GIT 自动更新拉取
Q: 最近配了个服务器,用的GIT,本地提交后服务器必须再拉取一下才能更新出来..求个提交后自动更新的方法 A: 最佳工具 git hook post-update.sample 改名为post-up ...
- Spark Streaming中向flume拉取数据
在这里看到的解决方法 https://issues.apache.org/jira/browse/SPARK-1729 请是个人理解,有问题请大家留言. 其实本身flume是不支持像KAFKA一样的发 ...
- 用setTimeout 代替 setInterval实时拉取数据
在开发中,我们常常碰到需要定时拉取网站数据,如: setInterval(function(){ $.ajax({ url: 'xx', success: function( response ){ ...
- laravel项目拉取下来安装,node.js库安装
1.拉取项目 2.切换分支 圈圈里面是版本 composer 安装laravel组件其他库 安装node.js安装包 npm set registry=https://registry.npm.ta ...
随机推荐
- cmd笔记
批量获取一个文件夹内所有文件的文件名: dir *.png /b >list.txt tree /f >list.txt for /f "delims=" %%a in ...
- 简单的CSS3鼠标滑过图片标题和遮罩层动画特效
此文转自:http://www.cnblogs.com/w2bc/p/5735300.html,仅供本人学习参考,版权归原作者所有! 这是一款使用CSS3制作的简单的鼠标滑过图片标题和遮罩层动画特 ...
- JQuery脚本-通过禁用按钮防止表单重复提交
<script type="text/javascript"> /* jquer 脚本,避免重复提交 隐藏点击的submit,后在他之后插入同名button伪装成被隐藏 ...
- ArcGIS发布地图服务后直接调用查看方法
做项目配置了一个地理底图,不知道有没有问题,如何给到客户查看并确认呢? 首先在ArcGIS上发布该地图: 打开地图后->文件->共享为->服务…… 发布成功后,得到可以访问的地图服务 ...
- nyoj 214——单调递增子序列(二)——————【二分搜索加dp】
单调递增子序列(二) 时间限制:1000 ms | 内存限制:65535 KB 难度:4 描述 给定一整型数列{a1,a2...,an}(0<n<=100000),找出单调递增最长 ...
- bzoj 5084: hashit
Description 你有一个字符串S,一开始为空串,要求支持两种操作 在S后面加入字母C 删除S最后一个字母 问每次操作后S有多少个两两不同的连续子串 Solution 先忽略删除操作,建出最终的 ...
- sql使用自连接去重复查询
查询公司与公司最新刷新的一条信息 select t1.userid,t1.id,t1.title,t1.RegType,t1.Salary,t1.SubjectID,t1.RefreshTime,t2 ...
- VS2008、 VS2010 、 VS2012、 VS2013 都能用的快捷键
VS2008. VS2010 . VS2012. VS2013 都能用的快捷键 Ctrl+E,D --格式化全部代码 Ctrl+K,F --格式 ...
- .Net下Redis使用注意事项
.Net下Redis使用注意事项 注:Redis的安装方法和桌面端工具很多,不在本文讨论范围内. 一:不结合适用场景的技术都是耍流氓,Redis主要适用场景: 简单字符串缓存 简单队列 简单发布订阅 ...
- pod install 出错
今天使用cocoapods的时候在执行pod install出错,如下: 使用很多方法都不行,但是问题感觉应该是需要升级,所有就找到升级cocoapods:sudo gem install -n /u ...