
HanLP-地名识别调试方法
HanLP收词特别是实体比较多,因此特别容易造成误识别。下边举几个地名误识别的例子,需要指出的是,后边的机构名识别也以地名识别为基础,因此,如果地名识别不准确,也会导致机构名识别不准确。
类型1 数字+地名
[1] 暗访哈尔滨网约车:下10单来7辆“黑车” 1辆套牌
[2] 房天下每日成交5月12日海宁商品房销售备案43套
[3] 广西近视手术专家-黄明汉院长9月9日百色见面会
类型2 前词+地名首词成词或地名尾词+后词成词
[1] 西安国企4000元工资相当于私企多少钱?
[2] 七月份从包头到山东,十五天左右,有自驾游路线推荐吗?
[3] 最受考研人欢迎的城市,有你报考高校所在的城市吗?
类型3 地名本身成词
[1] 滴滴司机接跨省天价订单 乘客半路改道至今未付款
[2] 上联:山水不曾随我老,如何对下联?
[3] 上联:柳着金妆闲钓水,如何对下联?
Badcase分析及修正
下边介绍一下排查误判原因以及修正的方法
首先需要明确以下几点注意事项
1.实体识别受分词精度影响。
2.实体识别同样涉及消歧的问题。
3.HanLP收录了一些不常见的实体词,会造成错误率升高。
4.HanLP基于隐马的命名实体识召回率没有特别要求的话,不需要再去训练。
这里我们以下边这个badcase的分析过程为例来说明
[5] 上联:山水不曾随我老,如何对下联?
打开提示模式 HanLP.Config.enableDebug()
运行人名识别代码
# HanLP命名实体识别
def hanlp_ner(text, ner_type):
global segment
ner_li = []
for term in segment.seg(text):
if str(term.nature) == ner_type:
ner_li.append(str(term.word))
return ner_li
这里ner_type为你要识别的实体类型,如果是人名则ner_type='nr',地名ner_type='ns',机构名ner_type='nt'。text为要抽取实体的文本。
识别结果,这里为了清晰,只截取了部分输出。
粗分结果[上联/n, :/w, 山水/n, 不/d, 曾随/ns, 我/rr, 老/a, ,/w, 如何/ryv, 对/p, 下联/n, ?/w]
地名角色观察:[ S 1163565 ][上联 Z 20211628 ][: A 2701 B 439 X 11 ][山水 B 6 A 1 ][不 B 214 A 3 C 3 ][曾随 G 1 H 1 ]
[我 A 47 B 26 ][老 C 274 A 75 B 66 D 2 X 2 ][, A 40525 B 10497 X 418 ][如何 B 44 ][对 A 2896 B 454 X 215 ][下联 Z 20211628 ][? B 82 ][ B 1322 ]
地名角色标注:[ /S ,上联/Z ,:/B ,山水/A ,不/C ,曾随/H ,我/B ,老/B ,,/A ,如何/B ,对/A ,下联/Z ,?/B , /S]
识别出地名:不曾随 CH
hanlp_ns ['不曾随']
显然,曾随被认为是地名了,而且粗分结果表示的是未经地名识别模块分词和词性标注的结果,显然这是由于词表导致的。由于没有经过地名识别模块,所以不需要去地名的发射词表ns.txt中去找词语,只需要看核心词表CoreNatureDictionary.txt中去找
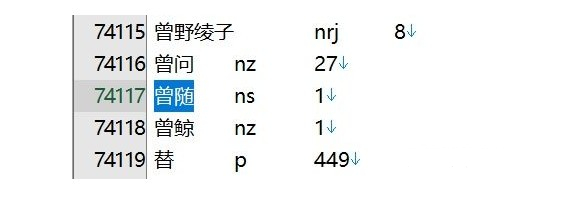
显然,在核心词表中“曾随“被标记为一个地名,把”曾随“从词表中删除掉,并删除词表文件CoreNatureDictionary.txt.bin,之后再次运行程序得到下边的输出结果
hanlp_ns []
从这个实例,我们也可以看出一些不常见地名如果做成地名词表,就有导致错误识别实体。因此,我们应该保留一份评测语料,每当修改了实体词表后,需要跑一下测试语料查看准确率,如果降低的太多,则表示这样加进来是不可行的。同时填加的实体名也有可能会造成分词错误。
下边说明一下HanLP中有关实体的词表文件名
1.CoreNatureDictionary.mini.txt
2.CoreNatureDictionary.txt
3.CustomDictionary.txt
4.机构名词典.txt
5.全国地名大全.txt
6.人名词典.txt
7.上海地名.txt
8.现代汉语补充词库.txt
9.ns.txt
10.nr.txt
11.nt.txt
当然这里列出的是通常最有可能导致误识别的词表,如果这些词表都没有找到,还需要在HanLP其他词典文件中寻找。
希望今天的内容对使用HanLP并对隐马情有独钟的小伙伴有帮助。这两天的一点小体会是,实体识别其实跟分词是密不可分的,两者都有共同的处理难点,比如词义消歧(边界的确定),词法分析其实才是真正的NLP的内容之一,而词法分析跟机器学习其实没有太大关系。上边的badcase解决方法不是根本方法,直接去除掉某些词,会导致一些生僻实体识别不出来。我们是否可以考虑左右信息熵之类的测度函数来解决这种词是否需要拆开与其前后构成词。针对词法分析推荐大家使用深度学习的方法,毕竟了解这些方法也是必须的,虽然你可以在实际种不用,但是不代表你可以偷懒而不去学习。
HanLP-地名识别调试方法的更多相关文章
- Hanlp-地名识别调试方法详解
HanLP收词特别是实体比较多,因此特别容易造成误识别.下边举几个地名误识别的例子,需要指出的是,后边的机构名识别也以地名识别为基础,因此,如果地名识别不准确,也会导致机构名识别不准确. 类型1 数字 ...
- Linux内核调试方法总结【转】
转自:http://my.oschina.net/fgq611/blog/113249 内核开发比用户空间开发更难的一个因素就是内核调试艰难.内核错误往往会导致系统宕机,很难保留出错时的现场.调试内核 ...
- 【转】Linux内核调试方法总结
目录[-] 一 调试前的准备 二 内核中的bug 三 内核调试配置选项 1 内核配置 2 调试原子操作 四 引发bug并打印信息 1 BUG()和BUG_ON() 2 dump_sta ...
- Perl的调试方法
来源: http://my.oschina.net/alphajay/blog/52172 http://www.cnblogs.com/baiyanhuang/archive/2009/11/09/ ...
- Linux内核调试方法总结
Linux内核调试方法总结 一 调试前的准备 二 内核中的bug 三 内核调试配置选项 1 内核配置 2 调试原子操作 四 引发bug并打印信息 1 BUG()和BUG_ON() 2 ...
- 实战HMM-Viterbi角色标注地名识别
http://www.hankcs.com/nlp/ner/place-names-to-identify-actual-hmm-viterbi-role-labeling.html 命名实体识别(N ...
- 嵌入式linux应用程序调试方法
嵌入式linux应用程序调试方法 四 内存工具 五 C/C++代码覆盖.性能profiling工具 四 内存工具 您肯定不想陷入类似在几千次调用之后发生分配溢出这样的情形. 许多小组花了许许多多时间来 ...
- javascript四种类型识别的方法
× 目录 [1]typeof [2]instanceof [3]constructor[4]toString 前面的话 javascript有复杂的类型系统,类型识别则是基本的功能.javascrip ...
- Linux环境下段错误的产生原因及调试方法小结(转)
最近在Linux环境下做C语言项目,由于是在一个原有项目基础之上进行二次开发,而且 项目工程庞大复杂,出现了不少问题,其中遇到最多.花费时间最长的问题就是著名的“段错误”(Segmentation F ...
随机推荐
- BZOJ 4241: 历史研究 ( 回 滚 )
题目: 链接:https://www.lydsy.com/JudgeOnline/problem.php?id=4241 题意:给你一个长度为n序列,m次查询,每次询问 一段区间 最大的 a[ i ...
- Noip2014 提高组 Day1 T1 生活大爆炸版石头剪刀布 + Day2 T1 无线网络发射器选址
Day1 T1 题目描述 石头剪刀布是常见的猜拳游戏:石头胜剪刀,剪刀胜布,布胜石头.如果两个人出拳一样,则不分胜负.在<生活大爆炸>第二季第8 集中出现了一种石头剪刀布的升级版游戏. 升 ...
- CPU中断的机制概论
cpu的数学模型是图灵机,图灵机是一个线性运行指令的机器,它的执行序列是完全确定的,中断机制是使得cpu具有异步处理能力的机制,就是先暂停他的序列 来执行一些其他指令.具体来说就是,从硬件实现上,其 ...
- Irrlicht引擎剖析二
- re,xpath,BeautifulSoup三种方法爬取古诗词网上诗歌
re,xpath ,bs4对同一个页面的解析速度发现re比xpath快接近10倍,xpath比bs4快接近10倍可见要想追求极致速度,使用正则表达式解析有多重要 1.re解析的代码 # 使用正则表达式 ...
- vim 操作命令
#显示行号,设定之后,会在每一行的前缀显示该行的行号:set nu #取消行号显示:set nonu #将编辑的数据写入硬盘档案中(常用):w #若文件属性为『只读』时,强制写入该档案.不过,到底能不 ...
- GA函数优化
一.遗传算法简介 遗传算法(Genetic Algorithms,GA)是1962年美国人提出,模拟自然界遗传和生物进化论而成的一种并行随机搜索最优化方法. 与自然界中“优胜略汰,适者 ...
- WIN7+Qt5.2.0连接oracle数据库的oci驱动的编译
一.前提安装 1.需要安装QT5.2.0,本介绍安装的是qt-windows-opensource-5.2.0-mingw48_opengl-x86-offline.exe: 本文安装目录:c:\Qt ...
- ubantu 安装boost库 c++connector
安装libmysqlcppconn: sudo apt-get install libmysqlcppconn-dev 安装libboost: sudo apt-get install libboos ...
- 007-springboot 控制台中文乱码
处理方式 1.FIle encoding 设置为UTF-8 2.-Dfile.encoding=UTF-8 配置tomcat 的的VM启动参数:-Dfile.encoding=UTF-8 3.idea ...