
关于java.io.IOException: HADOOP_HOME or hadoop.home.dir are not set.的问题
报错如下:
300 [main] DEBUG org.apache.hadoop.util.Shell  - Failed to detect a valid hadoop home directory

java.io.IOException: HADOOP_HOME or hadoop.home.dir are not set
解决办法一:
根据 http://blog.csdn.net/baidu_19473529/article/details/54693523 配置hadoop_home变量
下载winutils地址https://github.com/srccodes/hadoop-common-2.2.0-bin下载解压

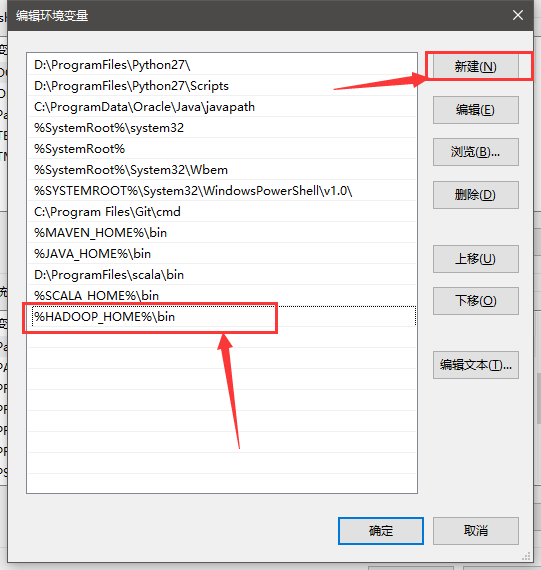
重新打开Eclipse,运行程序,可以解决内网的Hadoop连接问题。(亲测试通过)
解决办法二:
在java程序中加入
System.setProperty("hadoop.home.dir", "/usr/local/hadoop-2.6.0");
依然报错(未亲测试)
解决办法三:(不是同一问题?)
根据该提示:
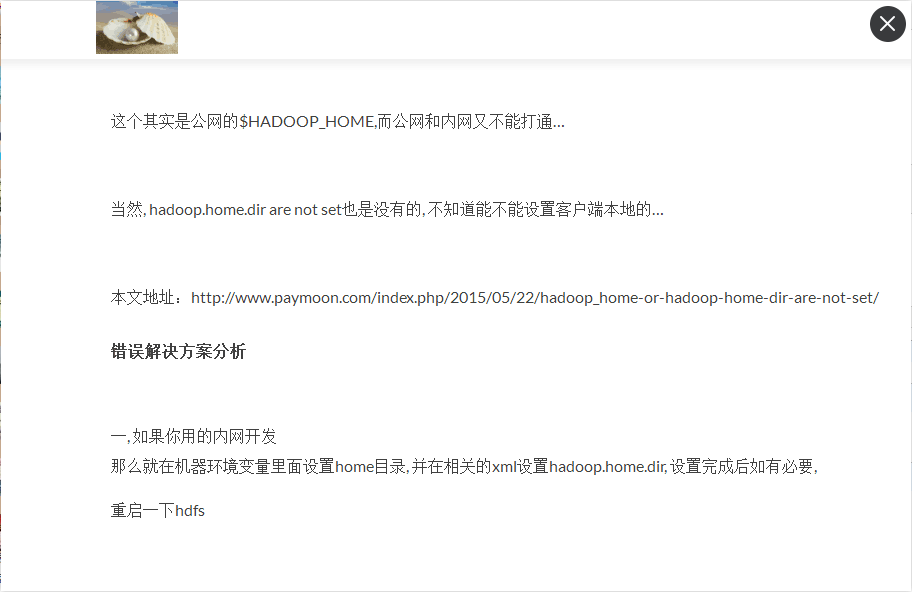
依然报错
--------------------------------5.19.早晨------------------------------------------
今天早上再次执行该程序,将上传到HDFS部分的代码给注释掉后发现日志报错信息如下:
132 [main] DEBUG org.apache.hadoop.util.NativeCodeLoader  - Trying to load the custom-built native-hadoop library...

134 [main] DEBUG org.apache.hadoop.util.NativeCodeLoader  - Failed to load native-hadoop with error: java.lang.UnsatisfiedLinkError: no hadoop in java.library.path
1)check Hadoop library:
root@Ubuntu-1:/usr/local/hadoop-2.6.0/lib/native# file libhadoop.so.1.0.

It's 64-bite library
2)Try adding the HADOOP_OPTS environment variable:
root@Ubuntu-1:~# vi /etc/profile //environment variable
export HADOOP_OPTS="-Djava.library.path=${HADOOP_HOME}/lib/native/"
It doesn't work, and reports the same error.
3)Try adding the HADOOP_OPTS and HADOOP_COMMON_LIB_NATIVE_DIR environment variable:
export HADOOP_COMMON_LIB_NATIVE_DIR=${HADOOP_HOME}/lib/native
export HADOOP_OPTS="-Djava.library.path=${HADOOP_HOME}/lib/"
It still doesn't work, and reports the same error.
4)Adding the Hadoop library into LD_LIBRARY_PATH
root@Ubuntu-1:~# vi .bashrc
export LD_LIBRARY_PATH=/usr/local/hadoop/lib/native/:$LD_LIBRARY_PATH
It doesn't work, and reports the same error.
5)append word native to HADOOP_OPTS like this
export HADOOP_OPTS="$HADOOP_OPTS -Djava.library.path=$HADOOP_HOME/lib/native"
It doesn't work, and reports the same error.
-----------------------------------5.20早晨-------------------------
win下依旧无法使用java代码上传文件到HDFS
----------------------------------5.24------------
copy了一份hadoop-2.6.0文件到本机,更改bin目录和path ,显示无效的path,遂更改回去
---------------------2017.5.26-------------------
今天早上开机 试了一下 发现它已经好了 其实上述的设置已经可以解决大部分遇到这类问题的人群

关于java.io.IOException: HADOOP_HOME or hadoop.home.dir are not set.的问题的更多相关文章
- windows 中使用hbase 异常:java.io.IOException: Could not locate executable null\bin\winutils.exe in the Hadoop binaries.
平时一般是在windows环境下进行开发,在windows 环境下操作hbase可能会出现异常(java.io.IOException: Could not locate executable nul ...
- 排查Hive报错:org.apache.hadoop.hive.serde2.SerDeException: java.io.IOException: Start of Array expected
CREATE TABLE json_nested_test ( count string, usage string, pkg map<string,string>, languages ...
- java.io.IOException: Could not locate executable null\bin\winutils.exe in the Hadoop binaries
在已经搭建好的集群环境Centos6.6+Hadoop2.7+Hbase0.98+Spark1.3.1下,在Win7系统Intellij开发工具中调试Spark读取Hbase.运行直接报错: ? 1 ...
- hive运行query语句时提示错误:org.apache.hadoop.ipc.RemoteException: java.io.IOException: java.io.IOException:
hive> select product_id, track_time from trackinfo limit 5; Total MapReduce jobs = 1 Launching Jo ...
- Spark- ERROR Shell: Failed to locate the winutils binary in the hadoop binary path java.io.IOException: Could not locate executable null\bin\winutils.exe in the Hadoop binaries.
运行 mport org.apache.log4j.{Level, Logger} import org.apache.spark.rdd.RDD import org.apache.spark.{S ...
- spark开发常见问题之一:java.io.IOException: Could not locate executable null\bin\winutils.exe in the Hadoop binaries.
最近在学习研究pyspark机器学习算法,执行代码出现以下异常: 19/06/29 10:08:26 ERROR Shell: Failed to locate the winutils binary ...
- idea 提示:ERROR util.Shell: Failed to locate the winutils binary in the hadoop binary path java.io.IOException解决方法
Windows系统中的IDEA链接Linux里面的Hadoop的api时出现的问题 提示:ERROR util.Shell: Failed to locate the winutils binary ...
- org.apache.hadoop.ipc.RemoteException(java.io.IOException)
昨晚突然之间mr跑步起来了 jps查看 进程都在的,但是在reduce任务跑了85%的时候会抛异常 异常情况如下: 2016-09-21 21:32:28,538 INFO [org.apache.h ...
- 运行基准测试hadoop集群中的问题:org.apache.hadoop.ipc.RemoteException: java.io.IOException: File /benchmarks/TestDFSIO/io_data/test_
在master(即:host2)中执行 hadoop jar hadoop-test-1.1.2.jar DFSCIOTest -write -nrFiles 12 -fileSize 10240 - ...
随机推荐
- ArcGIS案例学习笔记2_2_模型构建器和山顶点提取批处理
ArcGIS案例学习笔记2_2_模型构建器和山顶点提取批处理 计划时间:第二天下午 背景:数据量大,工程大 目的:自动化,批处理,定制业务流程,不写程序 教程:Pdf/343 数据:chap8/ex5 ...
- C# WInForm中 窗体的this.width和this.height的属性值不能大于显示器的最大分辨率
最近在做一个小项目的时候,发现在 1680x1050 分辨率显示器上写的代码,将窗体的宽度和高度 设置成了 1600×900,在高于1600×900的分辨率上缩放显示很正常, 而后转移到 分辨率低于 ...
- Asp.Net WebApi 学习记录(一)
刚创建的 Asp.Net Web Api 项目,在进行简单的测试时发现返回的 JSON 数据很丑陋.与平时我们使用的 JSON.NET 序列化出来的字符串不一样.通过下面的设置就可以了: // 清除所 ...
- 04_web基础(七)之jsp
39.jsp与el表达式引入 JSP:Java Server Pages:Java的服务网页(Java动态网页):=========================================== ...
- Oracle数据导出导入
总结了几种Oracle导入导出的命令方法,方便以后使用. 数据导出: 1. 将数据库test完全导出,用户名system 密码manager 导出到d:/daochu.dmp中 ...
- db2start提示SQL5043,关闭连接终端tty
db2 V10.3启动的时候提示: 问题1: db2start执行后提示: SQL1072C The database manager resources are in an inconsisten ...
- Spring的一些资源
1.http://spring.io/ 2.http://projects.spring.io/spring-framework/
- enlarge your dataset
列举常见的几种数据集增强方法: 1.flip 翻折(左右,上下) # NumPy.'img' = A single image. flip_1 = np.fliplr(img) # TensorFl ...
- layer数据表格换行
在使用layer数据表格的时候,默认是不可以换行的.这样显示 改动后 数据格式为 aa<br>bb就会显示为换行 比如我们的字符串是 a<br>b 这样的字符串浏览器 ...
- minSdk(API 26) > deviceSdk(API 19)解决方式
运行项目时出现“minSdk(API 26) > deviceSdk(API 19)”的提示,因为我用的是手机是sdk(API19)的,而项目要求是最低版本是minSdk(API 26),在我的 ...