
hive的 order by & distribute by & cluter by
我们应该都清楚order by 的含义:
根据某个字段对输出的数据排序,因为只有一个reducer,所以查询效率较慢。
那么hive中,另外两个排序,distribute by和cluster by的含义是什么呢?
- distribute by 分区排序
直接上例子,hive中有张工资表:salary,字段是部门id--department_id,姓名--name,薪水--salary
|
department_id |
name | salary |
| 1 | 张三 | 3500 |
| 2 | 李一 | 2800 |
| 1 | 王五 | 5000 |
| 2 | 赵六 | 6000 |
我们想要按部门分区,再按部门中员工工资由高到低排序:
select * from salary distribute by department_id sort by salary;
|
department_id |
name | salary |
| 1 | 张三 | 3500 |
| 1 | 王五 | 5000 |
| 2 | 李一 | 2800 |
| 2 | 赵六 | 6000 |
可以看到结果按部门做了分区,每个部门数据按薪水做了排序。
观察数据的话,每个文件中存储了相同分区的数据。
因为每个分区使用一个reducer,所以设置的reducer个数应该大于等于结果的分区数,
不然会报错。
补充:
设置reducer个数的方法:
set mapreduce.job.reduces=-1;
设为默认值,系统分配reduce的个数。
设置好后检查一下:
set mapreduce.job.reduces;
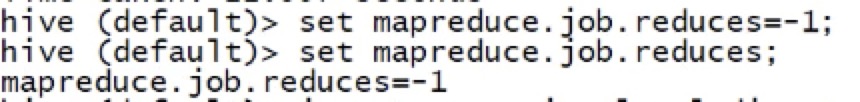
(如果reducer的个数大于分区数会产生空文件,reducer的个数小于分区数则会报错)
说明:
- 类似于mr中的分区,要用多个reducer处理,最终输出多个文件结果
- 当分区字段和排序字段不同的时候使用,需和sort by结合
- cluster by
当ditribute by ...sort by的字段是同一个字段时,可以用cluster by 代替。
但是cluster by的排序只支持倒序,不能指定asc或desc。
hive的 order by & distribute by & cluter by的更多相关文章
- [转]hive中order by,distribute by,sort by,cluster by
转至http://my.oschina.net/repine/blog/296562 order by,distribute by,sort by,cluster by 查询使用说明 1 2 3 4 ...
- Hive中order by,sort by,distribute by,cluster by的区别
一:order by order by会对输入做全局排序,因此只有一个Reducer(多个Reducer无法保证全局有序),然而只有一个Reducer,会导致当输入规模较大时,消耗较长的计算时间.关于 ...
- hive中order by、distribute by、sort by和cluster by的区别和联系
hive中order by.distribute by.sort by和cluster by的区别和联系 order by order by 会对数据进行全局排序,和oracle和mysql等数据库中 ...
- hive中order by,sort by, distribute by, cluster by作用以及用法
1. order by Hive中的order by跟传统的sql语言中的order by作用是一样的,会对查询的结果做一次全局排序,所以说,只有hive的sql中制定了order by所有的 ...
- hive 排序 order by sort by distribute by cluster by
order by: order by是全局排序,受hive.mapred.mode的影响. 使用orderby有一些限制: 1.在严格模式下(hive.mapred.mod ...
- [转载]hive中order by,sort by, distribute by, cluster by作用以及用法
1. order by Hive中的order by跟传统的sql语言中的order by作用是一样的,会对查询的结果做一次全局排序,所以说,只有hive的sql中制定了order by所有的 ...
- hive中order by,sort by, distribute by, cluster by的用法
1.order by hive中的order by 和传统sql中的order by 一样,对数据做全局排序,加上排序,会新启动一个job进行排序,会把所有数据放到同一个reduce中进行处理,不管数 ...
- Hive之Order,Sort,Cluster and Distribute By
测试数据 create table sort_test( id int, name string ) row format delimited fields terminated by '\t' li ...
- hive中order by ,sort by ,distribute by, cluster by 的区别(**很详细**)
hive 查询语法 select [all | distinct] select_ condition, select_ condition from table_name a [join table ...
随机推荐
- Python.URLs
1. The Future of Asynchronous IO in Python https://medium.com/@paulcolomiets/the-future-of-asynchron ...
- APP强制退出
第一种方法: 企业版可以用,Appstore可能被拒,慎用 - (void)exitApplication { AppDelegate *app = [UIApplication sharedAppl ...
- VirtualBox中安装Fedora9及其ARM开发环境配置
因为要学习Tiny4412开发板的嵌入式编程,需要用到Fedora9系统(和手册对应),我就在VirtualBox虚拟机(此虚拟机安装在Ubuntu12.04上)上安装了Fedora9,下面就讲解一下 ...
- VS2010配置OpenGL开发环境
OpenGL(Open Graphics Library)是一个跨编程语言.跨平台的专业图形程序接口.OpenGL是SGI公司开发的一套计算机图形处理系统,是图形硬件的软件接口,任何一个OpenGL应 ...
- DNSlog盲注
前言 在渗透测试中,经常遇到如下情景: 1,sql盲注 2,blind型ssrf以及xxe 3,无回显命令执行漏洞 ... dnslog盲注原理 开放的DNSlog平台: http://ceye.io ...
- vue input,textarea失去焦点调用函数方法
<input type="number" class="num" value="1" @blur.prevent="chan ...
- vue 获取跳转上一页组件信息
项目中有一需求,需要根据不同的页面路径url跳转进行不同的操作,首先需要获得上一页面的url,利用 beforeRouteEnter 这个钩子中的from参数获得之前url的信息,然后给 next 传 ...
- Hbase常用操作(增删改查)
Hbase常用操作(增删改查) [日期:2014-01-03] 来源:Linux社区 作者:net19880504 [字体:大 中 小] 运行Eclipse,创建一个新的Java工程“HBa ...
- vue组件实现查看大图效果
使用的index.vue代码 <template> <img :src="imgUrl" @click="clickImg($event)"& ...
- [转]MySQL索引原理及慢查询优化
MySQL凭借着出色的性能.低廉的成本.丰富的资源,已经成为绝大多数互联网公司的首选关系型数据库.虽然性能出色,但所谓“好马配好鞍”,如何能够更好的使用它,已经成为开发工程师的必修课,我们经常会从职位 ...