
Spark系列(二) Spark Shell各种操作及详细说明
并行化scala集合(Parallelize)
//加载数据1~10
val num=sc.parallelize(1 to 10)
//每个数据项乘以2,注意 _*2记为一个函数(fun)
val doublenum = num.map(_*2)
//内存缓存数据
doublenum.cache()
//过滤数据,每个数据项 % 3 为0的数据为结果集;
val threenum = doublenum.filter(_ % 3 == 0)
//释放缓存
threenum.unpersist()
//出发action操作根据前面的步骤构建DAG并执行,以数据的形式返回结果集;
threenum.collect
//返回结果集中的第一个元素
threenum.first
//返回结果集中的前三个元素
threenum.take(3)
//对数据集中的元素个数统计
threenum.count
//查看以上步骤经过的RDD转换过程
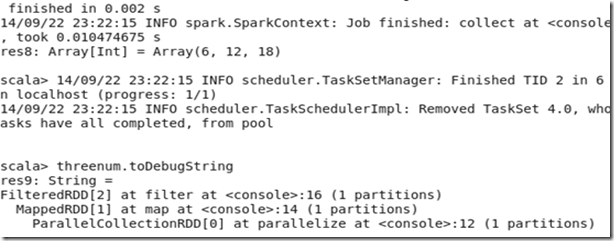
threenum.toDebugString
结果:
K-V类型数据演示
// 加载数据
val kv1=sc.parallelize(List(("A",1),("B",2),("C",3),("A",4),("B",5)))
//根据数据集中的每个元素的K值对数据排序
kv1.sortByKey().collect

kv1.groupByKey().collect //根据数据集中的每个元素的K值对数据分组
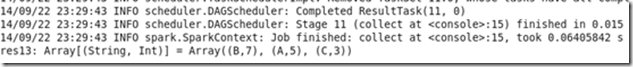
kv1.reduceByKey(_+_).collect
注意:sortByKey 、groupByKey 、reduceByKey之间的结果集的区别;
val kv2=sc.parallelize(List(("A",4),("A",4),("C",3),("A",4),("B",5)))
kv2.distinct.collect // distinct操作去重
kv1.union(kv2).collect //kv1与kv2联合
kv1.join(kv2).collect //kv1与kv2两个数据连接,相当于表的关联
val kv3=sc.parallelize(List(List(1,2),List(3,4)))
kv3.flatMap(x=>x.map(_+1)).collect //注意这里返回的数据集已经不是K-V类型了





HDFS文件操作演示
先将clk.tsv和reg.tsv文件上传到hdfs,文件格式如下;

// 定义一个对日期格式化的常量
val format = new java.text.SimpleDateFormat("yyyy-MM-dd")
// scala语法,定义Register类(根据reg.tsv数据格式)
case class Register (d: java.util.Date, uuid: String, cust_id: String, lat: Float,lng: Float)
// scala语法,定义Click类(根据clk.tsv数据格式)
case class Click (d: java.util.Date, uuid: String, landing_page: Int)
// 加载hdfs上的文件reg.tsv并将每行数据转换为Register对象;
val reg = sc.textFile("hdfs://chenx:9000/week2/join/reg.tsv").map(_.split("\t")).map(r => (r(1), Register(format.parse(r(0)), r(1), r(2), r(3).toFloat, r(4).toFloat)))
// 加载hdfs上的文件clk.tsv并将每行数据转换为Click对象;
val clk = sc.textFile("hdfs://chenx:9000/week2/join/clk.tsv").map(_.split("\t")).map(c => (c(1), Click(format.parse(c(0)), c(1), c(2).trim.toInt)))
reg.join(clk).collect

Spark系列(二) Spark Shell各种操作及详细说明的更多相关文章
- 小白学习Spark系列二:spark应用打包傻瓜式教程(IntelliJ+maven 和 pycharm+jar)
在做spark项目时,我们常常面临如何在本地将其打包,上传至装有spark服务器上运行的问题.下面是我在项目中尝试的两种方案,也踩了不少坑,两者相比,方案一比较简单,本博客提供的jar包适用于spar ...
- Spark系列—02 Spark程序牛刀小试
一.执行第一个Spark程序 1.执行程序 我们执行一下Spark自带的一个例子,利用蒙特·卡罗算法求PI: 启动Spark集群后,可以在集群的任何一台机器上执行一下命令: /home/spark/s ...
- Spark系列—01 Spark集群的安装
一.概述 关于Spark是什么.为什么学习Spark等等,在这就不说了,直接看这个:http://spark.apache.org, 我就直接说一下Spark的一些优势: 1.快 与Hadoop的Ma ...
- Selenium系列(二) - 控制浏览器操作的详细解读
如果你还不想从头学起Selenium,可以看看这个系列的文章哦! https://www.cnblogs.com/poloyy/category/1680176.html 其次,如果你不懂前端基础知识 ...
- spark系列-2、Spark 核心数据结构:弹性分布式数据集 RDD
一.RDD(弹性分布式数据集) RDD 是 Spark 最核心的数据结构,RDD(Resilient Distributed Dataset)全称为弹性分布式数据集,是 Spark 对数据的核心抽象, ...
- ANDROID Porting系列二、配置一个新产品
ANDROID Porting系列二.配置一个新产品 详细说明 下面的步骤描述了如何配置新的移动设备和产品的makefile运行android. 1. 目录//vendor/创建一个公 ...
- spark教程(二)-shell操作
spark 支持 shell 操作 shell 主要用于调试,所以简单介绍用法即可 支持多种语言的 shell 包括 scala shell.python shell.R shell.SQL shel ...
- Spark 系列(二)—— Spark开发环境搭建
一.安装Spark 1.1 下载并解压 官方下载地址:http://spark.apache.org/downloads.html ,选择 Spark 版本和对应的 Hadoop 版本后再下载: 解压 ...
- Spark系列之二——一个高效的分布式计算系统
1.什么是Spark? Spark是UC Berkeley AMP lab所开源的类Hadoop MapReduce的通用的并行计算框架,Spark基于map reduce算法实现的分布式计算,拥有H ...
随机推荐
- 简单实现Ubuntu16.04 + caffe2 + CUDA9.0 + cuDNN8.0
在Ubuntu16.04 CUDA9.0 cuDNN8.0的环境下安装caffe2 本博客比较简单,cuda9.0 cudnn8.0部分请看上一篇博客,其中详细讲了: 如何安装驱动 安装cuda 安装 ...
- scrapy中的canonicalize_url【转】
转自:http://www.leyle.com/archives/canonicalize_url.html 思考一下:对url进行规范化处理是否是必须的?因为这一步处理涉及到编码转换,对于一个网页的 ...
- git看不到别人创建的远程分支
解决办法: $ git fetch //取回所有分支(branch)的更新.如果只想取回特定分支的更新,可以指定分支名,例:$ git fetch <远程主机名> <分支名> ...
- [osgearth]通过API创建一个earth模型
通过API的方式大体需要以下几个步骤: 创建map对象—— 创建影像数据层—— 创建高程数据层—— 将影像数据层以及高程数据层加入到map对象—— 根据前面创建的map对象创建mapNode节点—— ...
- JVM史上最佳入门指南
提到Java虚拟机(JVM),可能大部分人的第一印象是“难”,但当让我们真正走入“JVM世界”的时候,会发现其实问题并不像我们想象中的那么复杂.唯一真正令我们恐惧的,其实是恐惧本身.而作为整个JVM系 ...
- Lightoj-1220
https://vjudge.net/problem/LightOJ-1220 求x=bp中最大的p,x可能为负数. 因数分解,x=p1x1*p2x2*...*pnxn x=(p1x1'*p2x2'* ...
- C#属性升级版--自动属性-chapter 3 P34-36
使用C#属性,能够通过将数据与它的设置和检索方法分离的方式公开类中的一段数据. 例如: namespace LanguageFeatures { public class Product { ...
- python 字符串、列表、字典相关内建方法
"""字符串相关内建方法""" # a = ["qwe", "name", "sex&qu ...
- iOS UI-静态单元格与动态单元格
- laravel框架中使用Validator::make()方法报错
在控制器中用到了Validator::make(),它默认是use Dotenv\Validator; 但这样会出现 FatalErrorException错误 call to undefined m ...