
【Treatment-Rec 论文阅读】Data-driven Automatic Treatment Regimen Development and Recommendation
Data-driven Automatic Treatment Regimen Development and Recommendation
Authors: Leilei Sun, Chuanren Liu, Chonghui Guo, Hui Xiong, Yanming Xie
Keywords: Treatment Regimen; Treatment Recommendation, Electronic Medical Records; Temporal Sets.
KDD’16 大连理工大学 (Dalian University of Technology),卓克索大学 (Drexel University),中国中医科学院 (China Academy of China Medical Sciences)
论文链接:https://dl.acm.org/doi/pdf/10.1145/2939672.2939866
0. 总结
本文方法比较清晰,专注于脑梗塞这一种疾病,给新进入系统的病人推荐治疗方案。但假设比较强,是治疗方案推荐的很好的初步尝试。
数据是在中国收集的,不知道相关数据集和代码是否已经公开?
1.研究目标
根据历史病历数据,对患者和治疗方案分别进行分类,并提取出一些典型的治疗方案。对新患者,根据患者基本信息和诊断信息,推荐相应的治疗方案,辅助医疗决策,提高治愈率和治疗有效性。
2.问题背景
电子病历信息没有被充分利用,医疗资源分布不均,大数据手段可以提高医疗效率,提高整体医疗水平。
3. 问题定义-EMR 的内容
本文用到的电子医疗记录(Electronic Medical Records, EMRs)主要包含以下五种信息:
3.1 人口统计信息 Demographic Information
包含患者的基本信息,如性别、年龄、家庭住址、种族、受教育程度等信息。
3.2 诊断信息 Diagnostic Information
包含疾病名称和严重程度
3.3 医嘱 Doctor Order
包含药物名称、使用方式、剂量、频率、开始日期和结束日期。
3.4 治疗方案 Treatment
治疗方案是在医嘱之上整理出来的,记录患者每天接受了哪些治疗。
进一步,可以将患者的病程分为几个阶段,每个阶段都有几个治疗方案,其中记录了患者接受了哪些治疗,分别接受了几次(这里就不记录这几次治疗具体发生的日期,而是只记录次数)。
3.5 结果 Outcome
结果指患者出院时医生对患者的状态评估,可以分为“治愈(cured)“,“改善(improved)”,“无效(ineffective)”,“死亡(dead)”。
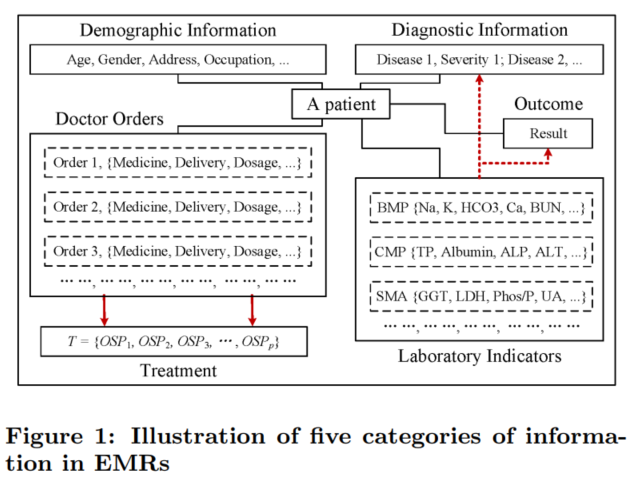
上面五种信息中,前两个(基本信息和诊断信息)可以视为条件,第四个(治疗方案)可以视为干预变量,最后一个(结果)可以视为目标。
4. 方法
4.1 治疗方案相似度度量
总体思路:每个患者的治疗方案可以被分为多个阶段的治疗方案,每个阶段的治疗方案包含用了哪些药物,以及服用方式、剂量和使用次数。在相似度度量时,首先度量各个对应阶段之间的相似度(如果阶段数量不一样怎么办?),然后再整合得到整体相似度。
- 治疗方案相似度首先被拆分为药物之间的相似度——相同名称的药物会有非零相似度,再根据服用方式、剂量和频率来计算一个0到1之间的相似度数值。
- 两个分阶段治疗方案之间的相似度变为两个集合之间的相似度度量,其中集合元素之间的相似度已知。
- 本文提出一种矩阵,将元素之间的相似度加权组合为集合之间的相似度。
- 得到各个阶段治疗方案的相似度之后,再加权平均得到两个治疗方案的整体相似度
4.2 治疗方案聚类
基于治疗方案之间的相似度,本文提出一种基于密度峰值的聚类算法,可以得到治疗方案的聚类中心。
4.3 提取典型治疗方案
由于本场景的特殊性,聚类中心的治疗方案也无法完全代表这类每个类别,仍需进一步处理。
具体来说,就是看一下哪些药物用的比较多,再提取一下典型的使用剂量、使用方式和持续时间等信息。
4.4 治疗方案推荐
对病人也进行分类(决策树),每个叶子节点认为是一个类型的患者,然后看一下这些患者使用哪个典型治疗方案比较多,就作为这个叶子节点的推荐方案。
5. 实验
5.1 数据
数据来自中国14家三甲医院,分布在北京,石家庄,深圳,济南,长春,福州和西安。
实验专注于脑梗塞的药物推荐。
收集了2.7万的患者数据,医嘱数量100万。
5.2 提取典型治疗方案
其中使用了1090种药物,但大多数药物都是用于治疗其他疾病的。本文选取了138种最相关的药物,有36万医嘱包含这些药物,平均每个患者13个。
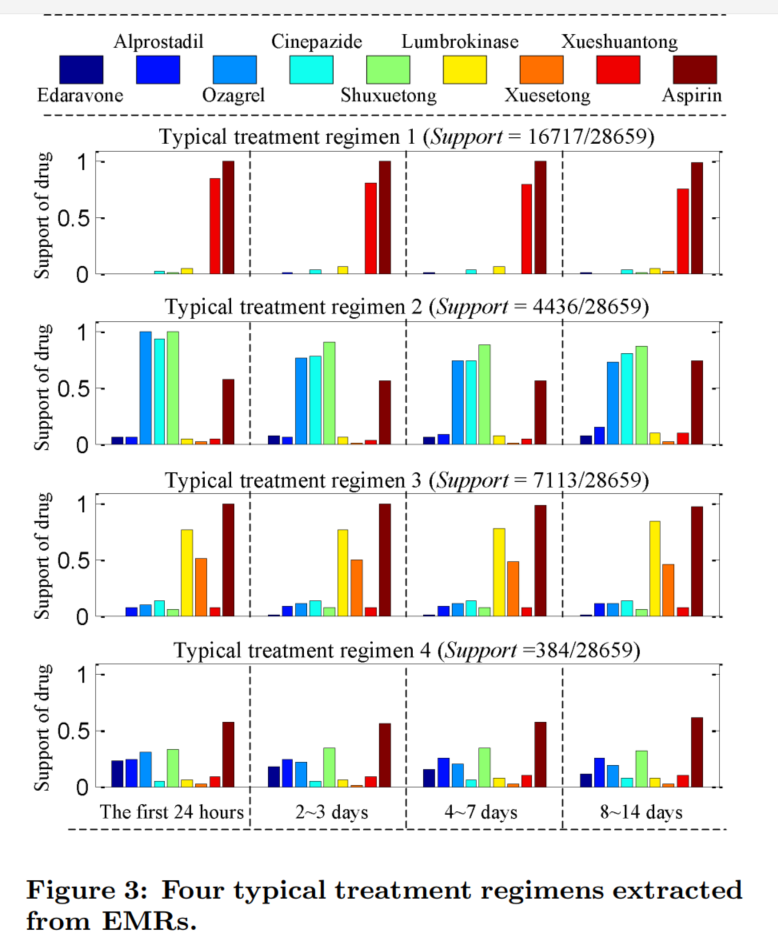
治疗过程分为四个阶段:前24小时、2-3天、4-7天、8-14天。
最终提取出四种典型的治疗方案
5.3 治疗方案推荐
对病人进行分类,分了17个类别。每个类别找一个治疗效果最好的(不一定是使用最多的)作为推荐结果。
5.4 推荐效果评估
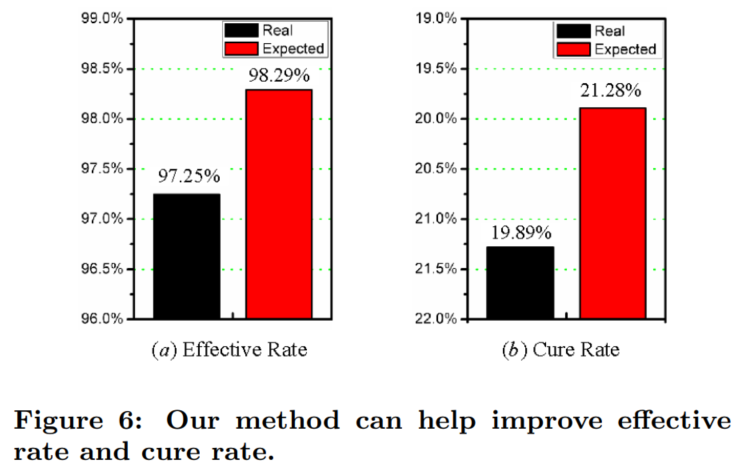
由于每个类别都找到了统计上治疗效果最好的治疗方案,假设这些治疗方案推广到这个类别上的所有患者,再假设推广到其他患者身上之后仍然有这么好的治疗效果,计算一下推广之后,总体的治疗有效率和治愈率能提升多少。
【Treatment-Rec 论文阅读】Data-driven Automatic Treatment Regimen Development and Recommendation的更多相关文章
- 论文阅读笔记 - Mesos: A Platform for Fine-Grained ResourceSharing in the Data Center
作者:刘旭晖 Raymond 转载请注明出处 Email:colorant at 163.com BLOG:http://blog.csdn.net/colorant/ 更多论文阅读笔记 http:/ ...
- 论文阅读笔记 Improved Word Representation Learning with Sememes
论文阅读笔记 Improved Word Representation Learning with Sememes 一句话概括本文工作 使用词汇资源--知网--来提升词嵌入的表征能力,并提出了三种基于 ...
- [置顶]
人工智能(深度学习)加速芯片论文阅读笔记 (已添加ISSCC17,FPGA17...ISCA17...)
这是一个导读,可以快速找到我记录的关于人工智能(深度学习)加速芯片论文阅读笔记. ISSCC 2017 Session14 Deep Learning Processors: ISSCC 2017关于 ...
- 【医学图像】3D Deep Leaky Noisy-or Network 论文阅读(转)
文章来源:https://blog.csdn.net/u013058162/article/details/80470426 3D Deep Leaky Noisy-or Network 论文阅读 原 ...
- Event StoryLine Corpus 论文阅读
Event StoryLine Corpus 论文阅读 本文是对 Caselli T, Vossen P. The event storyline corpus: A new benchmark fo ...
- Nature/Science 论文阅读笔记
Nature/Science 论文阅读笔记 Unsupervised word embeddings capture latent knowledge from materials science l ...
- YOLO 论文阅读
YOLO(You Only Look Once)是一个流行的目标检测方法,和Faster RCNN等state of the art方法比起来,主打检测速度快.截止到目前为止(2017年2月初),YO ...
- [论文阅读]阿里DIN深度兴趣网络之总体解读
[论文阅读]阿里DIN深度兴趣网络之总体解读 目录 [论文阅读]阿里DIN深度兴趣网络之总体解读 0x00 摘要 0x01 论文概要 1.1 概括 1.2 文章信息 1.3 核心观点 1.4 名词解释 ...
- [论文阅读笔记] metapath2vec: Scalable Representation Learning for Heterogeneous Networks
[论文阅读笔记] metapath2vec: Scalable Representation Learning for Heterogeneous Networks 本文结构 解决问题 主要贡献 算法 ...
- [论文阅读笔记] node2vec Scalable Feature Learning for Networks
[论文阅读笔记] node2vec:Scalable Feature Learning for Networks 本文结构 解决问题 主要贡献 算法原理 参考文献 (1) 解决问题 由于DeepWal ...
随机推荐
- 【SpringBoot】13 数据访问P1 整合Jdbc
SpringBoot与数据访问概述: 对于数据访问层,无论是SQL还是NOSQL,Spring Boot默认采用整合Spring Data的方式进行统一处理, 添加大量自动配置,屏蔽了很多设置.引入各 ...
- TensorFlow图像预处理函数
预处理图像 文件名: cat.jpg 读取.打印图片 import matplotlib.pyplot as plt import tensorflow as tf import nump ...
- python多进程multiprocessing模块的变量传递问题:父进程中的numpy.array对象隐式序列化到子进程后的inplace操作的问题
参考: https://docs.python.org/zh-cn/3/library/multiprocessing.html cloudpickle -- Python分布式序列化的专用模块 ...
- AQS专题
1.背景 2.预备知识 2.1.park.unpark.interrupt.isInterrupted.interrupted方法的理解 一:park.unpark 1.park.unpark它不是T ...
- centos7系统 通过编译安装gcc7.5.0
背景: 现有的centos7 gcc的最高版本为4.8.5 项目需要升级到7.1.0以上 正常方式可以通过以下命令即可完成升级: $ sudo yum install centos-release-s ...
- Gradle 项目打开自动下载Zip问题及相关配置
原因 : 由于使用Eclipse开发,导入了SpringCloud 工程,SpringCloud 自从哪个版本忘了昂,选择了Gradle 作为工程管理工具,至于为啥,你去问问官方,我的了解是为了支持G ...
- WPF,图表控件
开源代码地址:https://github.com/bearhanQ/WPFFramework; QQ群:332035933: <UserControl x:Class="WpfBoo ...
- Codeforces Round894.D
题目:D. Ice Cream Balls 题目链接:https://codeforces.com/contest/1862/problem/D 思路:二分找到当所有冰淇淋球类型不同的情况下,假设记位 ...
- AtCoder Beginner Contest 311
Toyota Programming Contest 2023#4(AtCoder Beginner Contest 311) A - First ABC (atcoder.jp) 记录一下\(ABC ...
- 9.150 Predefined macros
9.150 Predefined macros The ARM compiler predefines a number of macros. These macros provide informa ...