
Oracle中的substr()函数和INSTR()函数和mysql中substring_index函数字符截取函数用法:计算BOM系数用量拼接字符串*计算值方法
最近一直在研究计算产品BOM的成本系数,将拼接的元件用量拼接后拆分计算是个问题,后来受到大佬在mysql中截取字符串的启发在oracle中以substr和instr实现了
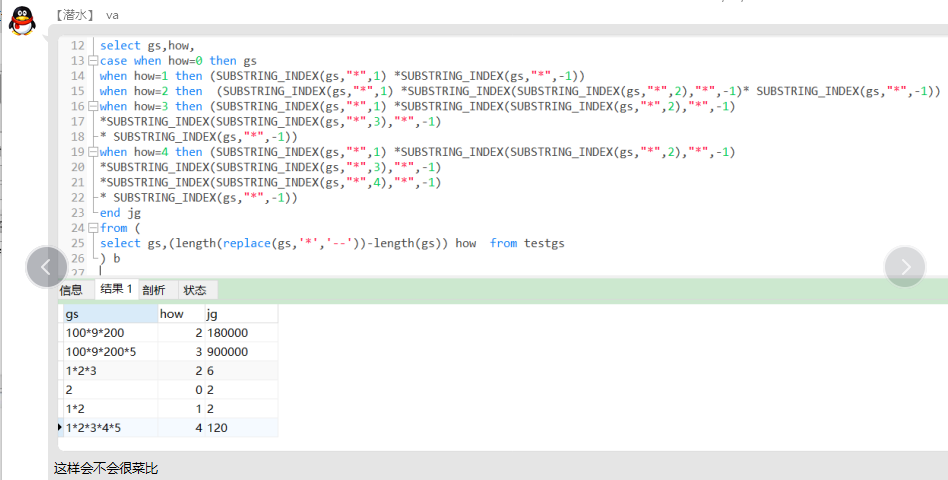
1.以下是我在mysql中重写的代码
mysql中使用substring_index
SUBSTRING_INDEX(str, delimiter, count)
返回一个 str 的子字符串,在 delimiter 出现 count 次的位置截取。
如果 count > 0,从则左边数起,且返回位置前的子串;
如果 count < 0,从则右边数起,且返回位置后的子串。
delimiter 是大小写敏感,且是多字节安全的。
取头字符串方法substring_index(gs, '*', 1)
取尾字符串方法substring_index(gs, '*', -1)
取中间字符串方法substring_index(substring_index(gs, '*', 3), '*', -1)
#1.创建测试数据
create table testgs3 as
select '1.1*4.52*1.1' gs
union all
select '2.5*4.5*1.5*2.2' x1
union all
select '1.0' x1
union ALL
select '2*.5*2.5';
#2.按测试数据进行截取计算
select gs,
how,
case
when how = 0 then gs
when how = 1 then substring_index(gs,'*', 1) *substring_index(gs,'*', -1)
when how = 2 then
substring_index(gs, '*', 1) * substring_index(substring_index(gs, '*', 2), '*', -1) *substring_index(gs, '*', -1)
when how = 3 then
substring_index(gs, '*', 1) *substring_index(substring_index(gs, '*', 2), '*', -1) * substring_index(substring_index(gs, '*', 3),'*', -1) * substring_index(gs, '*' ,- 1)
when how = 4 then
substring_index(gs, '*', 1) *substring_index(substring_index(gs, '*', 2), '*', -1) *substring_index(substring_index(gs, '*', 3), '*', -1) *substring_index(substring_index(gs, '*', 4), '*', -1) * substring_index(gs, '*', -1)
when how = 5 then
substring_index(gs, '*', 1) *substring_index(substring_index(gs, '*', 2), '*', -1) *substring_index(substring_index(gs, '*', 3), '*', -1) *substring_index(substring_index(gs, '*', 4), '*', -1)
*substring_index(substring_index(gs, '*', 5), '*', -1)* substring_index(gs, '*', -1)
when how = 6 then
substring_index(gs, '*', 1) *substring_index(substring_index(gs, '*', 2), '*', -1) *substring_index(substring_index(gs, '*', 3), '*', -1) *substring_index(substring_index(gs, '*', 4), '*', -1)
*substring_index(substring_index(gs, '*', 5), '*', -1)*substring_index(substring_index(gs, '*', 6), '*', -1)* substring_index(gs, '*', -1)
when how = 7 then
substring_index(gs, '*', 1) *substring_index(substring_index(gs, '*', 2), '*', -1) *substring_index(substring_index(gs, '*', 3), '*', -1) *substring_index(substring_index(gs, '*', 4), '*', -1)
*substring_index(substring_index(gs, '*', 5), '*', -1)*substring_index(substring_index(gs, '*', 6), '*', -1)* substring_index(substring_index(gs, '*', 7), '*', -1)*substring_index(gs, '*', -1)
when how = 8 then
substring_index(gs, '*', 1) *substring_index(substring_index(gs, '*', 2), '*', -1) *substring_index(substring_index(gs, '*', 3), '*', -1) *substring_index(substring_index(gs, '*', 4), '*', -1)
*substring_index(substring_index(gs, '*', 5), '*', -1)*substring_index(substring_index(gs, '*', 6), '*', -1)* substring_index(substring_index(gs, '*', 7), '*', -1)
*substring_index(substring_index(gs, '*', 8), '*', -1)*substring_index(gs, '*', -1)
when how = 9 then
substring_index(gs, '*', 1) *substring_index(substring_index(gs, '*', 2), '*', -1) *substring_index(substring_index(gs, '*', 3), '*', -1) *substring_index(substring_index(gs, '*', 4), '*', -1)
*substring_index(substring_index(gs, '*', 5), '*', -1)*substring_index(substring_index(gs, '*', 6), '*', -1)* substring_index(substring_index(gs, '*', 7), '*', -1)
*substring_index(substring_index(gs, '*', 8), '*', -1)*substring_index(substring_index(gs, '*', 9), '*', -1)*substring_index(gs, '*', -1)
end jg
from (select gs, (length(replace(gs, '*', '--')) - length(gs)) how
from testgs3)b
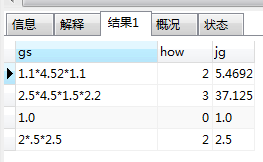
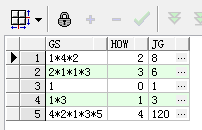
以下是运行后结果:
2.以下是我在ORACLE中实现字符串截取的方法:
ORACLE中使用SUBSTR和INSTR组合
1)substr函数格式 (俗称:字符截取函数)
格式1: substr(string string, int a, int b);
格式2:substr(string string, int a) ;
解释:
格式1:
1、string 需要截取的字符串
2、a 截取字符串的开始位置(注:当a等于0或1时,都是从第一位开始截取)
3、b 要截取的字符串的长度
格式2:
1、string 需要截取的字符串
2、a 可以理解为从第a个字符开始截取后面所有的字符串。
----创建测试数据
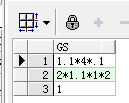
CREATE TABLE TESTGS AS
(SELECT '1.1*4*.1' GS FROM DUAL
UNION ALL
SELECT '2*1.1*1*2' X1 FROM DUAL
UNION ALL
SELECT '1' X1 FROM DUAL)
----拆分组成用量*的字符串lms220103
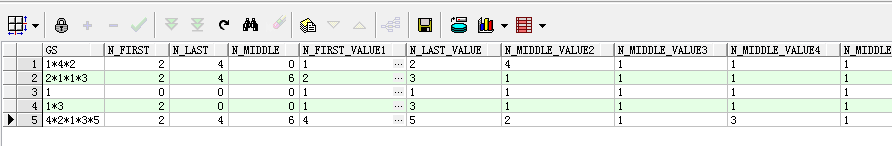
SELECT GS,
INSTR(GS, '*', 1, 1) N_FIRST,
INSTR(GS, '*', 1, 2) N_LAST,
INSTR(GS, '*', 1, 3) N_MIDDLE,
NVL(SUBSTR(GS, 0, INSTR(GS, '*', 1, 1) - 1), GS) N_FIRST_VALUE1,
NVL(SUBSTR(GS, -1, INSTR(GS, '*', -1, 1) + 1),1) N_LAST_VALUE,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 2) - 1), -1),1) N_MIDDLE_VALUE2,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 3) - 1), -1),1) N_MIDDLE_VALUE3,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 4) - 1), -1),1) N_MIDDLE_VALUE4,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 5) - 1), -1),1) N_MIDDLE_VALUE5,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 6) - 1), -1),1) N_MIDDLE_VALUE6,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 7) - 1), -1),1) N_MIDDLE_VALUE7,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 8) - 1), -1),1) N_MIDDLE_VALUE8,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 9) - 1), -1),1) N_MIDDLE_VALUE9,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 10) - 1), -1),1) N_MIDDLE_VALUE10
FROM (SELECT GS, (LENGTH(REPLACE(GS, '*', '00')) - LENGTH(GS)) HOW
FROM TESTGS)
实施:

----拆分组成用量*的字符串lms220103
WITH V_GS AS (SELECT GS,HOW,
INSTR(GS, '*', 1, 1) N_FIRST,
INSTR(GS, '*', 1, 2) N_LAST,
INSTR(GS, '*', 1, 3) N_MIDDLE,
NVL(SUBSTR(GS, 0, INSTR(GS, '*', 1, 1) - 1), GS) N_FIRST_VALUE1,
NVL(SUBSTR(GS, -1, INSTR(GS, '*', -1, 1) + 1),1) N_LAST_VALUE,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 2) - 1), -1),1) N_MIDDLE_VALUE2,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 3) - 1), -1),1) N_MIDDLE_VALUE3,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 4) - 1), -1),1) N_MIDDLE_VALUE4,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 5) - 1), -1),1) N_MIDDLE_VALUE5,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 6) - 1), -1),1) N_MIDDLE_VALUE6,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 7) - 1), -1),1) N_MIDDLE_VALUE7,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 8) - 1), -1),1) N_MIDDLE_VALUE8,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 9) - 1), -1),1) N_MIDDLE_VALUE9,
NVL(SUBSTR(SUBSTR(GS, 0, INSTR(GS, '*', 1, 10) - 1), -1),1) N_MIDDLE_VALUE10
FROM (SELECT GS, (LENGTH(REPLACE(GS, '*', '00')) - LENGTH(GS)) HOW
FROM TESTGS))
SELECT GS,
HOW,
(CASE
WHEN HOW = 0 THEN
GS
WHEN HOW = 1 THEN to_char(N_FIRST_VALUE1*N_LAST_VALUE)
WHEN HOW = 2 THEN to_char(N_FIRST_VALUE1*N_MIDDLE_VALUE2*N_LAST_VALUE)
WHEN HOW = 3 THEN to_char(N_FIRST_VALUE1*N_MIDDLE_VALUE2*N_MIDDLE_VALUE3*N_LAST_VALUE)
WHEN HOW = 4 THEN to_char(N_FIRST_VALUE1*N_MIDDLE_VALUE2*N_MIDDLE_VALUE3*N_MIDDLE_VALUE4*N_LAST_VALUE)
WHEN HOW = 5 THEN to_char(N_FIRST_VALUE1*N_MIDDLE_VALUE2*N_MIDDLE_VALUE3*N_MIDDLE_VALUE4*N_MIDDLE_VALUE5*N_LAST_VALUE)
WHEN HOW = 6 THEN to_char(N_FIRST_VALUE1*N_MIDDLE_VALUE2*N_MIDDLE_VALUE3*N_MIDDLE_VALUE4*N_MIDDLE_VALUE5*N_MIDDLE_VALUE6*N_LAST_VALUE)
WHEN HOW = 7 THEN to_char(N_FIRST_VALUE1*N_MIDDLE_VALUE2*N_MIDDLE_VALUE3*N_MIDDLE_VALUE4*N_MIDDLE_VALUE5*N_MIDDLE_VALUE6*N_MIDDLE_VALUE7*N_LAST_VALUE)
WHEN HOW = 8 THEN to_char(N_FIRST_VALUE1*N_MIDDLE_VALUE2*N_MIDDLE_VALUE3*N_MIDDLE_VALUE4*N_MIDDLE_VALUE5*N_MIDDLE_VALUE6*N_MIDDLE_VALUE7*N_MIDDLE_VALUE8*N_LAST_VALUE)
WHEN HOW = 9 THEN to_char(N_FIRST_VALUE1*N_MIDDLE_VALUE2*N_MIDDLE_VALUE3*N_MIDDLE_VALUE4*N_MIDDLE_VALUE5*N_MIDDLE_VALUE6*N_MIDDLE_VALUE7*N_MIDDLE_VALUE8*N_MIDDLE_VALUE9*N_LAST_VALUE)
WHEN HOW = 10 THEN to_char(N_FIRST_VALUE1*N_MIDDLE_VALUE2*N_MIDDLE_VALUE3*N_MIDDLE_VALUE4*N_MIDDLE_VALUE5*N_MIDDLE_VALUE6*N_MIDDLE_VALUE7*N_MIDDLE_VALUE8*N_MIDDLE_VALUE9*N_MIDDLE_VALUE10*N_LAST_VALUE)
else '请联系开发更新代码'
END) JG
FROM V_GS
运行的结果:
Oracle中的substr()函数和INSTR()函数和mysql中substring_index函数字符截取函数用法:计算BOM系数用量拼接字符串*计算值方法的更多相关文章
- Oracle substr() 字符截取函数
1.substr函数格式 (俗称:字符截取函数) 格式1: substr(string string, int a, int b); 格式2:substr(string string, int a ...
- MySQL 中的反引号(`):是为了区分 MySql 关键字与普通字符而引入的符号;一般,表名与字段名都使用反引号。
MySQL 中的反引号(`):是为了区分 MySql 关键字与普通字符而引入的符号:一般,表名与字段名都使用反引号.
- Sql Server中的nvarchar(n)、varchar(n) 和Mysql中的char(n)、varchar(n)
刚才有幸看了下 nvarchar(n)和varchar(n),感觉以前的认知有误. nvarchar(n):n指的是字符个数,范围是1-4000,存储的是可变长度的Unicode字符数据. 按字符存储 ...
- mysql 字段包含某个字符的函数
通过sql查询语句,查询某个字段中包含特定字符串: 例子:查询e_book表的types字段包含字符串"3",有下面4种方式 select * from e_book where ...
- EL中拼接字符串的方法
近期在项目中碰到一个需要在JSP页面中比较两String类型的值的问题,于是想当然的写了如下代码: <c:if test="${'p'+longValue=='p1'}"&g ...
- Oracle中的substr()函数 详解及应用
注:本文来源于<Oracle中的substr()函数 详解及应用> 1)substr函数格式 (俗称:字符截取函数) 格式1: substr(string string, int a, ...
- Oracle中的substr()函数详解案例
1)substr函数格式 (俗称:字符截取函数) 格式1: substr(string string, int a, int b); 格式2:substr(string string, int a ...
- JavaScript中字符串截取函数slice()、substring()、substr()
在js中字符截取函数有常用的三个slice().substring().substr()了,下面我来给大家介绍slice().substring().substr()函数在字符截取时的一些用法与区别吧 ...
- 数据库Oracle字符处理函数
练习字符处理函数(数据库表都是从1开始),我们用到一张"伪表" dual: dual 表:dual 是一张只有一个字段,一行记录的表.dual 表也称之为'伪表',因为他不存储主题 ...
- MySQL 中的 FOUND_ROWS() 与 ROW_COUNT() 函数
移植sql server 的存储过程到mysql中,遇到了sql server中的: IF @@ROWCOUNT < 1 对应到mysql中可以使用 FOUND_ROWS() 函数来替换. 1. ...
随机推荐
- 从JDK源码级深入剖析main方法的运行机制
如果你是一名Java应用开发工程师,你应该对"public static void main(String[] args)"这段代码再熟悉不过了,然而你是否了解main方法是如何调 ...
- 如何让一句话木马绕过waf ?
一.什么是一句话木马? 一句话木马就是只需要一行代码的木马,短短一行代码,就能做到和大马相当的功能.为了绕过waf的检测,一句话木马出现了无数中变形,但本质是不变的:木马的函数执行了我们发送的命令. ...
- prometheus Histogram 统计原理
大家好,我是蓝胖子,书接上文,我在prometheus描点原理那一篇文章里,留了一个思考题: 我们通常会用到histogram_quantile去计算服务接口时间的耗时情况. histogram_qu ...
- 【2020GET】即构科技蒋宁波:教育行业客户需求的核心是什么?
11月24日,由即构科技主办的2020GET大会教育科技分论坛在北京成功召开,来自叮咚课堂.小冰.360OS.蕃茄田艺术.即构科技的6位资深教育/科技大咖,在论坛上进行深度分享. 以下为即构科技联合创 ...
- 防缓存穿透利器-布隆滤器(BloomFilter)
布隆过滤器 1.布隆过滤器原理 1.1 什么是布隆过滤器 1.2 使用场景 1.3 原理 1.4 布隆过滤器的优缺点 2.实现方式 2.1 初始化skuId的布隆过滤器 2.1.1 RedisCons ...
- Windows商店开发者注册失败
前言 最近写了个小工具想上架Windows应用商店,但是在填写信息那一页总是失败,提示Error code 2201. Correlation ID 9d436e3a-94df-498a-b224-8 ...
- 我真的想知道,AI框架跟计算图什么关系?PyTorch如何表达计算图?
目前主流的深度学习框架都选择使用计算图来抽象神经网络计算表达,通过通用的数据结构(张量)来理解.表达和执行神经网络模型,通过计算图可以把 AI 系统化的问题形象地表示出来. 本节将会以AI概念落地的时 ...
- Vortex Indicator 构建交易策略
更多精彩内容,欢迎关注公众号:数量技术宅,也可添加技术宅个人微信号:sljsz01,与我交流. 今天的文章,我们将为大家介绍一个与DMI(Directional Movement Index)类似,判 ...
- Angular报错:Error: Unknown argument: spec
解决方案 使用--skip-tests代替 效果展示 可以看到spec.ts消失了 参考链接 https://stackoverflow.com/questions/62228834/angular- ...
- JVM调优篇:探索Java性能优化的必备种子面试题
JVM内存模型 首先面试官会询问你在进行JVM调优之前,是否了解JVM内存模型的基础知识.这是一个重要的入门问题.JVM内存模型主要包括程序计数器.堆.本地方法栈.Java栈和方法区(1.7之后更改为 ...