
python 爬虫学习<将某一页的所有图片下载下来>
在我们日常上网浏览网页的时候,经常会看到一些好看的图片,我们就希望把这些图片保存下载,或者用户用来做桌面壁纸,或者用来做设计的素材。
我们最常规的做法就是通过鼠标右键,选择另存为。但有些图片鼠标右键的时候并没有另存为选项,还有办法就通过就是通过截图工具截取下来,但这样就降低图片的清晰度。好吧~!其实你很厉害的,右键查看页面源代码。
我们可以通过python 来实现这样一个简单的爬虫功能,把我们想要的代码爬取到本地。下面就看看如何使用python来实现这样一个功能。
一,获取整个页面数据
首先我们可以先获取要下载图片的整个页面信息。
getjpg.py

#coding=utf-8

import urllib

def getHtml(url):

    page = urllib.urlopen(url)

    html = page.read()

    return html

html = getHtml("http://tieba.baidu.com/p/2738151262")

print html
Urllib 模块提供了读取web页面数据的接口,我们可以像读取本地文件一样读取www和ftp上的数据。首先,我们定义了一个getHtml()函数:
urllib.urlopen()方法用于打开一个URL地址。
read()方法用于读取URL上的数据,向getHtml()函数传递一个网址,并把整个页面下载下来。执行程序就会把整个网页打印输出。
二,筛选页面中想要的数据
Python 提供了非常强大的正则表达式,我们需要先要了解一点python 正则表达式的知识才行。
http://www.cnblogs.com/fnng/archive/2013/05/20/3089816.html
假如我们百度贴吧找到了几张漂亮的壁纸,通过到前段查看工具。找到了图片的地址,如:src=”http://imgsrc.baidu.com/forum......jpg”pic_ext=”jpeg”
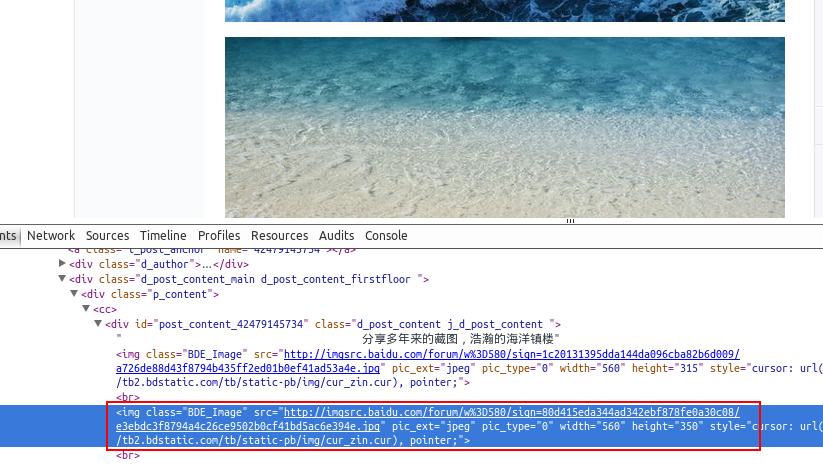
修改代码如下:
import re

import urllib

def getHtml(url):

    page = urllib.urlopen(url)

    html = page.read()

    return html

def getImg(html):

    reg = r'src="(.+?\.jpg)" pic_ext'

    imgre = re.compile(reg)

    imglist = re.findall(imgre,html)

    return imglist

html = getHtml("http://tieba.baidu.com/p/2460150866")

print getImg(html)
我们又创建了getImg()函数,用于在获取的整个页面中筛选需要的图片连接。re模块主要包含了正则表达式:
re.compile() 可以把正则表达式编译成一个正则表达式对象.
re.findall() 方法读取html 中包含 imgre(正则表达式)的数据。
运行脚本将得到整个页面中包含图片的URL地址。
三,将页面筛选的数据保存到本地
把筛选的图片地址通过for循环遍历并保存到本地,代码如下:
#coding=utf-8

import urllib

import re

def getHtml(url):

    page = urllib.urlopen(url)

    html = page.read()

    return html

def getImg(html):

    reg = r'src="(.+?\.jpg)" pic_ext'

    imgre = re.compile(reg)

    imglist = re.findall(imgre,html)

    x = 0

    for imgurl in imglist:

        urllib.urlretrieve(imgurl,'%s.jpg' % x)

        x+=1

html = getHtml("http://tieba.baidu.com/p/2460150866")

print getImg(html)
这里的核心是用到了urllib.urlretrieve()方法,直接将远程数据下载到本地。
通过一个for循环对获取的图片连接进行遍历,为了使图片的文件名看上去更规范,对其进行重命名,命名规则通过x变量加1。保存的位置默认为程序的存放目录。
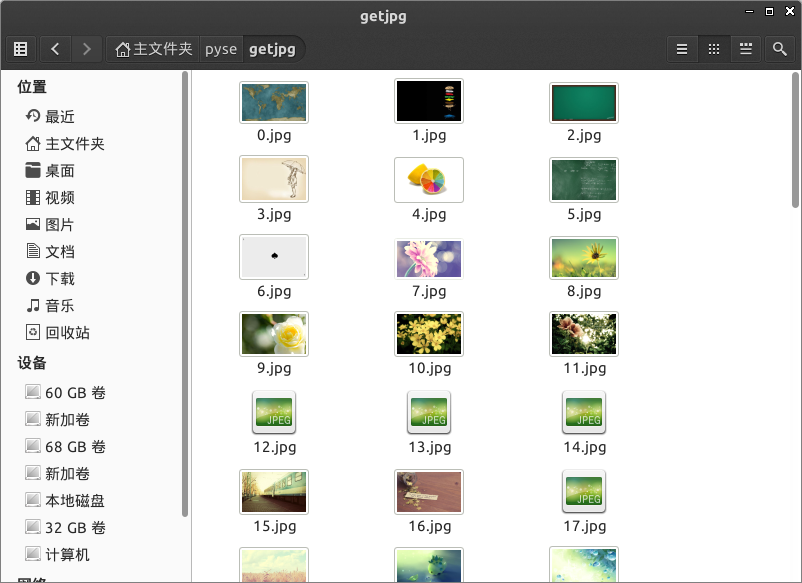
程序运行完成,将在目录下看到下载到本地的文件。
python 爬虫学习<将某一页的所有图片下载下来>的更多相关文章
- python爬虫学习(1) —— 从urllib说起
0. 前言 如果你从来没有接触过爬虫,刚开始的时候可能会有些许吃力 因为我不会从头到尾把所有知识点都说一遍,很多文章主要是记录我自己写的一些爬虫 所以建议先学习一下cuiqingcai大神的 Pyth ...
- python爬虫学习 —— 总目录
开篇 作为一个C党,接触python之后学习了爬虫. 和AC算法题的快感类似,从网络上爬取各种数据也很有意思. 准备写一系列文章,整理一下学习历程,也给后来者提供一点便利. 我是目录 听说你叫爬虫 - ...
- Python爬虫学习:三、爬虫的基本操作流程
本文是博主原创随笔,转载时请注明出处Maple2cat|Python爬虫学习:三.爬虫的基本操作与流程 一般我们使用Python爬虫都是希望实现一套完整的功能,如下: 1.爬虫目标数据.信息: 2.将 ...
- Python爬虫学习:四、headers和data的获取
之前在学习爬虫时,偶尔会遇到一些问题是有些网站需要登录后才能爬取内容,有的网站会识别是否是由浏览器发出的请求. 一.headers的获取 就以博客园的首页为例:http://www.cnblogs.c ...
- Python爬虫学习:二、爬虫的初步尝试
我使用的编辑器是IDLE,版本为Python2.7.11,Windows平台. 本文是博主原创随笔,转载时请注明出处Maple2cat|Python爬虫学习:二.爬虫的初步尝试 1.尝试抓取指定网页 ...
- 《Python爬虫学习系列教程》学习笔记
http://cuiqingcai.com/1052.html 大家好哈,我呢最近在学习Python爬虫,感觉非常有意思,真的让生活可以方便很多.学习过程中我把一些学习的笔记总结下来,还记录了一些自己 ...
- python爬虫学习视频资料免费送,用起来非常666
当我们浏览网页的时候,经常会看到像下面这些好看的图片,你是否想把这些图片保存下载下来. 我们最常规的做法就是通过鼠标右键,选择另存为.但有些图片点击鼠标右键的时候并没有另存为选项,或者你可以通过截图工 ...
- python爬虫学习笔记(一)——环境配置(windows系统)
在进行python爬虫学习前,需要进行如下准备工作: python3+pip官方配置 1.Anaconda(推荐,包括python和相关库) [推荐地址:清华镜像] https://mirrors ...
- [转]《Python爬虫学习系列教程》
<Python爬虫学习系列教程>学习笔记 http://cuiqingcai.com/1052.html 大家好哈,我呢最近在学习Python爬虫,感觉非常有意思,真的让生活可以方便很多. ...
随机推荐
- ios 个人开发者账户 给其他团队用坑爹的教程
最新版本的 ios 支持 3个开发者证书 和 3个发布者证书 ,如果是多余3台电脑设备要真机调试,就比较麻烦 (手机支持100个设备) 解决方案就是: 在别人的电脑上要成功安装,须具备两个文件: ...
- 缓存数据库-redis介绍
一:Redis 简介 Redis 是完全开源免费的,遵守BSD协议,是一个高性能的key-value数据库. Redis 与其他 key - value 缓存产品有以下三个特点: Redis支持数据的 ...
- python网络编程-optparse
Python 有两个内建的模块用于处理命令行参数: 一个是 getopt,<Deep in python>一书中也有提到,只能简单处理 命令行参数: 另一个是 optparse,它功能强大 ...
- 密码记录工具keepass保存密码
https://www.cnblogs.com/wicub/p/5753005.html
- java 多线程总结篇4——锁机制
在开发Java多线程应用程序中,各个线程之间由于要共享资源,必须用到锁机制.Java提供了多种多线程锁机制的实现方式,常见的有synchronized.ReentrantLock.Semaphore. ...
- NYOJ 石子合并(一)(区间DP)
题目链接:http://acm.nyist.edu.cn/JudgeOnline/problem.php?pid=737 题目大意: 有N堆石子排成一排,每堆石子有一定的数量.现要将N堆石子并成为一堆 ...
- Linux--忘记MySQL密码的解决方法和输入mysqld_safe --skip-grant-tables &后无法进入MySQL的解决方法
https://blog.csdn.net/qq_35389417/article/details/78910974
- jquery中获取radio选中值的正确写法
错误写法: //只在IE下有作用,其他浏览器均获取的为第一个单选框的值 $('input[type=radio]').val(); 正确写法为: //兼容所有浏览器写法 $('input[type=r ...
- Vue.js学习笔记(一) - 起步
本篇将简单介绍一下Vue.js,并在Node.js环境下搭建一个简单的Demo. 一.简介 我个人理解,Vue.js是一套前端视图层的框架,它只关心视图展示和数据绑定,它的一些语法与Angular 1 ...
- 2017-2018 ACM-ICPC, NEERC, Moscow Subregional Contest B - Byteland Trip dp
B - Byteland Trip 题目大意:给你一个由'<' 和 '>'组成的串, 如果在'<' 只能前往编号比它小的任意点, 反之只能前往比它大的任意点,问你能遍历所有点 并且每 ...