
Python爬虫实战---抓取图书馆借阅信息
Python爬虫实战---抓取图书馆借阅信息
原创作品,引用请表明出处:Python爬虫实战---抓取图书馆借阅信息
前段时间在图书馆借了很多书,借得多了就容易忘记每本书的应还日期,老是担心自己会违约,影响日后借书,而自己又懒得总是登录到学校图书馆借阅系统查看,于是就打算写一个爬虫来抓取自己的借阅信息,把每本书的应还日期给爬下来,并写入txt文件,这样每次忘了就可以打开该txt文件查看,每次借阅信息改变了,只要再重新运行一遍该程序,原txt文件就会被新文件覆盖,里面的内容得到更新。
用到的技术:
Python版本是 2.7 ,同时用到了urllib2、cookielib、re三个模块。urllib2用于创建请求(request),并抓取网页信息,返回一个类似于文件类型的response对象;cookielib用于储存cookie对象,以实现模拟登录功能;re模块提供对正则表达式的支持,用于对抓取到的页面信息进行匹配,以得到自己想要的信息。
抓取一个页面:
使用urllib2简单抓取一个网页的过程非常简单:
 import urllib2

 response = urllib2.urlopen("http://www.baidu.com")

 html = response.read()
urllib2中的urlopen()方法,看其字面意思就知道是打开一个URL(uniform resource locator)地址,上面例子传入的时百度首页的地址,遵循HTTP协议,除了http协议外,urlopen()方法还可以打开遵循ftp、file协议的地址,如:
response = urllib2.urlopen("ftp://example.com")
除URL参数外,urlopen()方法还接受data和timeout参数:
response = urllib2.urlopen(url ,data ,timeout)
其中data是打开一个网页时需要传入的数据,比如打开一个登录界面时往往需要传入用户名和密码等信息,在下文登录图书馆系统时将会看到其用法;timeout是设置超时时间,即超过一定时间页面无响应即报错;在urlopen()方法中,data和timeout不是必须的,即可填可不填,注意:当页面需要有数据传入时,data是必需的。
可以看到,在打开一个网页时,有时往往需要传入多个参数,再加上HTTP协议是基于请求(request)和应答(response)的,即客户端发出请求(request),服务器端返回应答(response),所以在使用urlopen()方法时,往往是构造一个request对象作为参数传入,该request对象包括url、data、timeout、headers等信息:
 import urllib2

 request = urllib2.Request("http://www.baidu.com")

 response = urllib2.urlopen(request)

 html = response.read()
这段代码得到的结果和上面得到的结果一样,但是在逻辑上显得更明确、清晰。
Cookie的使用:
在访问某些网站时,该网站需要在客户端本地储存一些数据、信息(经过加密),并在接下来的请求(request)中返回给服务器,否则服务器将拒绝该请求,这些数据即存储在本地的cookie中。例如,访问学校图书馆系统时,需进行登录,等登录完成之后,服务器端将会在本地储存一些经过加密的数据在cookie中,当客户端发送查询借阅信息的请求(request)时,会连带cookie里面的数据一起发送给服务器,服务器确定cookie信息后允许访问,否则拒绝该请求。
Cookielib模块提供了CookieJar类用于捕捉和储存HTTP 的cookie数据,所以要创建一个cookie只要创建一个CookieJar实例即可:
 import cookielib

 cookie = coolielib.CookieJar()
创建cookie了就万事大吉了吗?没那么简单,我们要完成的操作是发送登录请求、记录cookie、再发送读取借阅信息的请求并向服务器反馈cookie信息,要完成这一系列的操作,原来的urlopen()方法已不能胜任,幸运的是,urllib2模块还提供了一个OpenerDirector类,可以接受一个cookie处理器为参数,实现上述功能,而这个cookie处理器则可以通过HTTPCookieProcessor类接受一个cookie对象实例化后得到。即先通过HTTPCookieProcessor实例化得到一个cookie处理器handler,再将此处理器headler作为参数传入OpenDirector实例化得到一个能捕捉cookie数据的opener,代码如下:
 import urllib2

 import cookielib

 cookie = cookielib.CookieJar()

 handler = urllib2.HTTPCookieProcessor(cookie)

 opener = urllib2.build_opener(handler)

 response = opener.open("http://www.baidu.com")
登录图书馆系统:
至此,我们就可以进行图书馆借阅信息的抓取了。来看看hit图书馆登录界面:

首先,在Firefox浏览器下,借助httpfox插件进行网络监听,看看登录此页面需要向服务器发送哪些数据:
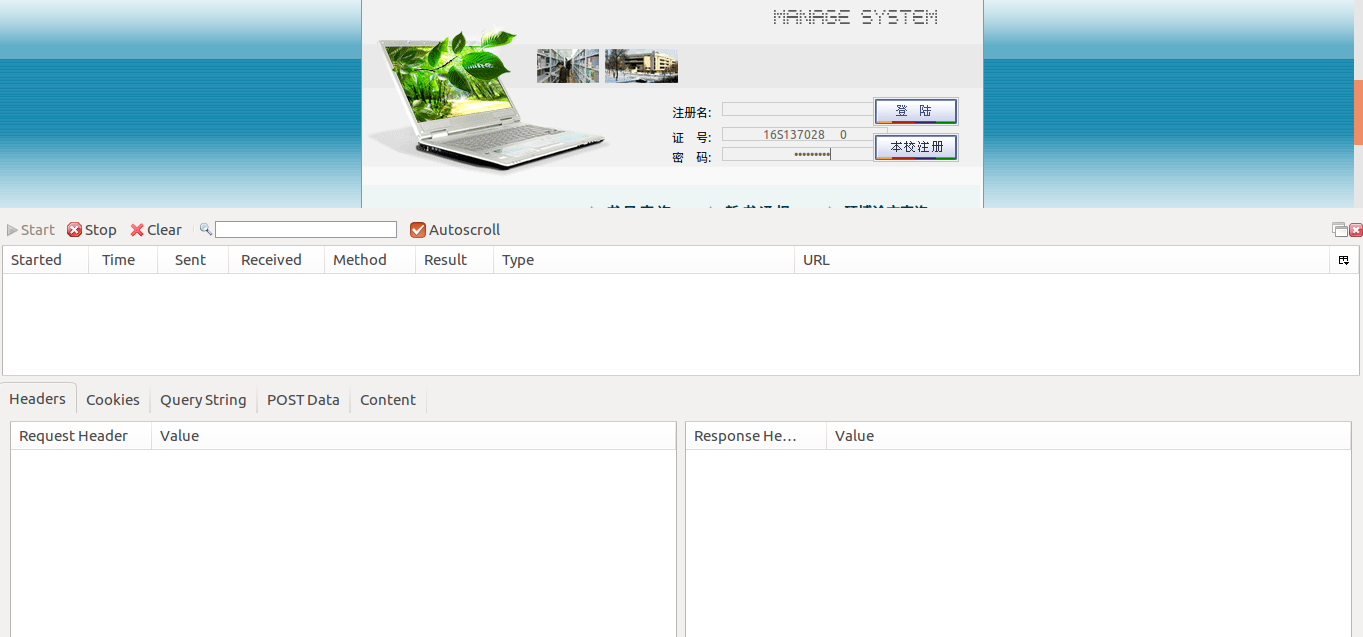
输入登录账号和密码,打开httpfox插件,点击start开始监听,然后点击登陆按钮进行登陆:
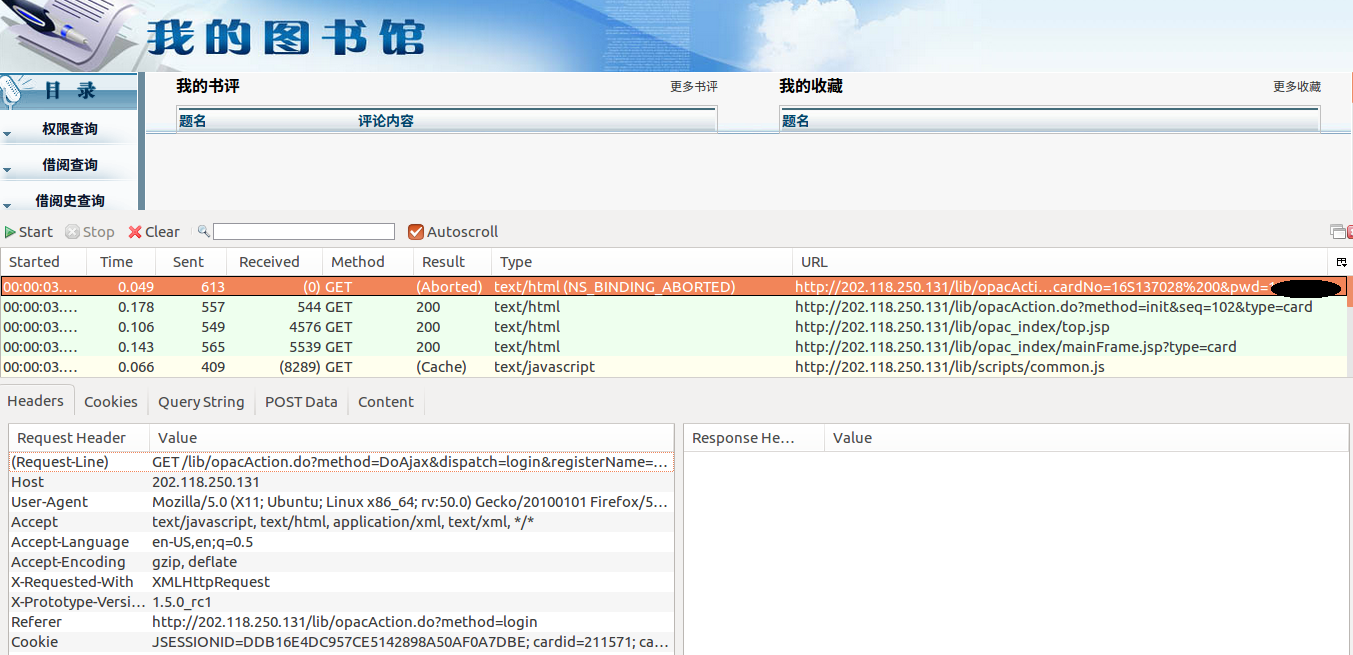
上图便是登陆之后的页面,以及整个登陆过程捕捉到的信息。选择第一条捕捉到的信息,点击下方数据头(Headers)选项卡,可以看见登录此页面需要发送的一些数据。有一些网站,对于访问它们的请求需要检查数据头(Headers),只有数据头信息符合要求才允许访问。在登录图书馆系统时,可以先尝试不发数据头,如果能顺利访问则说明没有Headers检查这一环节。数据发送的方法为GET,即只需要将要发送的数据信息加在登陆请求的后面。在Headers选项卡的Request-Line属性中,问号前面的即为登陆请求"GET /lib/opacAction.do",加上IP地址之后真实的请求URL为"http://202.118.250.131/lib/opacAction.do",问号后面的即为登陆需要的数据,包括账号、密码等信息。
接下来点开QueryString选项卡,查看由GET方法传送的数据:
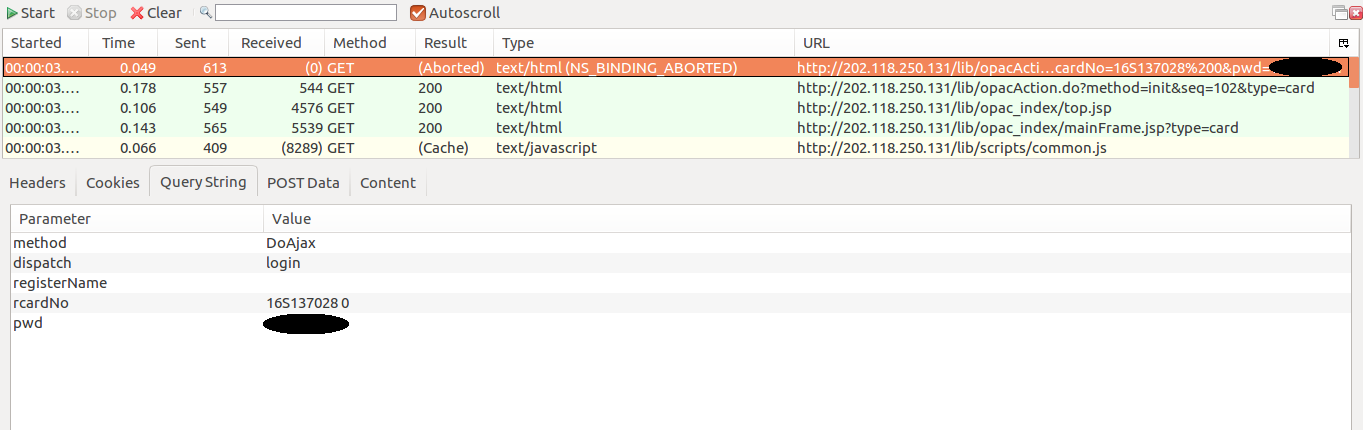
需要传送的数据包括5项,以字典类型将其储存,经过urlencode()方法编码之后直接加在登陆URL之后即可,所以最后向服务器发送的请求(request)为:
 import urllib

 loginURL = 'http://202.118.250.131/lib/opacAction.do'

 queryString = urllib.urlencode({

             'method':'DoAjax',

             'dispatch':'login',

             'registerName':'',

             'rcardNo':'16S137028 0',

             'pwd':'******'

         })

 requestURL = self.loginURL + '?' + self.queryString
得到请求URL之后就可以模拟登陆图书馆系统了,在模拟登陆的过程中需要用到前面讲到的cookie,否则无法进行后续的访问。在编代码过程中,定义一个library类,使访问过程变成一个面向对象的过程,可以根据需要实例化多个library对象,分别对多个实例进行操作。首先分析,该library类应该有一个初始化方法(__init__)以及一个获取页面的方法(getPage),在打开网页是,应使用上文提到opener实例,自动捕获并储存cookie:
 import urllib

 import urllib2

 import cookielib

 import re

 class library:

     def __init__(self):

         self.loginURL='http://202.118.250.131/lib/opacAction.do'

         self.queryString = urllib.urlencode({

             'method':'DoAjax',

             'dispatch':'login',

             'registerName':'',

             'rcardNo':'16S137028 0',

             'pwd':'******'

         })

         self.requestURL = self.loginURL + '?' + self.queryString

         self.cookies=cookielib.CookieJar()

         self.handler=urllib2.HTTPCookieProcessor(self.cookies)

         self.opener=urllib2.build_opener(self.handler)

     def getPage(self):

         request1 = urllib2.Request(self.requestURL)

         request2 = urllib2.Request(' http://202.118.250.131/lib/opacAction.do?method=init&seq=301 ')

         result = self.opener.open(request1)

         result = self.opener.open(request2)

         return result.read()

 lib = library()

 print lib.getPage()
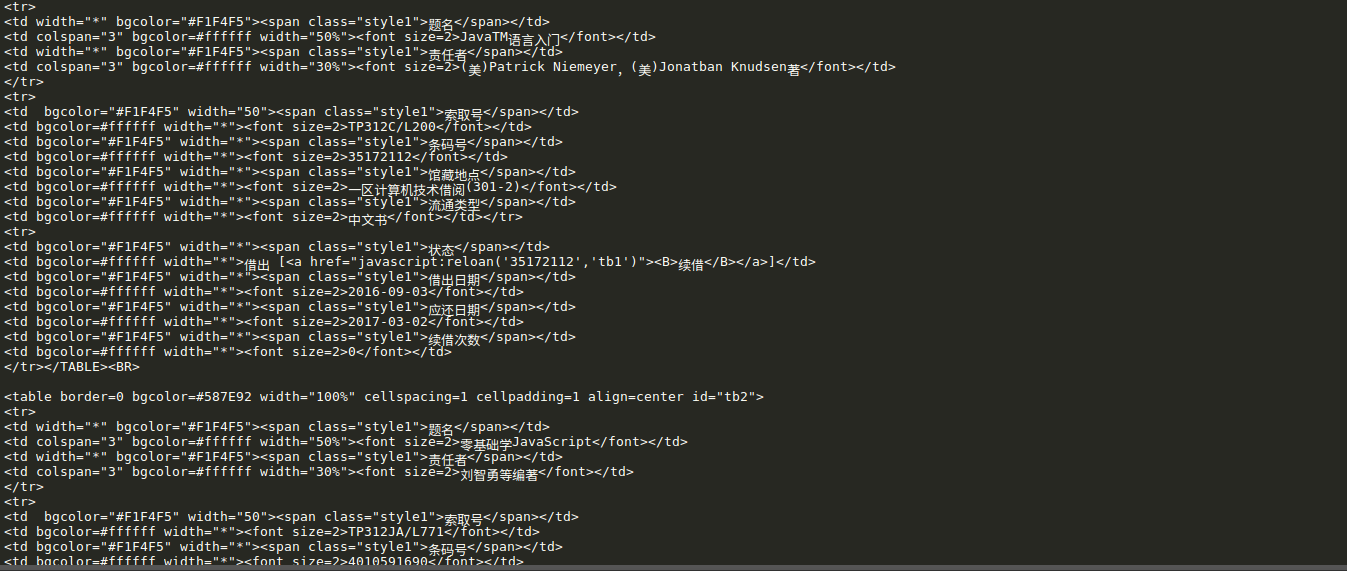
上述代码中,先是进行登录 result = self.opener.open(request1) ,登录没有异常,说明登录过程不用检查数据头;然后再用此 self.opener 打开借阅查询页面
http://202.118.250.131/lib/opacAction.do?method=init&seq=301 ,所以这段代码将打印借阅查询界面的HTML代码,下图是部分打印结果:
获取借阅信息:
抓取了页面信息之后,接下来就是根据自己的需要匹配、储存信息了。在匹配页面信息时,这里用的是正则表达式的方式进行匹配,正则表达式的支持由Python的Re模块提供支持,关于如何使用正则表达式,可以参考这里:Python正则表达式指南
使用Re模块进行匹配时,往往先将正则表达式字符串编译(compile)成一个Pattern实例,再利用Re模块中的re.findall(pattern , string),将字符串string中和正则表达式匹配的数据以列表的形式返回。如果在pattern中有超过一个组(group),则返回的结果将是一个元组列表,如此正则表达式: <table.*?id="tb.*?width="50%"><font size=2>(.*?)</font>.*?<tr>.*?<tr>.*?<font size=2>(.*?)</font>.*?<font size=2>(.*?)</font>.*?</TABLE> ,式中,每一个 (.*?) 代表一个组,即此式中有3个组,则匹配时,返回一个元组列表,其中每一个元组又有3个数据。
在library类中,定义一个获取信息的方法(getInformation),以通过正则表达式匹配的方式获取所需数据:
 def getInformation(self):

         page = self.getPage()

         pattern = re.compile('<table.*?id="tb.*?width="50%"><font size=2>(.*?)</font>.*?<tr>.*?<tr>.*?'+

                         '<font size=2>(.*?)</font>.*?<font size=2>(.*?)</font>.*?</TABLE>',re.S)

         items = re.findall(pattern,page)
获取所需数据之后,接下来就是将数据写入文本文件(txt)储存,以读写模式(W+)打开一个文件(library.txt),然后通过write()方法将数据一条一条的写入文件。不过,在信息写入之前,需要对抓取到的信息做一些小处理,刚才说过了,findall()方法返回的是一个元组列表,即[[a,b,c],[d,e,f],[g,h,i]]的形式,write()方法是不能对元组进行操作的,所以需要手动将元组翻译成一条条字符串,再保存到一个列表里,通过遍历将每条字符串写入文件:
 def getInformation(self):

         page = self.getPage()

         pattern = re.compile('<table.*?id="tb.*?width="50%"><font size=2>(.*?)</font>.*?<tr>.*?<tr>.*?'+

                         '<font size=2>(.*?)</font>.*?<font size=2>(.*?)</font>.*?</TABLE>',re.S)

         items = re.findall(pattern,page)

         contents = []

         for item in items:

             content = item[0]+'    from   '+item[1]+'   to   '+item[2]+'\n'

             contents.append(content)

         self.writeData(contents)

 def writeData(self,contents):

         file = open('libraryBooks.txt','w+')

         for content in contents:

             file.write(content)

         file.close()
至此,整个爬虫就算完成了,下面贴上完整代码:
大功告成:
 __author__='Victor'

 #_*_ coding:'utf-8' _*_

 import urllib

 import urllib2

 import cookielib

 import re

 class library:

     def __init__(self):

         self.loginURL='http://202.118.250.131/lib/opacAction.do'

         self.queryString = urllib.urlencode({

             'method':'DoAjax',

             'dispatch':'login',

             'registerName':'',

             'rcardNo':'16S137028 0',

             'pwd':'******'

         })

         self.requestURL = self.loginURL + '?' + self.queryString

         self.cookies=cookielib.CookieJar()

         self.handler=urllib2.HTTPCookieProcessor(self.cookies)

         self.opener=urllib2.build_opener(self.handler)

     def getPage(self):

         request1 = urllib2.Request(self.requestURL)

         request2 = urllib2.Request('http://202.118.250.131/lib/opacAction.do?method=init&seq=301')

         result = self.opener.open(request1)

         result = self.opener.open(request2)

         return result.read()

     def getInformation(self):

         page = self.getPage()

         pattern = re.compile('<table.*?id="tb.*?width="50%"><font size=2>(.*?)</font>.*?<tr>.*?<tr>.*?'+

                         '<font size=2>(.*?)</font>.*?<font size=2>(.*?)</font>.*?</TABLE>',re.S)

         items = re.findall(pattern,page)

         contents = []

         for item in items:

             content = item[0]+'    from   '+item[1]+'   to   '+item[2]+'\n'

             contents.append(content)

         self.writeData(contents)

     def writeData(self,contents):

         file = open('libraryBooks.txt','w+')

         for content in contents:

             file.write(content)

         file.close()

 lib = library()

 lib.getInformation()
下面就是抓到的借阅信息,不得不说效果不怎么样,不过还是凑合着看把:

原创作品,引用请表明出处:Python爬虫实战---抓取图书馆借阅信息
Python爬虫实战---抓取图书馆借阅信息的更多相关文章
- Pyhton爬虫实战 - 抓取BOSS直聘职位描述 和 数据清洗
Pyhton爬虫实战 - 抓取BOSS直聘职位描述 和 数据清洗 零.致谢 感谢BOSS直聘相对权威的招聘信息,使本人有了这次比较有意思的研究之旅. 由于爬虫持续爬取 www.zhipin.com 网 ...
- python爬虫实战---爬取大众点评评论
python爬虫实战—爬取大众点评评论(加密字体) 1.首先打开一个店铺找到评论 很多人学习python,不知道从何学起.很多人学习python,掌握了基本语法过后,不知道在哪里寻找案例上手.很多已经 ...
- Python爬虫实现抓取腾讯视频所有电影【实战必学】
2019-06-27 23:51:51 阅读数 407 收藏 更多 分类专栏: python爬虫 前言本文的文字及图片来源于网络,仅供学习.交流使用,不具有任何商业用途,版权归原作者所有,如有问 ...
- 【转】Python爬虫:抓取新浪新闻数据
案例一 抓取对象: 新浪国内新闻(http://news.sina.com.cn/china/),该列表中的标题名称.时间.链接. 完整代码: from bs4 import BeautifulSou ...
- Python爬虫:抓取新浪新闻数据
案例一 抓取对象: 新浪国内新闻(http://news.sina.com.cn/china/),该列表中的标题名称.时间.链接. 完整代码: from bs4 import BeautifulSou ...
- Java广度优先爬虫示例(抓取复旦新闻信息)
一.使用的技术 这个爬虫是近半个月前学习爬虫技术的一个小例子,比较简单,怕时间久了会忘,这里简单总结一下.主要用到的外部Jar包有HttpClient4.3.4,HtmlParser2.1,使用的开发 ...
- 教您使用java爬虫gecco抓取JD全部商品信息
gecco爬虫 如果对gecco还没有了解可以参看一下gecco的github首页.gecco爬虫十分的简单易用,JD全部商品信息的抓取9个类就能搞定. JD网站的分析 要抓取JD网站的全部商品信息, ...
- Python爬虫,抓取淘宝商品评论内容!
作为一个资深吃货,网购各种零食是很频繁的,但是能否在浩瀚的商品库中找到合适的东西,就只能参考评论了!今天给大家分享用python做个抓取淘宝商品评论的小爬虫! 思路 我们就拿"德州扒鸡&qu ...
- python爬虫数据抓取方法汇总
概要:利用python进行web数据抓取方法和实现. 1.python进行网页数据抓取有两种方式:一种是直接依据url链接来拼接使用get方法得到内容,一种是构建post请求改变对应参数来获得web返 ...
随机推荐
- IDEA里运行程序时出现Failed to execute goal org.scala-tools:maven-scala-plugin:2.15.2:compile(default) on Project DataFusion:wrap:org.apache.commons...错误的解决办法(图文详解)
不多说,直接上干货! 问题详情 比如我们习惯在IDEA里打包用mvn clean package 在Scala IDEA for eclipse里出现mvn clean compile assembl ...
- Mac系统的下载(图文详解)
不多说,直接上干货! 经常使用苹果电脑的网友们,有时候不免会遇到电脑系统崩溃的情况,在通过各种系统补救都无法修复苹果系统时,动手能力稍强的网友肯定会想到要重装系统,这时就需要去下载苹果系统,那么, ...
- android 解决studio生成aar包并在其他工程引用aar包的坑,不需要任何gradle配置
1.首先我们创建一个module 2.编写我们的一个类 3.编译我们的module,生成release版本的aar,注意千万不要是debug版本的, 点击最右边的gradle面板,选择我们的modul ...
- 用java做操作系统内核:软盘读写
在前两节,我们将一段代码通过软盘加载到了系统内存中,并指示cpu执行加入到内存的代码,事实上,操作系统内核加载也是这么做的.只不过我们加载的代码,最大只能512 byte, 一个操作系统内核,少说也要 ...
- JavaScript引用类型和值类型
thead>tr>th,.table>tbody>tr>th,.table>tfoot>tr>th,.table>thead>tr>t ...
- ASPxComboBox 自带输入法确定之后再搜索解决方法
<dx:ASPxComboBox ID="comChargeSubject_FixedFee" ClientInstanceName="comChargeSubje ...
- javascript Function类型
Function(函数)类型实际上是对象,每个函数都是Function类型的实例,而且都与其他引用类型一样具有属性和方法,由于函数是对象,因此函数名实际上也是一个指向函数对象的指针 声明方式 func ...
- UNIX 高手的另外 10 个习惯
让我们面对现实吧:坏习惯很难改变.但是您已经熟悉的习惯可能更难克服.有时,重新审视某些事情可能让您遇到“啊哈,我没想到它能做到这一点!”的时刻.在 Michael Stutz 的优秀文章“UNIX 高 ...
- ASP.NET Core 2 学习笔记(十一)Cookies & Session
基本上HTTP是没有记录状态的协定,但可以通过Cookies将Request来源区分出来,并将部分数据暂存于Cookies及Session,是写网站常用的用户数据暂存方式.本篇将介绍如何在ASP.NE ...
- 连接数据库 JDBC、DBCP、JNDI
一.JDBC package com.direct.util; import java.sql.Connection; import java.sql.DriverManager; import ja ...