
内部排序算法(交换排序,插入排序)注意点(C语言实现)
对于算法思想的理解可以参考下面的这个帖子,十大经典排序算法(动图演示) - 一像素 - 博客园,因为算法的逻辑和数学很像,相应的基础资料一般也能在网上找到,所以,本帖子这谈论一些重要的注意点,其他人讲到的我就不提了,在实现的过程中可能有些代码不是很理解,其他的就相对比较容易多了。
整体按照这个顺序来,也比较好记忆一点:
一、交换排序
1、冒泡排序,基本过程参考前面的帖子,实现代码:
void BubbleSort(int a[], int n)        // 本算法将a[]中的元素从小到到大进行排序

{

     for(int i = 0; i < n - 1; i++){

        flag = false;                  // 表示本趟冒泡是否发生交换的标志

        for(j = n - 1; j > i; j--){    // 一趟冒泡过程

            swap(a[j - 1], a[j]);      // 为交换函数,将a[j] 与 a[j - 1] 进行交换

            flag = true;

        }

    }

    if (flag == false)                 // 本趟遍历后没有发生交换,说明表已经有序

        return;

}
注意:
1)通过设置flag可以直接判断表是否有序,如果有序直接退出,是一个小技巧;
2)排序时间复杂度与表的初始顺序有关,表有序时,比较次数为 n - 1,此为最好的时间复杂度O(n),最差为O(n^2);
3)每趟排序将一个元素放在最终的位置上;
2、快速排序
基于分治法思想,这个与动态图不太一样,针对考研的同学,希望还是以严蔚敏的版本为准:
int partition(int a[], int low, int high){

    int pivot = a[low];  // 将当前表中第一个元素设为枢轴值

    while(low < high){  // 下标控制条件

        while(low < high && a[high] >= pivot)

            --high;

        a[low] = a[high];

        while(low < high && pivot >= a[low])

            ++low;

        a[high] = a[low];

    }

    a[low] = pivot;

    return low;  // 返回数组下标,

}
如图,下面的列子:
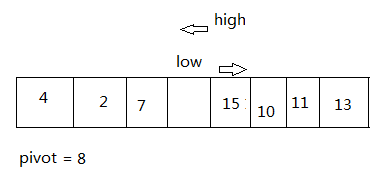
一开始的表 a[ ]
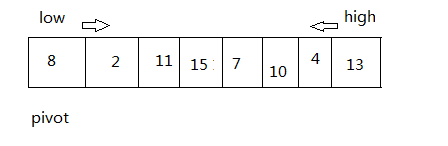
while(low < high && a[high] >= pivot) // 如果a[high]> pivot, high向前移动,直到a[high] < pivot;

            --high;

a[low] = a[high];  // 交换
此时的状态:
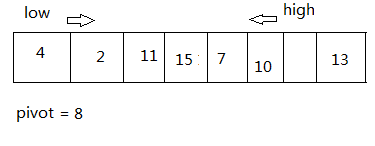
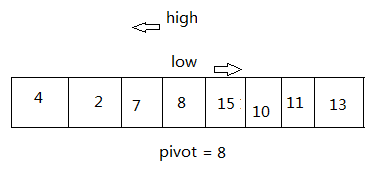
        while(low < high && pivot >= a[low])  // 如果a[low] < pivot, low向后移动,直到a[low] > pivot;

            ++low;

        a[high] = a[low];  // 交换
此时的状态:
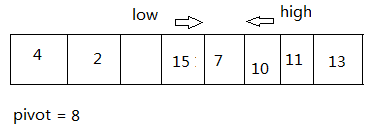
while( low < high) { ... } 的第一遍循环结束,开始第二次的循环:
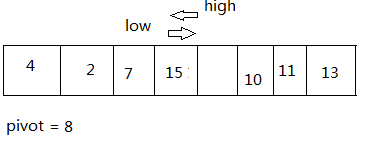
这个小例子比较简单,两遍就结束了,接下来判断条件不满足,退出:
while(low < high){  // 下标控制条件

    ...

    }
    a[low] = pivot;

    return low;  // 返回数组下标,
结果图:
这是各个分支的过程,其中主程序的代码可以采用递归式,也可以采用非递归的,
void QuickSort (int a[], int low, int high){

    if (low < high){

        int pivot = partition(A, low, high);

        QuickSort(A, low, pivot - 1);

        QuickSort(A, pivot + 1, high);

    }  /if

}
point:
1)快排是所有内排序算法平均性能最优的,平均时间复杂度O(nlog₂n),最差为O(n²),平均空间复杂度O(log₂n),最差为O(n);
2)不稳定;
3)其过程中,不产生有序子序列,但是每趟将一个元素放在最终的位置上,就是基准元素;
三、插入排序
1、直接插入排序
这个比较好理解,直接上代码:
void InsertSort(int a[], int n){

    int i, j;

    for(int i = 2; i <= n; i++){  // 依次将下标2 —— n 插入到已排好的序列

        if (a[i] < a[i -1]){  // 前面下标从2开始就是此处 i - 1 的原因

            a[0] = a[i];  //

            for(j = i -1; a[0] < a[j]; --j){  // 从后面往前查找待插入的元素

                a[j + 1] = a[j];  // 向后挪位置

            }

            a[j + 1] = a[0];

        }

    }

}
point:
1)移动和比较次数取决于待排序表的初始状态,最好的情况是表已经有序,时间复杂度为O(n), 平均时间复杂度为O(n²);
2)稳定;
3)注意有个哨兵机制,之后的折半插入与希尔排序也是根据此算法转换而来;
2、折半插入排序
基于直接插入排序作出的改动,如图:
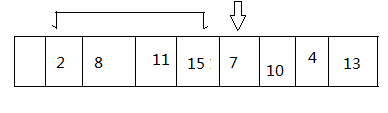
当下边指向7时,前面已经有序,因此利用二分法找到2的后面,然后再直接放入,
point :
1)仅仅是减少了比较的次数,约为O(nlog₂n),该比较次数与待排序表的初始状态无关,仅取决于表中的元素个数n;移动次数没有改变,依赖于待排序表中的初始状态;
2)时间复杂度仍为O(n²)
3)稳定
3、希尔排序
参考的帖子有点小瑕疵,这里面着重提一下:
先上代码:
void ShellSort(int a[], int n){

    for(dk = n/2; dk >= 1; dk = df/2){  // 初始增量序列是n/2,后面依次是

        for(i = dk+1; i<=n; ++i){

            if (a[i] < a[i - dk]){

                a[0] = a[i];  // 先暂存在a[0]中

                for(j = i-dk; j>0 && a[0]<a[j]; j -= dk){  //j<0 的时候说明到头了

                    a[j + dk] = a[j];

                }

                a[j + dk] = a[0];  // 记录后移,查找插入的位置

            }

        }

    }

}
如图,初始数组:
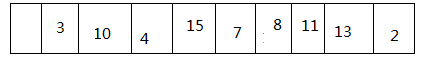
第一趟,dk = n / 2 时,注意,带*号的还没进行比较:
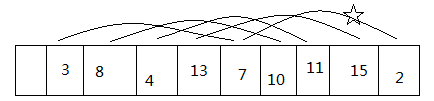
此时,重点来了,
        for(j = i-dk; j>0 && a[0]<a[j]; j -= dk){  //j<0 的时候说明到头了

                    a[j + dk] = a[j];
        }
这段代码的作用就是下图的效果,还要与前面同样的增量序列大小进行比较
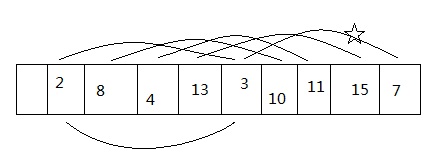
至此,第一轮循环结束,第二轮增量序列为2 = 4 / 2,之后的过程也是如此,就不重复了。
point:
1)时间复杂度依赖于增量序列的函数,n 取某个值时,最好为O( )
2)不稳定
内部排序算法(交换排序,插入排序)注意点(C语言实现)的更多相关文章
- 常见排序算法总结:插入排序,希尔排序,冒泡排序,快速排序,简单选择排序以及java实现
今天来总结一下常用的内部排序算法.内部排序算法们需要掌握的知识点大概有:算法的原理,算法的编码实现,算法的时空复杂度的计算和记忆,何时出现最差时间复杂度,以及是否稳定,何时不稳定. 首先来总结下常用内 ...
- Java实现各种内部排序算法
数据结构中常见的内部排序算法: 插入排序:直接插入排序.折半插入排序.希尔排序 交换排序:冒泡排序.快速排序 选择排序:简单选择排序.堆排序 归并排序.基数排序.计数排序 直接插入排序: 思想:每次将 ...
- 【转载】[经验] 嵌入式stm32实用的排序算法 - 交换排序
Ⅰ.写在前面 前面写了关于ADC采集电压的文章,大家除了求平均的方式来处理采样值,还有没有使用到其他的方式来处理采集值呢? 在某些情况下就需要对一组数据进行排序,并提取头特定的数据出来使用. 排序的应 ...
- 常见内部排序算法对比分析及C++ 实现代码
内部排序是指在排序期间数据元素全部存放在内存的排序.外部排序是指在排序期间全部元素的个数过多,不能同时存放在内存,必须根据排序过程的要求,不断在内存和外存之间移动的排序.本次主要介绍常见的内部排序算法 ...
- 七内部排序算法汇总(插入排序、Shell排序、冒泡排序、请选择类别、、高速分拣合并排序、堆排序)
写在前面: 排序是计算机程序设计中的一种重要操作,它的功能是将一个数据元素的随意序列,又一次排列成一个按keyword有序的序列.因此排序掌握各种排序算法很重要. 对以下介绍的各个排序,我们假定全部排 ...
- 用 Java 实现常见的 8 种内部排序算法
一.插入类排序 插入类排序就是在一个有序的序列中,插入一个新的关键字.从而达到新的有序序列.插入排序一般有直接插入排序.折半插入排序和希尔排序. 1. 插入排序 1.1 直接插入排序 /** * 直接 ...
- 算法相关——Java排序算法之插入排序(四)
0. 前言 本系列文章将介绍一些常用的排序算法.排序是一个非常常见的应用场景,也是开发岗位面试必问的一道面试题,有人说,如果一个企业招聘开发人员的题目中没有排序算法题,那说明这个企业不是一个" ...
- 算法分析中最常用的几种排序算法(插入排序、希尔排序、冒泡排序、选择排序、快速排序,归并排序)C 语言版
每次开始动手写算法,都是先把插入排序,冒泡排序写一遍,十次有九次是重复的,所以这次下定决心,将所有常规的排序算法写了一遍,以便日后熟悉. 以下代码总用一个main函数和一个自定义的CommonFunc ...
- java 合并排序算法、冒泡排序算法、选择排序算法、插入排序算法、快速排序算法的描述
算法是在有限步骤内求解某一问题所使用的一组定义明确的规则.通俗点说,就是计算机解题的过程.在这个过程中,无论是形成解题思路还是编写程序,都是在实施某种算法.前者是推理实现的算法,后者是操作实现的算法. ...
随机推荐
- Jsoup-基于Java实现网络爬虫-爬取笔趣阁小说
注意!仅供学习交流使用,请勿用在歪门邪道的地方!技术只是工具!关键在于用途! 今天接触了一款有意思的框架,作用是网络爬虫,他可以像操作JS一样对网页内容进行提取 初体验Jsoup <!-- Ma ...
- MYSQL中TIMESTAMP类型的默认值理解
MYSQL中TIMESTAMP类型可以设定默认值,就像其他类型一样. 1.自动UPDATE 和INSERT 到当前的时间:表:----------- Table Create Table ...
- chrom里面的performance 颜色
在network里面,在network里面,在network里面(重要事件说三遍) : 1. HTML 文件为蓝色. 2. 脚本为黄色. 3. 样式表为紫色. 4. 媒体文件为绿色. 5. 其他资源为 ...
- Laravel打印sql日志
直接打印 use Log; use DB; DB::connection()->enableQueryLog(); Log::info(DB::getQueryLog()); //print_r ...
- Android NDK工程的编译和链接以及使用gdb进行调试
前提条件:已经安装了JDK 6.0.android SDK.NDK r9和eclipsele4.2开发环境. 推荐下载Android开发的综合套件adt-bundle-windows-x86,再下载A ...
- IDAPython类库---idaapi.py的源码
#ThisfilewasautomaticallygeneratedbySWIG(http://www.swig.org).#Version2.0.12##Donotmakechangestothis ...
- Sublime text3 的破解
下载sublimeText3的安装包并安装(已经安装的可以忽略) 在hosts文件中添加:127.0.0.1 license.sublimehq.com(hosts文件地址:C:\Windows\Sy ...
- @NotNull 、@NotBlank、@NotEmpty区别
@NotNull: 主要用在基本数据类型上(Integer.Double...) 不能为null,但可以为empty 举例: @NotNull(message = "标题不能为空" ...
- Nebula Graph 的 Ansible 实践
本文首发于 Nebula Graph 公众号 NebulaGraphCommunity,Follow & 看大厂图数据库技术实践 背景 在 Nebula-Graph 的日常测试中,我们会经常在 ...
- Python正则表达式的七个使用范例
本文由 伯乐在线 - 左手的灵魂 翻译.未经许可,禁止转载!英文出处:thegeekstuff.欢迎加入翻译组.http://blog.jobbole.com/74844/ 作为一个概念而言,正则表达 ...