
【论文笔记】Leveraging Post-click Feedback for Content Recommendations
Leveraging Post-click Feedback for Content Recommendations
Authors: Hongyi Wen, Longqi Yang, Deborah Estrin
Recsys'19 Cornell University
论文链接:https://dl.acm.org/doi/pdf/10.1145/3298689.3347037
本文链接:https://www.cnblogs.com/zihaojun/p/15708632.html
0. 总结
这篇文章证明了在推荐系统中,将用户点击之后没有看完的物品作为负样本的一部分参与训练是有效的。
1.研究目标
利用用户在点击之后的反馈数据,来解决点击数据中的噪声问题,提高推荐系统的性能。
- 例如,用户观看视频或听音乐的时长,可以反映用户看到物品之后是否真正喜欢。
2.问题背景
在构建推荐系统时,通常会选用隐式反馈数据作为训练数据,但隐式反馈数据的正样本不一定都是用户喜欢的物品。例如,用户点击了一个物品,这只能反映用户对这个物品的第一印象比较好,用户在浏览之后可能并不喜欢这个物品。
3.分析点击之后的反馈信息
数据集:
- Spotify:在线音乐数据集,包含上亿的听歌会话,每个会话包含最多二十首歌,记录了用户跳过还是听完了每首歌,跳过与否是根据挑战赛组委会设定的播放阈值。随机选择了九百万会话进行分析。
- ByteDance:用户与短视频(10秒)的交互记录,包含是否完播。选取了13 million的数据。
3.1 反馈信息的特点
点击之后的用户反馈在很多场景中都存在,这种反馈可能是显式的(评分),也可能是隐式的(观看时长)。在上述两个数据集中,音乐和短视频场景下,分别有51%和56%的交互是点击之后被跳过的。也就是说,超过半数的交互是点击之后用户并不满意的。
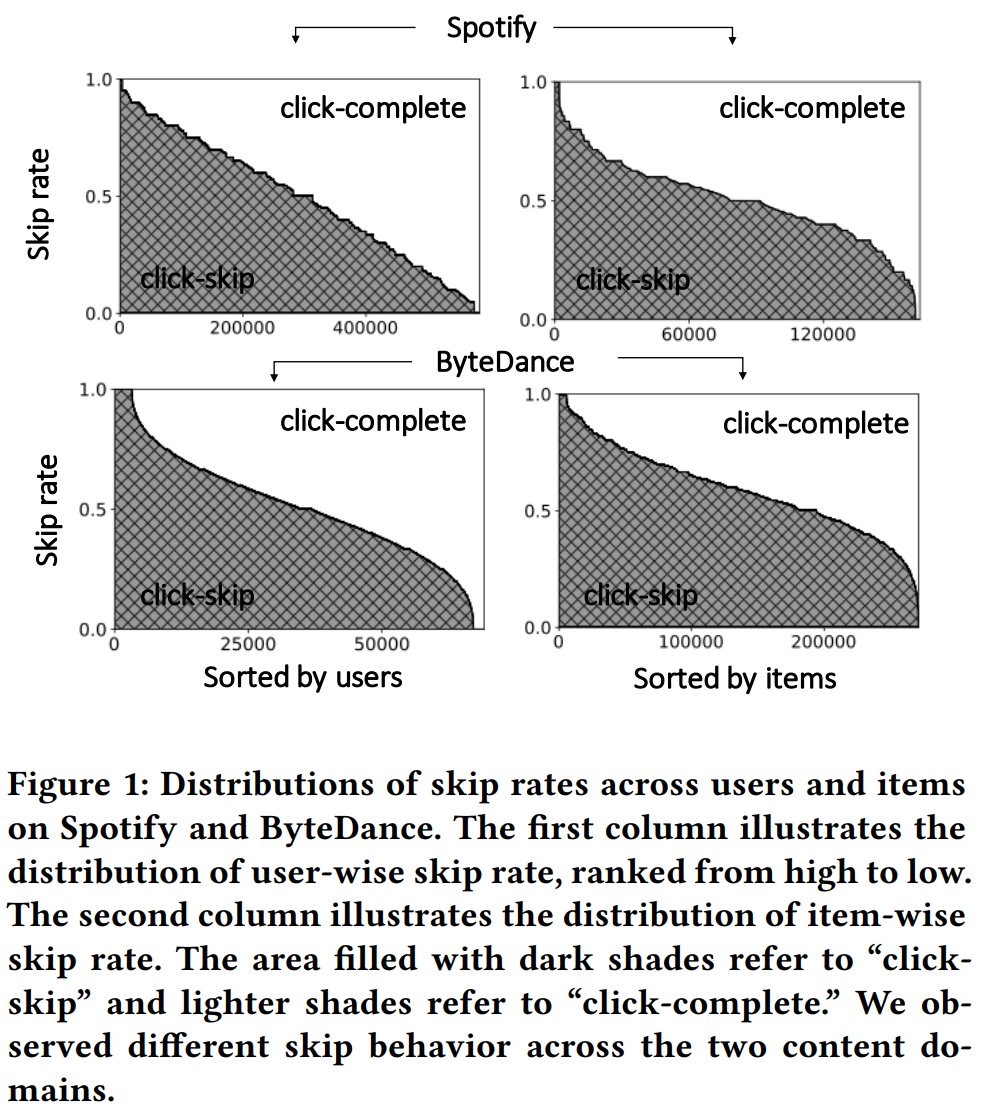
具体到每个物品和每个用户的完播比例,如Figure 1所示,两个数据集上面,左边一列(用户跳过比例)的分布不同,可能是因为音乐和视频的使用场景不同,音乐被跳过会更加随机。
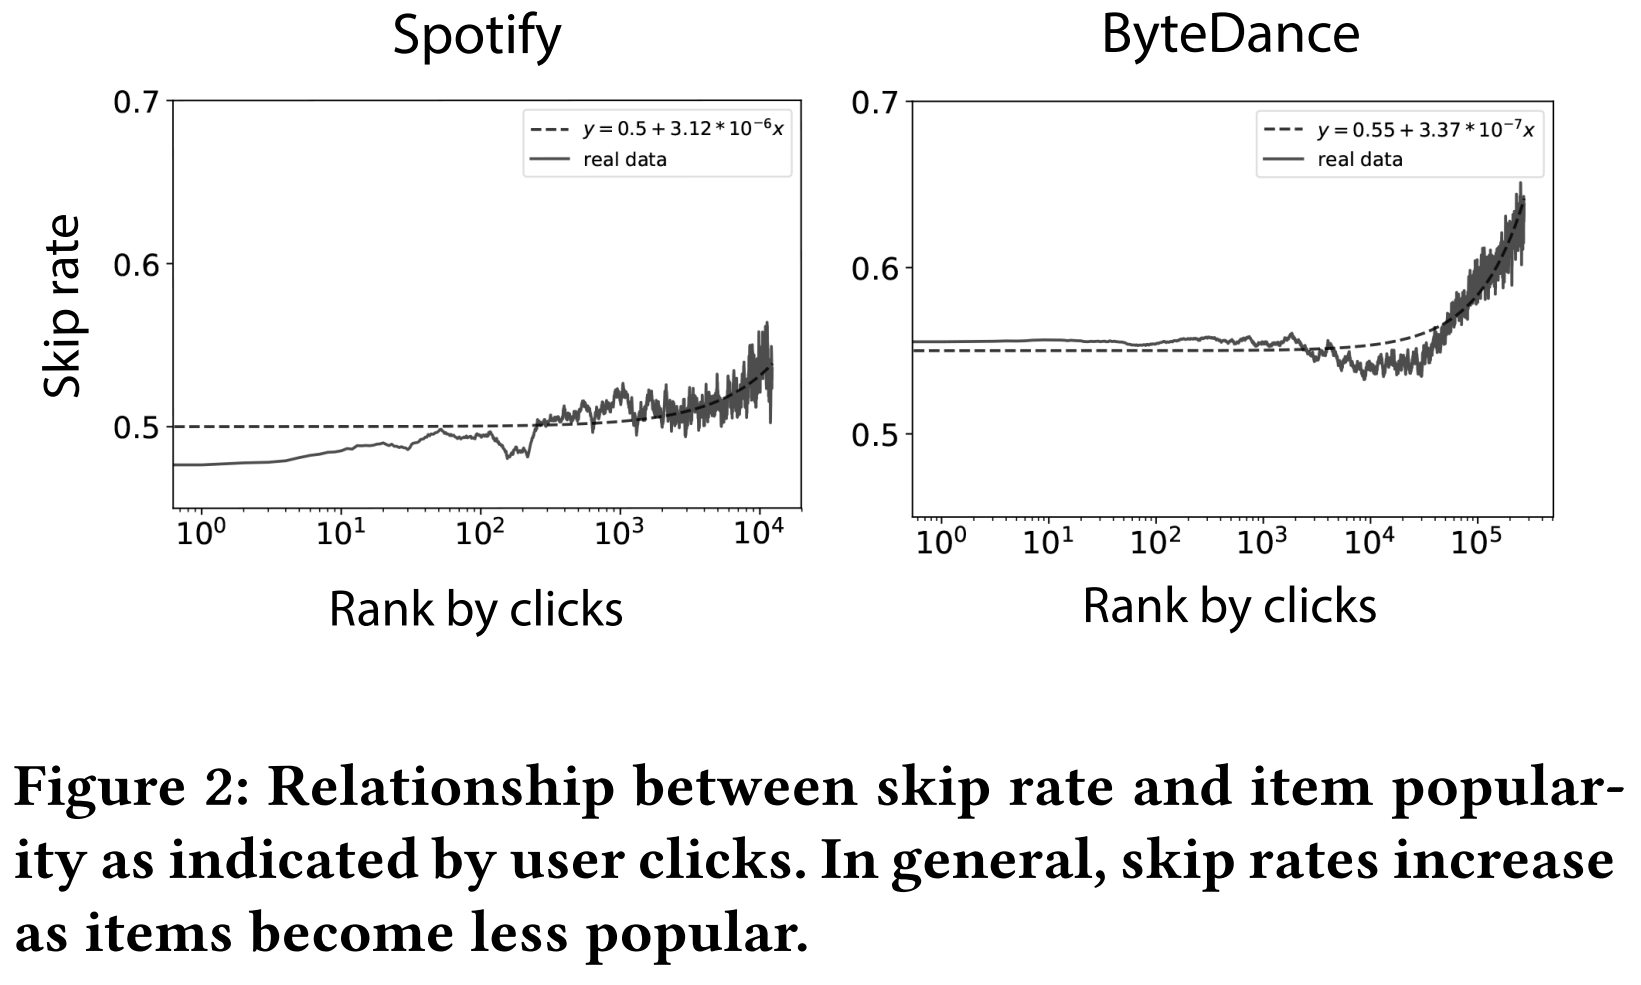
作者还观察到,越冷门的物品,被跳过的比例越高。这可能是物品质量导致的。
3.2 点击和反馈信息
用点击数据作为训练集,分别在常规测试集和兴趣测试集上进行性能测试,研究模型对点击行为和对完播行为的推荐精度差别。
- 常规测试集是指,将所有物品作为候选集,将测试阶段点击物品作为正样本。
- 兴趣测试集是指,将测试阶段的点击样本作为候选列表,将完播数据作为正样本(看能不能把完播排在跳过前面)。
最后得出结论,模型对点击行为的预测能力远高于对完播行为的预测能力。
这一段实验设计有问题,详见Weakness部分
\hline \text { Dataset } & \text { # of users } & \text { # of items } & \text { # of records } & \text { Density } & \text { Percentage of skips % } \\
\hline \text { Spotify } & 229,792 & 100,586 & 4,090,895 & 0.018 \% & 51.05 \% \\
\text { ByteDance } & 37,043 & 271,259 & 9,391,103 & 0.093 \% & 55.13 \% \\
\hline
\end{array}
\]
4.方法
方法是比较简单的,虽然写的很复杂。
总体思路就是把用户跳过的样本(skip)也当做负样本。
4.1 Pointwise Loss
\(O_P\)表示用户未跳过的交互,\(O_N\)表示用户跳过的交互,\(O_M\)表示用户未交互的物品。
\]
其实就是把跳过的物品当做负样本,并且加个权重。
4.2 Pairwise Loss
\(O_P\)中,i表示没跳过的物品,j表示跳过的物品。
\(O_N\)中,i表示没跳过的物品,j没交互过的物品。
\]
注意论文中把第二项的ij反了过来(增加一点复杂度),其实没有必要。
当\(\beta = 0\)时,模型只利用没有跳过的交互作为正样本,而没有利用跳过的样本,称为BL。
当\(\beta \not = 0\)时,模型称为-NR。
5.实验结果
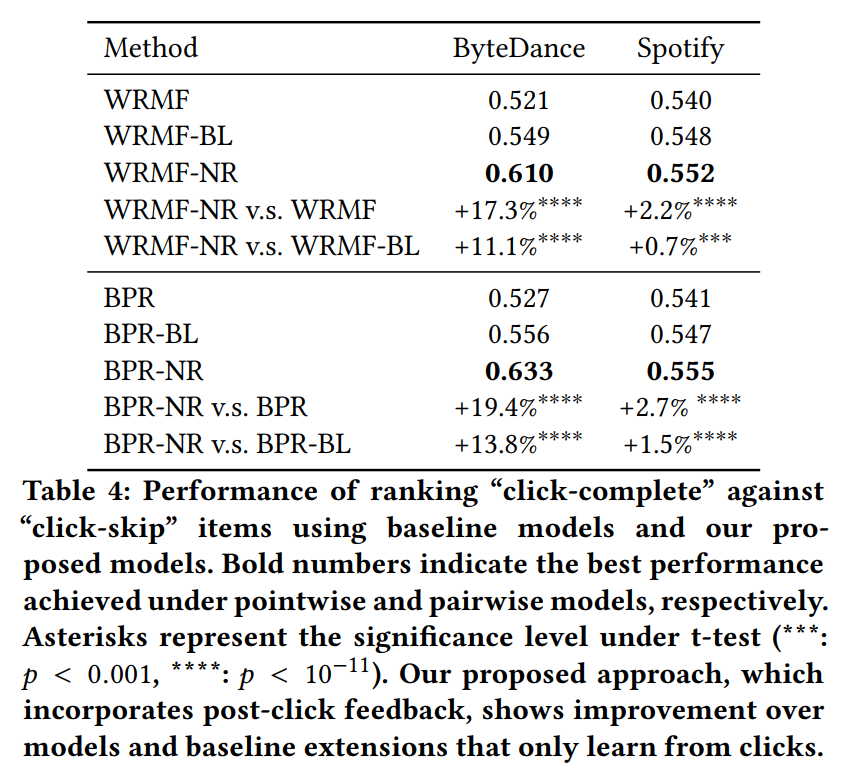
实验结果表明,将跳过的样本作为负样本(NR)是有效的,且直接将这些样本从正样本集中去除(BL)也是有效的
可以借鉴的地方
- 3.1的分析方法
- 数据集 Spotify[1]
Weakness
3.2的分析不合理
- 两种测试任务的难度是不同的,常规测试任务的负样本很简单,但是兴趣测试任务是很难的,因此直接比较两种设置下的AUC绝对值是不合理的。
- 比较合理的实验设置应该是保持测试方法一致,修改训练集数据,用(跳过+完播)和(完播)两种训练方式,看测试效果有什么不同。(看到后面才发现,这已经是论文主实验了)
有错词,例如5.2部分第三个单词purposed,应为proposed。
符号不一致,5.1部分使用的符号\(\lambda_p\)和\(\lambda_n\)在前文并没有提到。
[29]和[30]两篇引用是同一篇
进一步阅读
[15] Hongyu Lu, Min Zhang, and Shaoping Ma. 2018. Between Clicks and Satisfaction: Study on Multi-Phase User Preferences and Satisfaction for Online News Reading. In The 41st International ACM SIGIR Conference on Research & Development in Information Retrieval. ACM, 435–444.
[34] Qian Zhao, F Maxwell Harper, Gediminas Adomavicius, and Joseph A Konstan. 2018. Explicit or implicit feedback? engagement or satisfaction?: a feld experiment on machine-learning-based recommender systems. In Proceedings of the 33rd Annual ACM Symposium on Applied Computing. ACM, 1331–1340.
[5] Yifan Hu, Yehuda Koren, and Chris Volinsky. 2008. Collaborative fltering for implicit feedback datasets. In Eighth IEEE International Conference on Data Mining (ICDM’08). IEEE, 263–272.
[8] Youngho Kim, Ahmed Hassan, Ryen W White, and Imed Zitouni. 2014. Modeling dwell time to predict click-level satisfaction. In Proceedings of the 7th ACM international conference on Web search and data mining. ACM, 193–202.
[11] Mounia Lalmas, Janette Lehmann, Guy Shaked, Fabrizio Silvestri, and Gabriele Tolomei. 2015. Promoting positive post-click experience for in-stream yahoo gemini users. In Proceedings of the 21th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining. ACM, 1929–1938.
【论文笔记】Leveraging Post-click Feedback for Content Recommendations的更多相关文章
- 【论文笔记】 Denoising Implicit Feedback for Recommendation
Denoising Implicit Feedback for Recommendation Authors: 王文杰,冯福利,何向南,聂礼强,蔡达成 WSDM'21 新加坡国立大学,中国科学技术大学 ...
- 【论文笔记】用反事实推断方法缓解标题党内容对推荐系统的影响 Click can be Cheating: Counterfactual Recommendation for Mitigating Clickbait Issue
Click can be Cheating: Counterfactual Recommendation for Mitigating Clickbait Issue Authors: 王文杰,冯福利 ...
- 【论文笔记】SamWalker: Social Recommendation with Informative Sampling Strategy
SamWalker: Social Recommendation with Informative Sampling Strategy Authors: Jiawei Chen, Can Wang, ...
- Perceptual Losses for Real-Time Style Transfer and Super-Resolution and Super-Resolution 论文笔记
Perceptual Losses for Real-Time Style Transfer and Super-Resolution and Super-Resolution 论文笔记 ECCV 2 ...
- Deep Learning论文笔记之(四)CNN卷积神经网络推导和实现(转)
Deep Learning论文笔记之(四)CNN卷积神经网络推导和实现 zouxy09@qq.com http://blog.csdn.net/zouxy09 自己平时看了一些论文, ...
- 论文笔记之:Visual Tracking with Fully Convolutional Networks
论文笔记之:Visual Tracking with Fully Convolutional Networks ICCV 2015 CUHK 本文利用 FCN 来做跟踪问题,但开篇就提到并非将其看做 ...
- Deep Learning论文笔记之(八)Deep Learning最新综述
Deep Learning论文笔记之(八)Deep Learning最新综述 zouxy09@qq.com http://blog.csdn.net/zouxy09 自己平时看了一些论文,但老感觉看完 ...
- Twitter 新一代流处理利器——Heron 论文笔记之Heron架构
Twitter 新一代流处理利器--Heron 论文笔记之Heron架构 标签(空格分隔): Streaming-process realtime-process Heron Architecture ...
- Deep Learning论文笔记之(六)Multi-Stage多级架构分析
Deep Learning论文笔记之(六)Multi-Stage多级架构分析 zouxy09@qq.com http://blog.csdn.net/zouxy09 自己平时看了一些 ...
随机推荐
- C#中使用protobuf-net进行序列化
前一篇文章我们看到使用Google.Protobuf有诸多不便(参考<如何在C#中使用Google.Protobuf工具>),这次我们来看看另一个工具的使用体验. 相关资料.链接: git ...
- Python实战:截图识别文字,过万使用量版本!(附源码!!)
前人栽树后人乘凉,以不造轮子为由 使用百度的图片识字功能,实现了一个上万次使用量的脚本. 系统:win10 Python版本:python3.8.6 pycharm版本:pycharm 2021.1. ...
- 聊聊并发(六)——CAS算法
一.原子类 1.CAS算法 强烈建议读者看这篇之前,先看这篇 初识JUC 的前两节,对原子性,原子变量,内存可见性有一个初步认识. CAS(Compare and Swap)是一种硬件对并发的支持,针 ...
- [NOIP2017 提高组] 宝藏
考虑到这种对于某种操作顺序有一个权值. 且这个权值有一个\(O(n)\)或者更好的复杂度求出. 求最值. 那可以用模拟退火. #include<iostream> #include< ...
- 洛谷 P7520 - [省选联考 2021 A 卷] 支配(支配树)
洛谷题面传送门 真·支配树不 sb 的题. 首先题面已经疯狂暗示咱们建出支配树对吧,那咱就老老实实建呗.由于这题数据范围允许 \(n^2\) 算法通过,因此可以考虑 \(\mathcal O(n^2 ...
- Codeforces 840C - On the Bench(dp/容斥原理)
Codeforces 题目传送门 & 洛谷题目传送门 这是一道 *2500 的 D1C,可个人认为难度堪比某些 *2700 *2800. 不过嘛,*2500 终究还是 *2500,还是被我自己 ...
- 洛谷 P4887 -【模板】莫队二次离线(第十四分块(前体))(莫队二次离线)
题面传送门 莫队二次离线 mol ban tea,大概是这道题让我第一次听说有这东西? 首先看到这类数数对的问题可以考虑莫队,记 \(S\) 为二进制下有 \(k\) 个 \(1\) 的数集,我们实时 ...
- 实现类似Tab选项卡功能关键代码
//放置显示不同Activity的控件 private LinearLayout mainContentLayout; private LocalActivityManager localActivi ...
- python项目——新闻管理系统
DAO(Data Access Object) 数据访问对象是一个面向对象的数据库接口 控制台的输入输出都是再app.py里面完成的 mysql_db.py import mysql.connect ...
- flask分页功能:基于flask-sqlalchemy和jinja2
先看源码: @app.route('/movie', methods=['GET', 'POST']) @app.route('/home', methods=['GET', 'POST']) @ap ...