
Hadoop入门 集群崩溃的处理方法
集群崩溃的处理方法
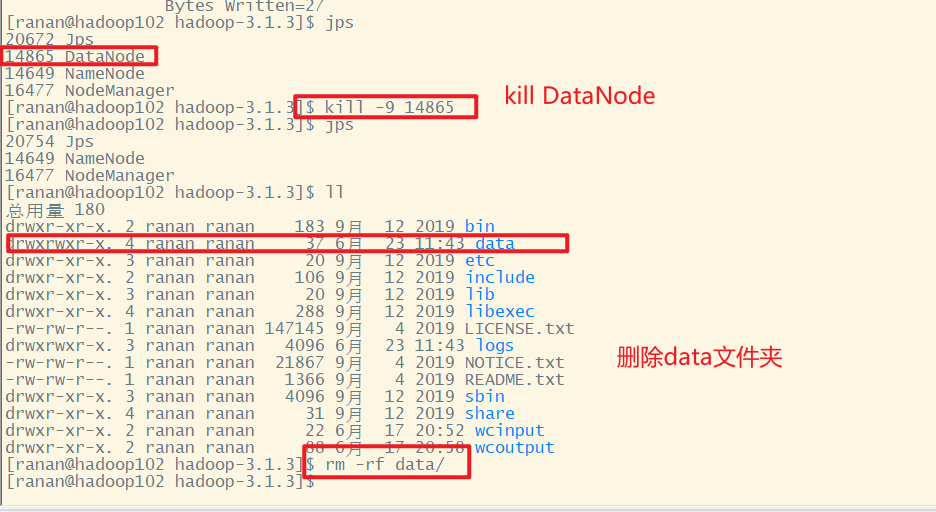
搞崩集群
hadoop102
hadoop103
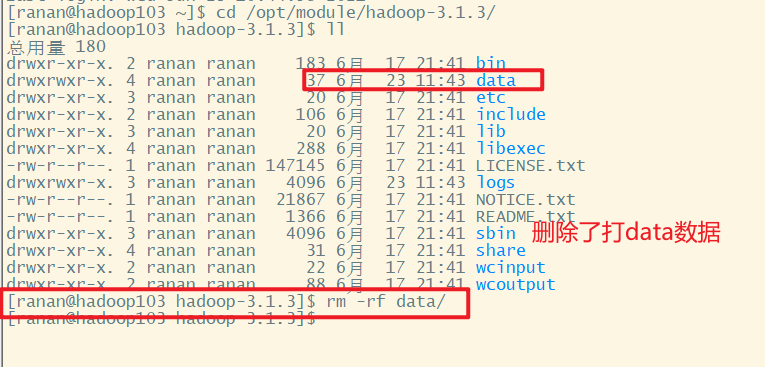
hadoop104

此时HDFS Web端的文件是不可以下载的,因为三个副本都删除了。
错误示范
最先想到的是格式化集群
[ranan@hadoop102 hadoop-3.1.3]$ hdfs namenode -format

提示需要先停掉集群,正常情况下先把yarn停掉
[ranan@hadoop103 hadoop-3.1.3]$ sbin/stop-yarn.sh

[ranan@hadoop102 hadoop-3.1.3]$ sbin/stop-dfs.sh

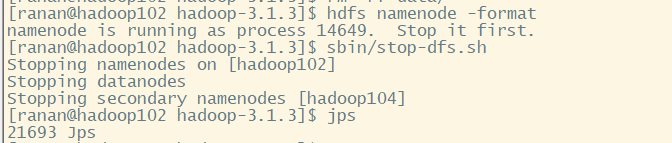
启动集群,发现集群正常启动,但是NameNode没了
[ranan@hadoop102 hadoop-3.1.3]$ sbin/start-dfs.sh
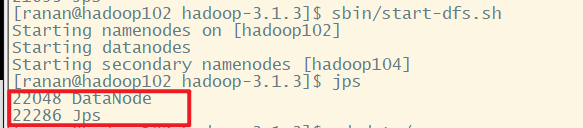
查看目录,发现删除了DataNode中的name
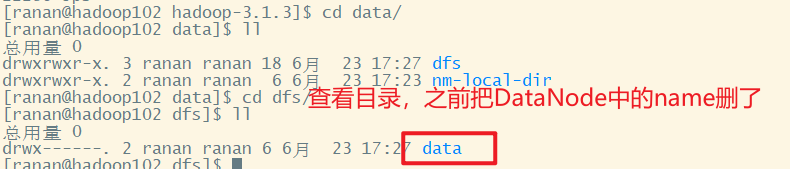
那就格式NameNode,之前并没有成功格式化。
[ranan@hadoop102 hadoop-3.1.3]$ hdfs namenode -format
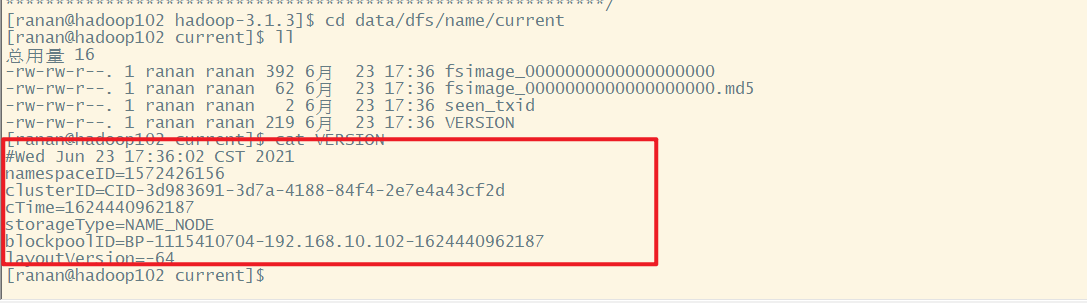
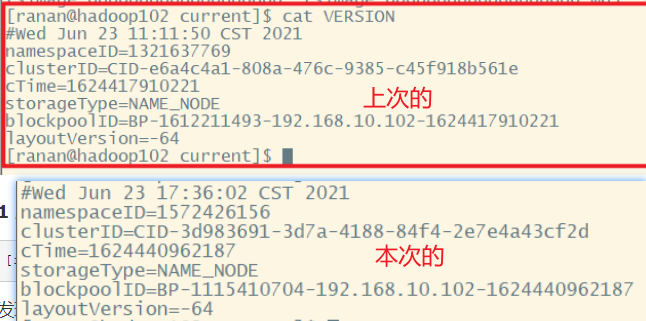
格式化之后,发现name文件夹有了,进去查看版本号。发现两次的版本号不一样。
[ranan@hadoop102 hadoop-3.1.3]$ cd data/dfs/name/current

[ranan@hadoop102 current]$ cat VERSION
此时进入HDFS网页,发现进不去了
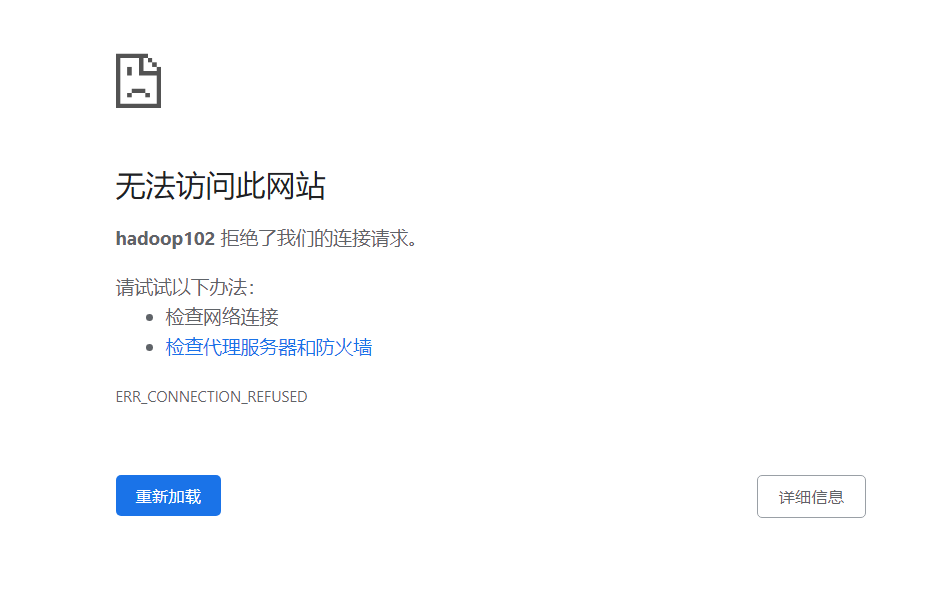
查看发现namenode还是没有启动
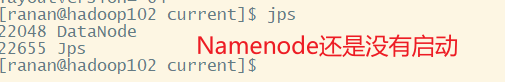
那该怎么办?
正确处理方法
1 回到hadoop的家目录
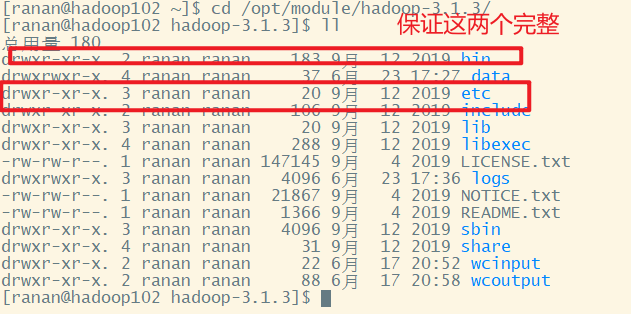
2 杀死进程
[ranan@hadoop102 hadoop-3.1.3]$ sbin/stop-dfs.sh
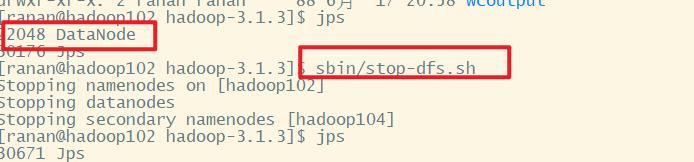
3 删除每个集群的data和logs
[ranan@hadoop102 hadoop-3.1.3]$ rm -rf data logs

[ranan@hadoop103 hadoop-3.1.3]$ rm -rf data logs

[ranan@hadoop104 hadoop-3.1.3]$ rm -rf data logs
4 格式化
[ranan@hadoop102 hadoop-3.1.3]$ hdfs namenode -format
5 启动集群
[ranan@hadoop102 hadoop-3.1.3]$ hdfs namenode -format
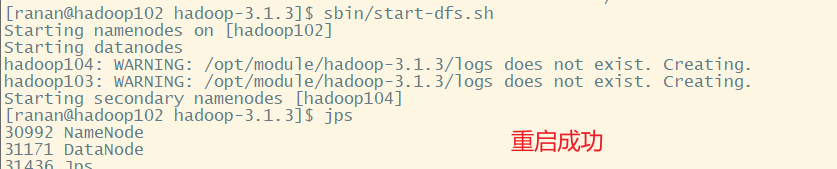
重启成功,但是数据都被清空了
总结
1.先停HDFS服务
2.清除所有节点的历史data和logs
3.格式化NameNode
4.重新启动
原因分析
格式化 NameNode,会产生新的集群 id,导致 NameNode 和 DataNode 的集群 id 不一致,集群找不到已往数据。如果集群在运行过程中报错,需要重新格式化 NameNode 的话,一定要先停止 namenode 和 datanode 进程,并且要删除所有机器的 data 和 logs 目录,然后再进行格式化。
namenode,datanode都有自己的版本号。namenode和datanode是一一绑定的。
格式化以后的namenode是匹配不上没有格式化以前的datanode。
版本要能匹配的上
Hadoop入门 集群崩溃的处理方法的更多相关文章
- Hadoop入门 集群常用知识与常用脚本总结
目录 集群常用知识与常用脚本总结 集群启动/停止方式 1 各个模块分开启动/停止(常用) 2 各个服务组件逐一启动/停止 编写Hadoop集群常用脚本 1 Hadoop集群启停脚本myhadoop.s ...
- Hadoop入门 集群时间同步
集群时间同步 如果服务器在公网环境(能连接外网),可以不采用集群时间同步.因为服务器会定期和公网时间进行校准. 如果服务器在内网环境,必须要配置集群时间同步,否则时间久了,会产生时间偏差,导致集群执行 ...
- hadoop集群崩溃,因为tmp下/tmp/hadoop-hadoop/dfs/name文件误删除
hadoop执行start-all后,显示正常启动. starting namenode, logging to /opt/hadoop-0.20.2-cdh3u0/logs/hadoop-hadoo ...
- hadoop+spark集群搭建入门
忽略元数据末尾 回到原数据开始处 Hadoop+spark集群搭建 说明: 本文档主要讲述hadoop+spark的集群搭建,linux环境是centos,本文档集群搭建使用两个节点作为集群环境:一个 ...
- 使用Docker在本地搭建Hadoop分布式集群
学习Hadoop集群环境搭建是Hadoop入门必经之路.搭建分布式集群通常有两个办法: 要么找多台机器来部署(常常找不到机器) 或者在本地开多个虚拟机(开销很大,对宿主机器性能要求高,光是安装多个虚拟 ...
- 超快速使用docker在本地搭建hadoop分布式集群
超快速使用docker在本地搭建hadoop分布式集群 超快速使用docker在本地搭建hadoop分布式集群 学习hadoop集群环境搭建是hadoop入门的必经之路.搭建分布式集群通常有两个办法: ...
- Hadoop基础-Hadoop的集群管理之服役和退役
Hadoop基础-Hadoop的集群管理之服役和退役 作者:尹正杰 版权声明:原创作品,谢绝转载!否则将追究法律责任. 在实际生产环境中,如果是上千万规模的集群,难免一个一个月会有那么几台服务器出点故 ...
- 一脸懵逼学习Hadoop分布式集群HA模式部署(七台机器跑集群)
1)集群规划:主机名 IP 安装的软件 运行的进程master 192.168.199.130 jdk.hadoop ...
- 基于zookeeper的高可用Hadoop HA集群安装
(1)hadoop2.7.1源码编译 http://aperise.iteye.com/blog/2246856 (2)hadoop2.7.1安装准备 http://aperise.iteye.com ...
随机推荐
- Des加密解密(公共方法)
1 public class Des 2 { 3 public static string Encrypt(string message, string key) 4 { 5 DES des = ne ...
- linux exit 和 _exit的区别
今天仔细看了一下exit和_exit这两个函数的区别,实际上exit也是调用了_exit退出函数的,只不过在调用_exit之前,exit还进行了一些多余的工作,也正是因为这样,相比起来exit就没有那 ...
- DeWeb 简介
DeWeb是一个可以直接将Delphi程序快速转换为网页应用的工具! 使用DeWeb, 开发者不需要学习HTML.JavaScript.Java.PHP.ASP.C#等新知识,用Delphi搞定一切. ...
- split,cdn,shell脚本,tmux,记一次往国外服务器传大文件的经历
需求是这样的:将一个大概680M的Matlab数据文件传到国外某所大学的服务器上,服务器需要连接VPN才能访问,由于数据文件太大,而且如果我直接ssh连过去或者用ftp传输,那么中间很可能中断. ps ...
- 跟着老猫来搞GO,基础进阶
回顾一下上一篇博客,主要是和大家分享了GO语言的基础语法,其中包含变量定义,基本类型,条件语句,循环语句.那本篇呢就开始和大家同步一下GO语言基础的进阶. 函数的定义 上次其实在很多的DEMO中已经写 ...
- Robot Framework操作MySQL数据库
1.安装databaselibrary.pymysql 通过cmd命令执行:pip install robotframework-databaselibrary cmd命令执行:pip install ...
- mysqld:未被识别的服务(解决方法)
启动Mysql:sudo service mysqld start 执行该命令时,提示错误 mysqld:未被识别的服务,如图 解决办法如下: 1·.首先要找到 mysql.server 文件 命 ...
- go条件语句
1. if else package main import "fmt" func main(){ a :=123 if a>100{ fmt.prinln("大于 ...
- mac 工作区
https://www.zhihu.com/question/20917614 http://www.bjhee.com/mission-control.html 窗口切换 https://sspai ...
- 【JAVA】笔记(7)--- 数组精讲
数组的静态初始化: 1.一维数组: int [ ] arr = { 1,2,3,4 } ; Object [ ] arr = { new Object ( ) , new Object ( ) , ...