
kafka概念使用简介注意点
使用场景
大数据量、低并发、高可用、订阅消费场景
概念理解
分区个数与消费者个数
分区个数 = 消费者个数 :最合适状态
分区个数 > 消费者个数 :某些消费者要承担更多的分区数据消费
分区个数 < 消费者个数 :浪费资源
当“某些消费者要承担更多的分区数据消费”,消费者接收的数据不能保证全局有序性,但能保证同一分区的数据是有序的
groupId作用
采用同一groupId,分区个数 >= 消费者个数,每个消费者都会消费数据
采用同一groupId,分区个数<消费者个数,某些消费者不会接收数据
采用不同groupId,各个groupId的消费者相互不受影响
命令行使用
启动:.\bin\windows\kafka-server-start.bat .\config\server.properties
创建topic:.\bin\windows\kafka-topics.bat --create --zookeeper localhost:2181 --replication-factor 1 --partitions 1 --topic lilei
开启生产者:kafka-console-producer.bat --broker-list localhost:9092 --topic lilei
开启消费者:kafka-console-consumer.bat --zookeeper localhost:2181 --topic lilei
java api使用
api 包
<dependency>

            <groupId>org.apache.kafka</groupId>

            <artifactId>kafka_2.11</artifactId>

            <version>1.0.0</version>

</dependency>
生产者
package com.lilei.kafka.liei_kafka;

import java.util.Properties;

import kafka.javaapi.producer.Producer;

import kafka.producer.KeyedMessage;

import kafka.producer.ProducerConfig;

public class KafkaProducer {

    private final Producer<String, String> producer;

    public final static String TOPIC = "topic3";

    private KafkaProducer() {

        Properties props = new Properties();

        // 此处配置的是kafka的端口

        props.put("metadata.broker.list", "127.0.0.1:9092");

        props.put("zk.connect", "127.0.0.1:2181");

        // 配置value的序列化类

        props.put("serializer.class", "kafka.serializer.StringEncoder");

        // 配置key的序列化类

        props.put("key.serializer.class", "kafka.serializer.StringEncoder");

        props.put("request.required.acks", "-1");

        producer = new Producer<String, String>(new ProducerConfig(props));

    }

    void produce() {

        int messageNo = 0;

        final int COUNT = Integer.MAX_VALUE;

        while (messageNo < COUNT) {

            String key = String.valueOf(messageNo);

            try {

                Thread.sleep(300);

            } catch (InterruptedException e) {

                // TODO Auto-generated catch block

                e.printStackTrace();

            }

            String data = "hello kafka message " + key;

            producer.send(new KeyedMessage<String, String>(TOPIC, key, data));

            System.out.println(data);

            messageNo++;

        }

    }

    public static void main(String[] args) {

        new KafkaProducer().produce();

    }

}
消费者
package com.lilei.kafka.liei_kafka;

import java.util.HashMap;

import java.util.List;

import java.util.Map;

import java.util.Properties;

import kafka.consumer.ConsumerConfig;

import kafka.consumer.ConsumerIterator;

import kafka.consumer.KafkaStream;

import kafka.javaapi.consumer.ConsumerConnector;

import kafka.message.MessageAndMetadata;

import kafka.serializer.StringDecoder;

import kafka.utils.VerifiableProperties;

public class KafkaConsumer {

    private final ConsumerConnector consumer;

    private KafkaConsumer() {

        Properties props = new Properties();

        // zookeeper 配置

        props.put("zookeeper.connect", "localhost:2181");

        // group 代表一个消费组

        props.put("group.id", "vvvxyzv");

        // zk连接超时

        props.put("zookeeper.session.timeout.ms", "5000");

        props.put("zookeeper.sync.time.ms", "10000");

        props.put("rebalance.max.retries", "10");

        props.put("rebalance.backoff.ms", "2000");

        props.put("auto.commit.interval.ms", "1000");

        props.put("auto.offset.reset", "smallest");

        // 序列化类

        props.put("serializer.class", "kafka.serializer.StringEncoder");

        ConsumerConfig config = new ConsumerConfig(props);

        consumer = kafka.consumer.Consumer.createJavaConsumerConnector(config);

    }

    void consume() {

        String topic = "topic3";

        Map<String, Integer> topicCountMap = new HashMap<String, Integer>();

        topicCountMap.put(topic, new Integer(1));

        StringDecoder keyDecoder = new StringDecoder(new VerifiableProperties());

        StringDecoder valueDecoder = new StringDecoder(new VerifiableProperties());

        Map<String, List<KafkaStream<String, String>>> consumerMap = consumer.createMessageStreams(topicCountMap, keyDecoder, valueDecoder);

        KafkaStream<String, String> stream = consumerMap.get(topic).get(0);

        ConsumerIterator<String, String> it = stream.iterator();

        while (it.hasNext())

        {

            MessageAndMetadata<String,String> mam = it.next();

            System.out.println(mam.key()+"---"+mam.message());

        }

//            System.out.println("<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<" + it.next().message() + "<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<<");

    }

    public static void main(String[] args) {

        new KafkaConsumer().consume();

    }

}
注意点
使用的kafka api版本要注意,在不合适或者存在bug的状态下,会报: kafka.common.ConsumerRebalanceFailedException
监控
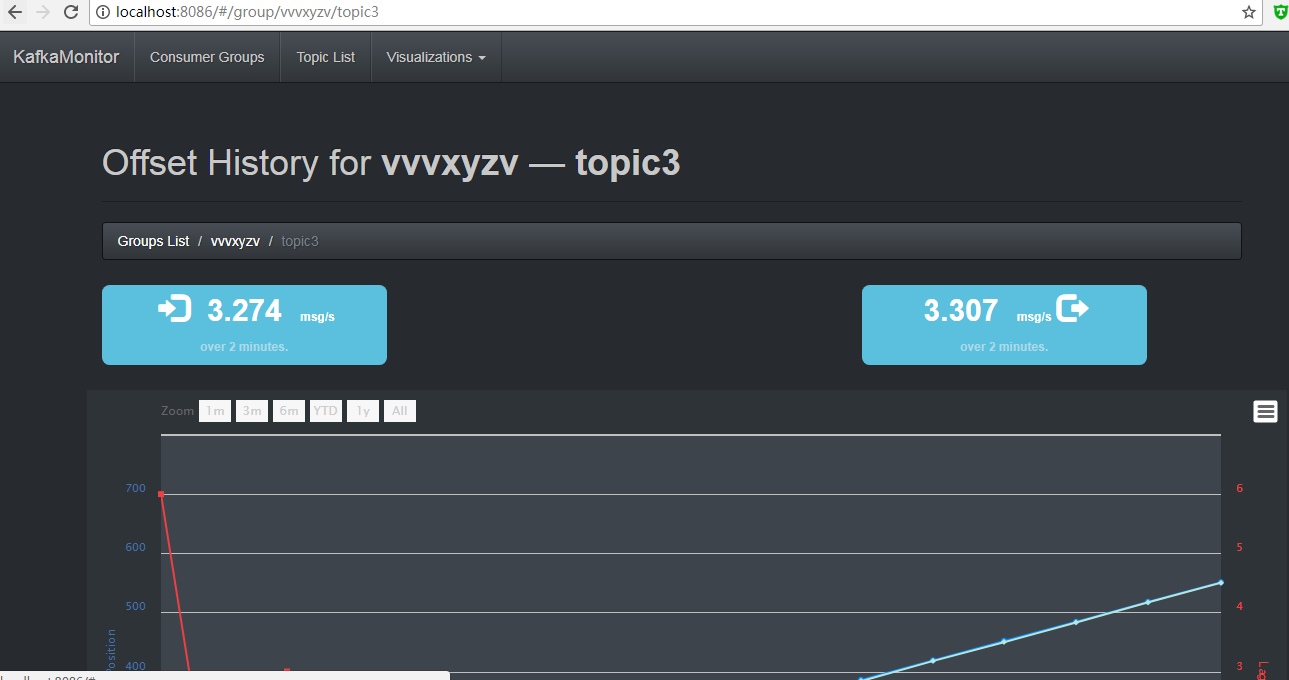
java -cp KafkaOffsetMonitor-assembly-0.2.0.jar com.quantifind.kafka.offsetapp.OffsetGetterWeb --zk localhost:2181 --port 8086 --refresh 10.seconds --retain 2.days
kafka概念使用简介注意点的更多相关文章
- Kafka 概念、单机搭建与使用
目录 Kafka 概念.单机搭建与使用 基本概念介绍 Topic Producer Consumer Kafka单机配置,一个Broker 环境: 配置zookeeper 配置Kafka 使用Kafk ...
- Kafka 探险 - 架构简介
Kafka 探险 - 架构简介 这个 Kafka 的专题,我会从系统整体架构,设计到代码落地.和大家一起杠源码,学技巧,涨知识.希望大家持续关注一起见证成长! 我相信:技术的道路,十年如一日!十年磨一 ...
- 【转】kafka概念入门[一]
转载的,原文:http://www.cnblogs.com/intsmaze/p/6386616.html ---------------------------------------------- ...
- [转帖]kafka入门:简介、使用场景、设计原理、主要配置及集群搭建
kafka入门:简介.使用场景.设计原理.主要配置及集群搭建 http://www.aboutyun.com/thread-9341-1-1.html 还没看完 感觉挺好的. 问题导读: 1.zook ...
- Kafka官方文档翻译——简介
简介 Kafka擅长于做什么? 它被用于两大类应用: 在应用间构建实时的数据流通道 构建传输或处理数据流的实时流式应用 几个概念: Kafka以集群模式运行在1或多台服务器上 Kafka以topics ...
- Kafka:架构简介【转】
转:http://www.cnblogs.com/f1194361820/p/6026313.html Kafka 架构简介 Kafka是一个开源的.分布式的.可分区的.可复制的基于日志提交的发布订阅 ...
- kafka入门:简介、使用场景、设计原理、主要配置及集群搭建(转)
问题导读: 1.zookeeper在kafka的作用是什么? 2.kafka中几乎不允许对消息进行"随机读写"的原因是什么? 3.kafka集群consumer和producer状 ...
- kafka概念
一.结构与概念解释 1.基础概念 topics: kafka通过topics维护各类信息. producer:发布消息到Kafka topic的进程. consumer:订阅kafka topic进程 ...
- 漫游Kafka介绍章节简介
原文地址:http://blog.csdn.net/honglei915/article/details/37564521 介绍 Kafka是一个分布式的.可分区的.可复制的消息系统.它提供了普通消息 ...
随机推荐
- python_crawler,批量下载文件
这个第一个python3网络爬虫,参考书籍是<python网络数据采集>.该爬虫的主要功能是爬取某个网站,并将.rar,.doc,.docx,.zip文件批量下载. 后期将要改进的是,用后 ...
- 2018年最完整5大网页设计图标解决方案:Font Awesome奥森图Unicode、CSS 和、Font以及国产zfont图标集
网上有很多高质量的图标,基于icon的关键词能在Google上搜索到不少内容,不考虑版权外还要修改大小.颜色等等,现在介绍一些替代方案:Unicode.CSS 和 Font,它具有更高的灵活性. 方案 ...
- 《精通android网络开发》--HTTP数据通信
No1: 例如:http://www.*****.com/china/index.htm 1)http:// 代表超文本传送协议,通知*****.com服务器显示web页,通常不用输入 2)www 代 ...
- soj3129: windy和水星 -- 水星数学家 2
注意int的范围:-2147483648-2147483647 如果输入会出现溢出,这题应该就是卡的这里.其使用long long就不用考虑这个. 加深:如果输入的数是很多位,直接当做字符串处理即可. ...
- js基本类型与引用类型,浅拷贝和深拷贝
1. 基本类型: string,number,boolean,null,undefined 2. 引用类型: Function,Array,Object 基本类型:存放在栈内存中的简单数据段,数据大小 ...
- R用户的福音︱TensorFlow:TensorFlow的R接口
------------------------------------------------------------ Matt︱R语言调用深度学习架构系列引文 R语言︱H2o深度学习的一些R语言实 ...
- HighCharts中的无主题的2D折线图
HighCharts中的无主题的2D折线图 1.设计源码 <!DOCTYPE html> <html> <head> <meta charset=" ...
- SMBus
SMBus (System Management Bus,系统管理总线) 是1995年由Intel提出的,应用于移动PC和桌面PC系统中的低速率通讯.希望通过一条廉价并且功能强大的总线(由两条线组成) ...
- JavaScript向select下拉框中添加和删除元素
JavaScript向select下拉框中添加和删除元素 1.说明 a 利用append()方法向下拉框中添加元素 b 利用remove()方法移除下拉框中最后一个元素 2.设计源码 < ...
- freemarker基本数据类型(十一)
freemarker基本数据类型 1.基本数据类型 (1)字符串 (2)数字 (3)布尔值 (4)日期 2.展示示例 <html> <head> <meta http-e ...