
决策树 Decision Tree
决策树是一个类似于流程图的树结构:其中,每个内部结点表示在一个属性上的测试,每个分支代表一个属性输出,而每个树叶结点代表类或类分布。树的最顶层是根结点。
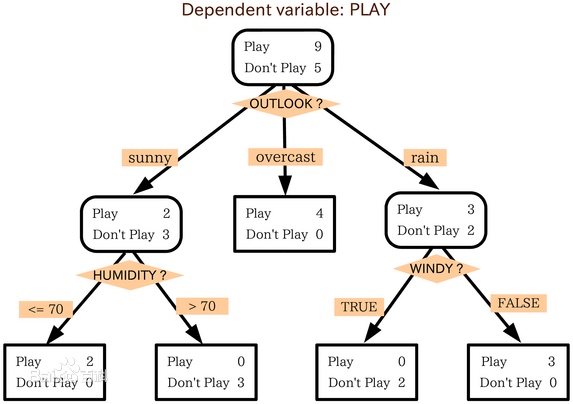 
决策树的构建
想要构建一个决策树,那么咱们首先就需要有一定的已知信息来作为决策树的构建依据。
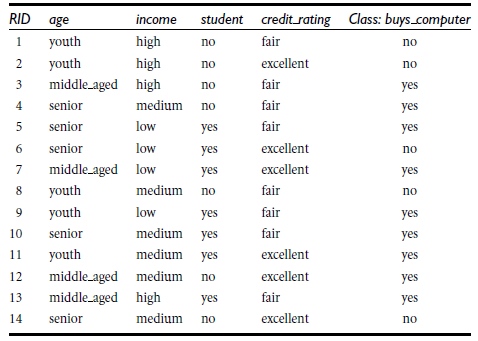
我们采用下图的数据来进行构建 决策树
一个完整的数据应该包括数据特征和对应的决策信息
下表中的数据,代表对购买电脑的客户信息的记录,分为age/imcome/student...等信息
在该数据源中,age 到 credit_rating 这4列称为特征,最后的class:buys_computer 代表最终的决策信息
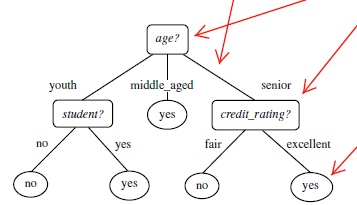
首先选择一个节点为开始(age),再根据该节点往下拓展,分为youth,middle_aged,seniors
根据这三类去上图的数据源检索,可以得出 当middle_aged时,clas_lable全部为yes,所以该分支就结束了。
重复上面的流程...知道最后的节点都是 决策结果信息
信息熵
流程和基本原理了解后,我们就要考虑一个问题:
信息,如何度量?
1948年,香农提出了 ”信息熵(entropy)“的概念
一条信息的信息量大小和它的不确定性有直接的关系,要搞清楚一件非常非常不确定的事情,或者是我们一无所知的事情,需要了解大量信息==>信息量的度量就等于不确定性的多少
      例子:猜世界杯冠军,假如一无所知,猜多少次?

      每个队夺冠的几率不是相等的
信息熵用 比特(bit) 来衡量信息的多少
信息熵公式为:
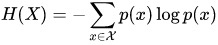 
大写X代表信息集合
小写x代表集合中的某一
p(x)代表概率
假设 X={A,B,C}
A概率为0.2,
B概率为0.4,
C概率为0.6
那么计算结果为
-0.2 * log 0.2 +
-0.4 * log 0.4 +
-0.6 * log 0.6 的和
策树归纳算法 (ID3)
ID3算法是根据信息获取量(Information Gain):
Gain(A) = Info(D) - Infor_A(D)
通过A来作为节点分类获取了多少信息
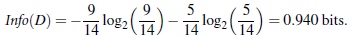 
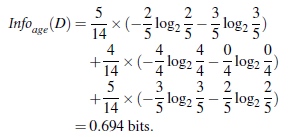 
类似,Gain(income) = 0.029, Gain(student) = 0.151, Gain(credit_rating)=0.048
代码实现
数据源为第一个表格的数据
# 决策树

from sklearn.feature_extraction import DictVectorizer

import csv

from sklearn import tree

from sklearn import preprocessing

import pydotplus

# Read csv file

allElectronicsData = open('AllElectronics.csv','r')

csvReader = csv.reader(allElectronicsData)

# csvList = [ r for r in csvReader]

# print(csvList)

# 取头

headers = next(csvReader)

# print(headers)

featureList =[] #特征

labelList = []  #头

# 字典化所有特征

for row in csvReader:

    labelList.append(row[len(row) - 1])

    rowDic = {}

    for i in (range(1,len(row)-1)):

        rowDic[headers[i]] = row[i]

    # print(rowDic)

    featureList.append(rowDic)

print(featureList)

print(labelList)

# 矢量化 特征

vec = DictVectorizer()

dummyX = vec.fit_transform(featureList).toarray()

print("dummyX:")

print(str(dummyX))

print(vec.get_feature_names())

# 矢量化 class label

lb = preprocessing.LabelBinarizer()

dummyY = lb.fit_transform(labelList)

print("dummyY:")

print(dummyY)

# 构建决策树

clf = tree.DecisionTreeClassifier(criterion="entropy")

clf = clf.fit(dummyX,dummyY)

print("clf: ")

print(str(clf))

# 查看决策树

csvDot = tree.export_graphviz(clf,feature_names=vec.get_feature_names(),out_file=None)

graph = pydotplus.graph_from_dot_data(csvDot)

graph.write_pdf('1.pdf')

# Image(graph.create_png())

# 使用决策树计算

# 这里直接使用已经矢量化完事的数据来修改一下 进行预测,正常应该采用原始数据进行预处理后 进行预测

new_Data = dummyX[0, :]

print(dummyX[0, :])

# print(new_Data)

new_Data[0] = 0

new_Data[2] = 1

# print(new_Data)

# 预测该数据

predictedY = clf.predict([new_Data])

print(predictedY)
决策树 Decision Tree的更多相关文章
- 机器学习算法实践:决策树 (Decision Tree)(转载)
前言 最近打算系统学习下机器学习的基础算法,避免眼高手低,决定把常用的机器学习基础算法都实现一遍以便加深印象.本文为这系列博客的第一篇,关于决策树(Decision Tree)的算法实现,文中我将对决 ...
- 数据挖掘 决策树 Decision tree
数据挖掘-决策树 Decision tree 目录 数据挖掘-决策树 Decision tree 1. 决策树概述 1.1 决策树介绍 1.1.1 决策树定义 1.1.2 本质 1.1.3 决策树的组 ...
- 决策树Decision Tree 及实现
Decision Tree 及实现 标签: 决策树熵信息增益分类有监督 2014-03-17 12:12 15010人阅读 评论(41) 收藏 举报 分类: Data Mining(25) Pyt ...
- 用于分类的决策树(Decision Tree)-ID3 C4.5
决策树(Decision Tree)是一种基本的分类与回归方法(ID3.C4.5和基于 Gini 的 CART 可用于分类,CART还可用于回归).决策树在分类过程中,表示的是基于特征对实例进行划分, ...
- (ZT)算法杂货铺——分类算法之决策树(Decision tree)
https://www.cnblogs.com/leoo2sk/archive/2010/09/19/decision-tree.html 3.1.摘要 在前面两篇文章中,分别介绍和讨论了朴素贝叶斯分 ...
- 决策树decision tree原理介绍_python sklearn建模_乳腺癌细胞分类器(推荐AAA)
sklearn实战-乳腺癌细胞数据挖掘(博主亲自录制视频) https://study.163.com/course/introduction.htm?courseId=1005269003& ...
- 机器学习方法(四):决策树Decision Tree原理与实现技巧
欢迎转载,转载请注明:本文出自Bin的专栏blog.csdn.net/xbinworld. 技术交流QQ群:433250724,欢迎对算法.技术.应用感兴趣的同学加入. 前面三篇写了线性回归,lass ...
- 机器学习-决策树 Decision Tree
咱们正式进入了机器学习的模型的部分,虽然现在最火的的机器学习方面的库是Tensorflow, 但是这里还是先简单介绍一下另一个数据处理方面很火的库叫做sklearn.其实咱们在前面已经介绍了一点点sk ...
- 【机器学习算法-python实现】决策树-Decision tree(2) 决策树的实现
(转载请注明出处:http://blog.csdn.net/buptgshengod) 1.背景 接着上一节说,没看到请先看一下上一节关于数据集的划分数据集划分.如今我们得到了每一个特征值得 ...
随机推荐
- functools.wraps函数
原文地址:https://www.cnblogs.com/fcyworld/p/6239951.html 第一次见到functools.wraps是在 Flask Web开发 中,一直不明白怎么回事. ...
- Javascript 的变量提升与预解析
一.什么是变量提升 在ES6之前,JavaScript没有块级作用域(一对花括号{}即为一个块级作用域),只有全局作用域和函数作用域.变量提升即将变量声明提升到它所在作用域的最开始的部分 二.怎么实现 ...
- margin与padding的bug
1.在页面布局时,值对于块元素来说,相邻的两个兄弟块元素间的margin-top与上一个兄弟的margin-bottom重合时, 解决办法:对其中一个块元素中设置 display:inline- ...
- pandas中Dataframe的查询方法([], loc, iloc, at, iat, ix)
数据介绍 先随机生成一组数据: import pandas as pd import numpy as np state = ['Ohio', 'Ohio', 'Ohio', 'Nevada', 'N ...
- NOIP-比例简化
题目描述 在社交媒体上,经常会看到针对某一个观点同意与否的民意调查以及结果.例如,对某一观点表示支持的有 1498 人,反对的有 902 人,那么赞同与反对的比例可以简单的记为 1498:902 . ...
- mysql练习
1.表关系 创建如下表格,并创建相关约束 ##(1)创建一个数据库 create database db2 default charset utf8; ##切换到db2数据库中 use db2 ##创 ...
- Java for Andriod 第二周学习总结
第四章 学习时遇到的问题或新知识点: 1. 构造方法.每个类至少有一个构造方法,且构造方法必须的名称必须与类名相同. 2. Varargs.允许方法拥有一个可变长度的参数列表. 3. 对象的内存分配. ...
- vue中添加title中的小图标
webpack.prod.conf.js 这个文件中: 引入代码const path = require('path') :下面是进行配置: new HtmlWebpackPlugin({ filen ...
- composer 实现自动加载原理
简介 一般在框架中都会用到composer工具,用它来管理依赖.其中composer有类的自动加载机制,可以加载composer下载的库中的所有的类文件.那么composer的自动加载机制是怎么实现的 ...
- python获取函数注释 __doc__
使用 help 函数 可以查看 函数的注释内容 但是它也有点"添油加醋" 其实函数的注释被保存在 __doc__属性里面 PS 双下划线 def f(): "&quo ...