
MNIST机器学习
MNIST是一个入门级的计算机视觉数据集,它包含各种手写数字图片:
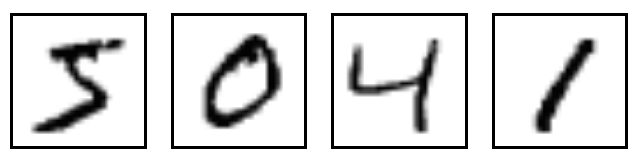
1. MNIST数据集
MNIST,是不是听起来特高端大气,不知道这个是什么东西?
== 手写数字分类问题所要用到的(经典)MNIST数据集 ==
MNIST数据集的官网是Yann LeCun's website
自动下载和安装这个数据集的python代码
该段代码在tensorflow/examples/tutorials/mnist/input_data.py
"""Functions for downloading and reading MNIST data."""

from __future__ import absolute_import

from __future__ import division

from __future__ import print_function

import gzip

import os

import tempfile

import numpy

from six.moves import urllib

from six.moves import xrange  # pylint: disable=redefined-builtin

import tensorflow as tf

from tensorflow.contrib.learn.python.learn.datasets.mnist import read_data_sets
导入项目
import tensorflow.examples.tutorials.mnist.input_data

import input_data

mnist = input_data.read_data_sets("MNIST_data/", one_hot=True)
2. 运行TensorFlow的InteractiveSession
使用TensorFlow之前,首先导入它:
import tensorflow as tf

sess = tf.InteractiveSession()
3. 计算图
为了在Python中进行高效的数值计算,我们通常会使用像NumPy一类的库,将一些诸如矩阵乘法的耗时操作在Python环境的外部来计算,这些计算通常会通过其它语言并用更为高效的代码来实现。
但遗憾的是,每一个操作切换回Python环境时仍需要不小的开销。如果你想在GPU或者分布式环境中计算时,这一开销更加可怖,这一开销主要可能是用来进行数据迁移。
TensorFlow也是在Python外部完成其主要工作,但是进行了改进以避免这种开销。其并没有采用在Python外部独立运行某个耗时操作的方式,而是先让我们描述一个交互操作图,然后完全将其运行在Python外部。这与Theano或Torch的做法类似。
因此Python代码的目的是用来构建这个可以在外部运行的计算图,以及安排计算图的哪一部分应该被运行。详情请查看基本用法中的计算图表一节。
4. 实现softmax回归模型
4.1 占位符
我们通过为输入图像 x 和目标输出类别 y_ 创建节点,来开始构建计算图
我们通过操作符号变量来描述这些可交互的操作单元,可以用下面的方式创建一个:
x = tf.placeholder("float", shape=[None, 784])

y_ = tf.placeholder("float", shape=[None, 10])
x不是一个特定的值,而是一个占位符placeholder,我们在TensorFlow运行计算时输入这个值。我们希望能够输入任意数量的MNIST图像,每一张图展平成784维的向量。我们用2维的浮点数张量来表示这些图,这个张量的形状是[None,784 ]。(这里的None表示此张量的第一个维度可以是任何长度的。)
输出类别值y_也是一个2维张量,其中每一行为一个10维的one-hot向量,用于代表对应某一MNIST图片的类别。
虽然placeholder的shape参数是可选的,但有了它,TensorFlow能够自动捕捉因数据维度不一致导致的错误。
4.2 变量
我们的模型也需要权重值和偏置量,当然我们可以把它们当做是另外的输入(使用占位符),但TensorFlow有一个更好的方法来表示它们:Variable 。 一个Variable代表一个可修改的张量,存在在TensorFlow的用于描述交互性操作的图中。它们可以用于计算输入值,也可以在计算中被修改。对于各种机器学习应用,一般都会有模型参数,可以用Variable表示。
W = tf.Variable(tf.zeros([784,10]))

b = tf.Variable(tf.zeros([10]))
我们在调用tf.Variable的时候传入初始值。在这个例子里,我们把W和b都初始化为零向量。W是一个784x10的矩阵(因为我们有784个特征和10个输出值)。b是一个10维的向量(因为我们有10个分类)
变量需要通过seesion初始化后,才能在session中使用。这一初始化步骤为,为初始值指定具体值(本例当中是全为零),并将其分配给每个变量,可以一次性为所有变量完成此操作。
sess.run(tf.initialize_all_variables())
5. 类别预测
现在,我们可以实现我们的模型啦。只需要一行代码!计算每个分类的softmax概率值
y = tf.nn.softmax(tf.matmul(x,W) + b)
tf.matmul(X,W)表示x乘以W,对应之前等式里面的Wx,这里x是一个2维张量拥有多个输入。然后再加上b,把和输入到tf.nn.softmax函数里面。
为了训练我们的模型,我们首先需要定义一个指标来评估这个模型是好的。其实,在机器学习,我们通常定义指标来表示一个模型是坏的,这个指标称为成本(cost)或损失(loss),然后尽量最小化这个指标。但是,这两种方式是相同的。
一个非常常见的,非常漂亮的成本函数是“交叉熵”(cross-entropy)。交叉熵产生于信息论里面的信息压缩编码技术,但是它后来演变成为从博弈论到机器学习等其他领域里的重要技术手段。它的定义如下:
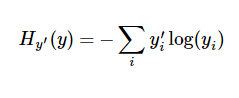
交叉熵是用来衡量我们的预测用于描述真相的低效性。
根据公式计算交叉熵,可以很容易的为训练过程指定最小化误差用的损失函数,我们的损失函数是目标类别和预测类别之间的交叉熵
cross_entropy = -tf.reduce_sum(y_*tf.log(y))
首先,用 tf.log 计算 y 的每个元素的对数。接下来,我们把 y_ 的每一个元素和 tf.log(y) 的对应元素相乘。最后,用 tf.reduce_sum 计算张量的所有元素的总和。(注意,这里的交叉熵不仅仅用来衡量单一的一对预测和真实值,而是所有100幅图片的交叉熵的总和。对于100个数据点的预测表现比单一数据点的表现能更好地描述我们的模型的性能
6. 训练模型
现在我们知道我们需要我们的模型做什么啦,用TensorFlow来训练它是非常容易的。因为TensorFlow拥有一张描述你各个计算单元的图,它可以自动地使用反向传播算法(backpropagation algorithm)来有效地确定你的变量是如何影响你想要最小化的那个成本值的。然后,TensorFlow会用你选择的优化算法来不断地修改变量以降低成本。
train_step = tf.train.GradientDescentOptimizer(0.01).minimize(cross_entropy)
在这里,我们要求TensorFlow用梯度下降算法(gradient descent algorithm)以0.01的学习速率最小化交叉熵。梯度下降算法(gradient descent algorithm)是一个简单的学习过程,TensorFlow只需将每个变量一点点地往使成本不断降低的方向移动。当然TensorFlow也提供了其他许多优化算法:只要简单地调整一行代码就可以使用其他的算法。
TensorFlow在这里实际上所做的是,它会在后台给描述你的计算的那张图里面增加一系列新的计算操作单元用于实现反向传播算法和梯度下降算法。然后,它返回给你的只是一个单一的操作,当运行这个操作时,它用梯度下降算法训练你的模型,微调你的变量,不断减少成本。
然后开始训练模型,这里我们让模型循环训练1000次!
for i in range(1000):

  batch_xs, batch_ys = mnist.train.next_batch(50)

  sess.run(train_step, feed_dict={x: batch_xs, y_: batch_ys})
另一种代码写法
for i in range(1000):

  batch = mnist.train.next_batch(50)

  train_step.run(feed_dict={x: batch[0], y_: batch[1]})
该循环的每个步骤中,我们都会随机抓取训练数据中的50个批处理数据点,然后我们用这些数据点作为参数替换之前的占位符来运行train_step。
使用一小部分的随机数据来进行训练被称为随机训练(stochastic training)- 在这里更确切的说是随机梯度下降训练。在理想情况下,我们希望用我们所有的数据来进行每一步的训练,因为这能给我们更好的训练结果,但显然这需要很大的计算开销。所以,每一次训练我们可以使用不同的数据子集,这样做既可以减少计算开销,又可以最大化地学习到数据集的总体特性。
7. 评估我们的模型
首先让我们找出那些预测正确的标签。tf.argmax 是一个非常有用的函数,它能给出某个tensor对象在某一维上的其数据最大值所在的索引值。由于标签向量是由0,1组成,因此最大值1所在的索引位置就是类别标签,比如tf.argmax(y,1)各个预测数字中概率最大的那一个,而 tf.argmax(y_,1) 代表正确的标签,我们可以用 tf.equal 来检测我们的预测是否真实标签匹配(索引位置一样表示匹配)。
correct_prediction = tf.equal(tf.argmax(y,1), tf.argmax(y_,1))
这行代码会给我们一组布尔值。为了确定正确预测项的比例,我们可以把布尔值转换成浮点数,然后取平均值。例如,[True, False, True, True] 会变成 [1,0,1,1] ,取平均值后得到 0.75.
accuracy = tf.reduce_mean(tf.cast(correct_prediction, "float"))
最后,我们计算所学习到的模型在测试数据集上面的正确率。
print sess.run(accuracy, feed_dict={x: mnist.test.images, y_: mnist.test.labels})

#输出结果

0.9092
8. 代码
from tensorflow.examples.tutorials.mnist import input_data

mnist = input_data.read_data_sets("MNIST_data/", one_hot=True)

print(mnist.train.images.shape, mnist.train.labels.shape)

print(mnist.test.images.shape, mnist.test.labels.shape)

print(mnist.validation.images.shape, mnist.validation.labels.shape)

import tensorflow as tf

sess = tf.InteractiveSession()

x = tf.placeholder(tf.float32, [None, 784])

W = tf.Variable(tf.zeros([784, 10]))

b = tf.Variable(tf.zeros([10]))

y = tf.nn.softmax(tf.matmul(x, W) + b)

y_ = tf.placeholder(tf.float32, [None, 10])

cross_entropy = tf.reduce_mean(-tf.reduce_sum(y_ * tf.log(y), reduction_indices=[1]))

train_step = tf.train.GradientDescentOptimizer(0.5).minimize(cross_entropy)

tf.global_variables_initializer().run()

for i in range(1000):

	batch_xs, batch_ys = mnist.train.next_batch(100)

	train_step.run({x: batch_xs, y_: batch_ys})

correct_prediction = tf.equal(tf.argmax(y, 1), tf.argmax(y_, 1))

accuracy = tf.reduce_mean(tf.cast(correct_prediction, tf.float32))

print(accuracy.eval({x: mnist.test.images, y_: mnist.test.labels}))
MNIST机器学习的更多相关文章
- [转]MNIST机器学习入门
MNIST机器学习入门 转自:http://wiki.jikexueyuan.com/project/tensorflow-zh/tutorials/mnist_beginners.html?plg_ ...
- Tensorflow之MNIST机器学习入门
MNIST机器学习的原理: 通过一次次的 输入某张图片的像素值(用784维向量表示)以及这张图片对应的数字(用10维向量表示比如数字1用[0,1,0,0,0,0,0,0,0,0]表示),来优化10*7 ...
- tensorfllow MNIST机器学习入门
MNIST机器学习入门 这个教程的目标读者是对机器学习和TensorFlow都不太了解的新手.如果你已经了解MNIST和softmax回归(softmax regression)的相关知识,你可以阅读 ...
- Tensorflow学习笔记(一):MNIST机器学习入门
学习深度学习,首先从深度学习的入门MNIST入手.通过这个例子,了解Tensorflow的工作流程和机器学习的基本概念. 一 MNIST数据集 MNIST是入门级的计算机视觉数据集,包含了各种手写数 ...
- TensorFlow框架(3)之MNIST机器学习入门
1. MNIST数据集 1.1 概述 Tensorflow框架载tensorflow.contrib.learn.python.learn.datasets包中提供多个机器学习的数据集.本节介绍的是M ...
- MNIST机器学习数据集
介绍 在学习机器学习的时候,首当其冲的就是准备一份通用的数据集,方便与其他的算法进行比较.在这里,我写了一个用于加载MNIST数据集的方法,并将其进行封装,主要用于将MNIST数据集转换成numpy. ...
- MNIST机器学习入门(一)
一.简介 首先介绍MNIST 数据集.如图1-1 所示, MNIST 数据集主要由一些手写数字的图片和相应的标签组成,图片一共有10 类,分别对应从0-9 ,共10 个阿拉伯数字. 原始的MNIST ...
- 【TensorFlow官方文档】MNIST机器学习入门
MNIST是一个入门级的计算机视觉数据集,它包含各种手写数字图片:它也包含每一张图片对应的标签,告诉我们这个是数字几.比如,下面这四张图片的标签分别是5,0,4,1. 从一个很简单的数学模型开始:训练 ...
- TensorFlow 学习(4)——MNIST机器学习进阶
要进一步改进MNIST学习算法,需要对卷积神经网络进行学习和了解 学习材料参见https://www.cnblogs.com/skyfsm/p/6790245.html 卷积神经网络依旧是层级网络,只 ...
随机推荐
- 蓄水池抽样(原理&实现)
前言: 蓄水池抽样:从N个元素中随机的等概率的抽取k个元素,其中N无法确定. 适用场景: 模式识别等概率抽样,抽样查看渐增的log日志(无法先保存整个数据流然后再从中选取,而是期望有一种将数据流遍历一 ...
- Hibernate中遇见的问题
1.在用Hibernate写增删改查时,有两种方式:a.HQL语句,b.原生态sql语句 如果我要执行的语句是:select * from Question HQL是这么写的: Session ses ...
- Docker建立本地Registry
从容器运行一个Registry # docker run -p : registry 查看yelinyuntest/static_web镜像 # docker images yelinyuntest/ ...
- CentOS7 更换yum源
yum源调整为163wget http://mirrors.163.com/.help/CentOS7-Base-163.repo[root@admin yum.repos.d]# mv CentOS ...
- Linux之nc命令详解
nc是一个强大的网络工具,可以通过yum安装 [root@LB2 ~]# which nc /usr/bin/which: no nc in (/usr/local/sbin:/usr/local/b ...
- Spring Boot 注解的使用
Spring Boot 优于Spring mvc ,SSM,SSH 的一个亮点就是他使用了好多的注解. 1. @Autowired 这个注解的作用是将其他的类,接口引入,类似于之前的类的初始化等,用这 ...
- Apache优化
控制MaxClients的设置,以避免服务器产生太多的子进程而发生交换.进程间的数据交换会占用很大内存,数据交换产生的滞后使用户总感觉"不够快",所以用户就可能去按"停止 ...
- 性能测试培训: 监控CPU之python
性能测试培训: 监控CPU之python 作为一名测试开发工程师,开发脚本是为了测试服务的,我们在手里没有性能监控工具的情况下,我们会自己来进行开发脚本完成监控任务.下面是python监控cpu '' ...
- Javaweb快速学习
孙卫琴老师的javaweb一书已经买了很多年,由于很厚一直也没有去好好阅读下, 项目发布后有闲暇时间,决定快速学习了,毕竟很多概念和知识主要还是复习. 对于互联网,我们可以简单认为浏览器就是会人类语言 ...
- [笔记]GBDT理论知识总结
一. GBDT的经典paper:<Greedy Function Approximation:A Gradient Boosting Machine> Abstract Function ...