
2017-6-6&6-8/大型网站架构总结
- 峰值每秒钟3万个 HTTP 请求
- 每秒钟 3Gbit 流量, 近乎375MB
- 350 台 PC 服务器
2、WikiPedia的主要架构
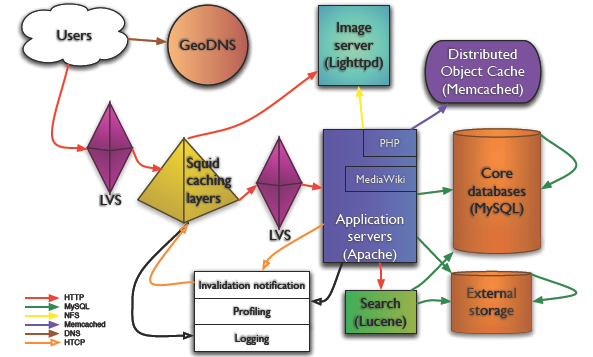
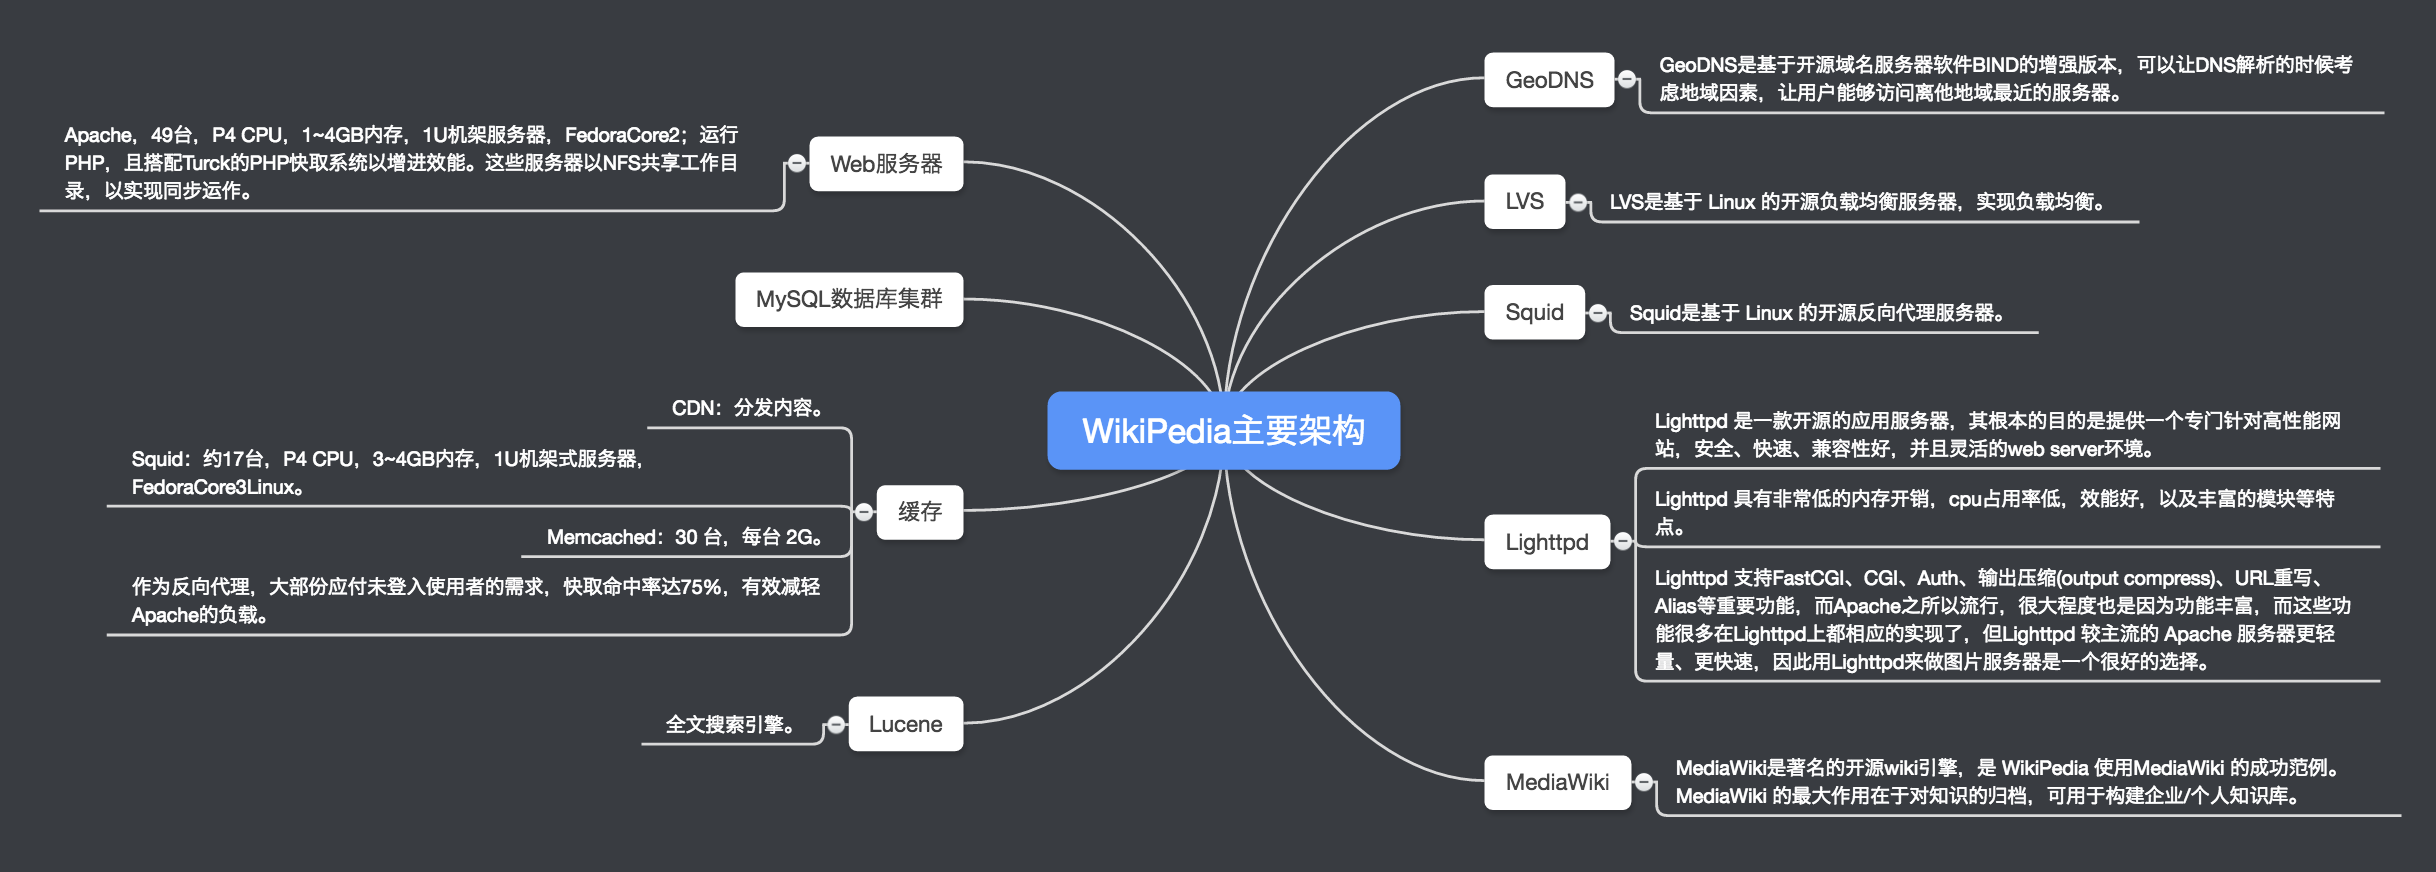
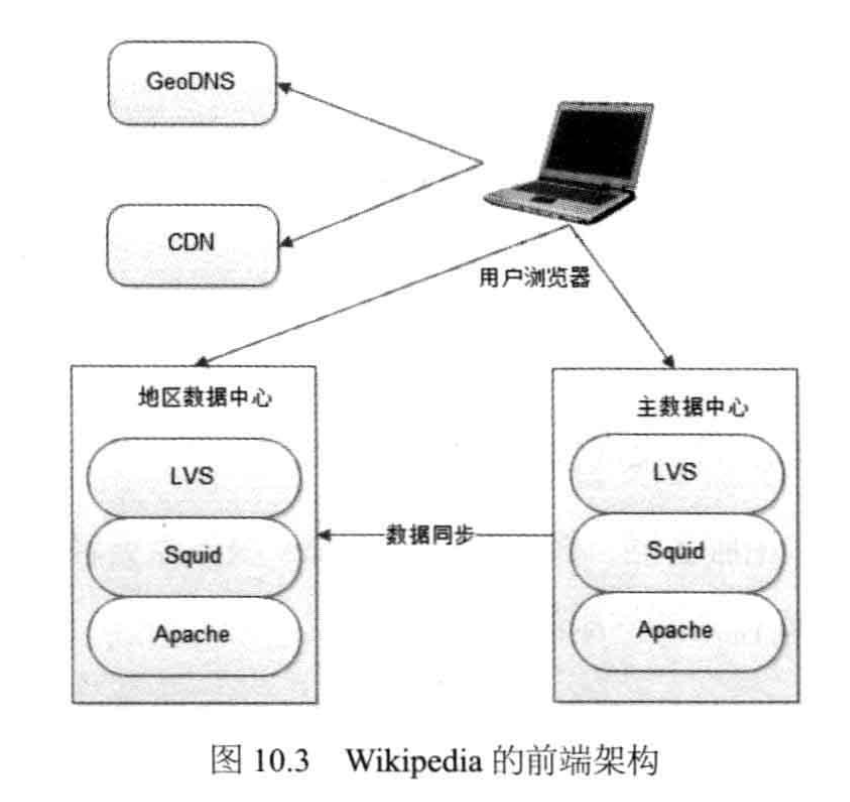
- 每月的页面浏览量:570000000000 (5700亿)
- 照片数量超过其他图片网站的总和(包括诸如Flickr等网站)
- 每个月有超过30亿张照片上传
- 每秒可以处理120万张照片,这还不包括CDN处理的照片
- 每月处理超过25亿条内容 (状态更新,评论等)
- 服务器超过30,000台(此数据为2009年的数据)
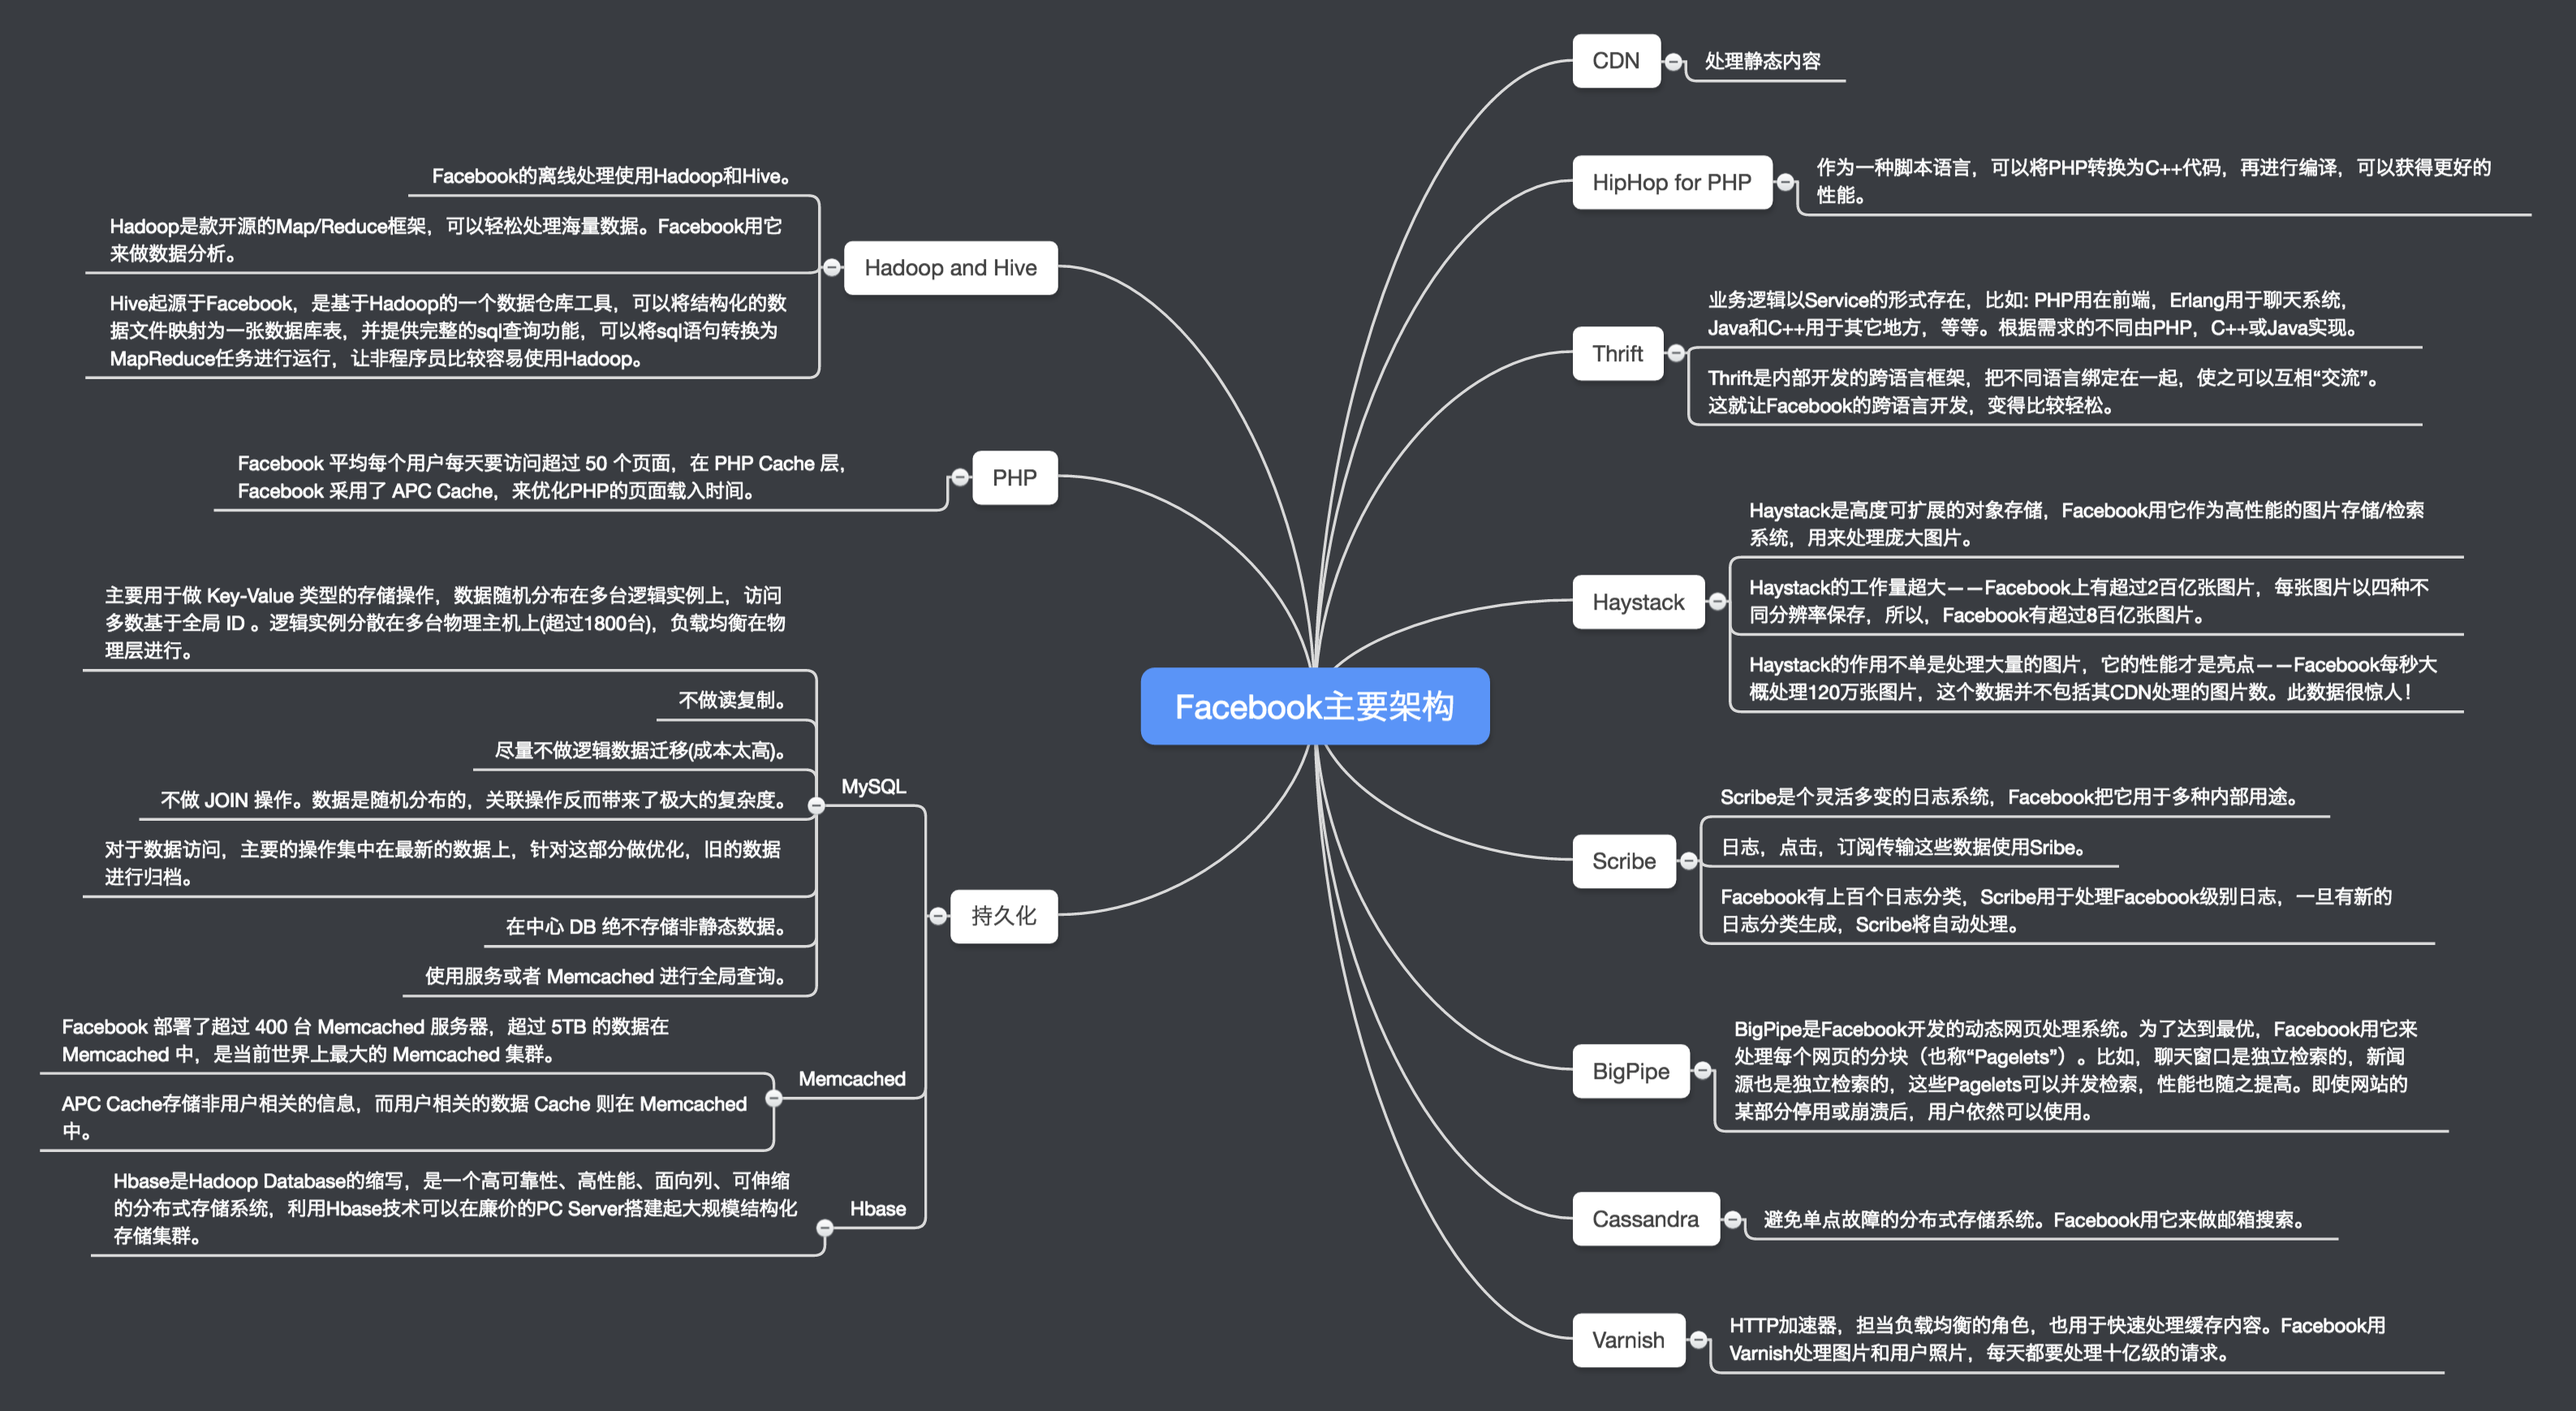
2、Facebook的主要架构
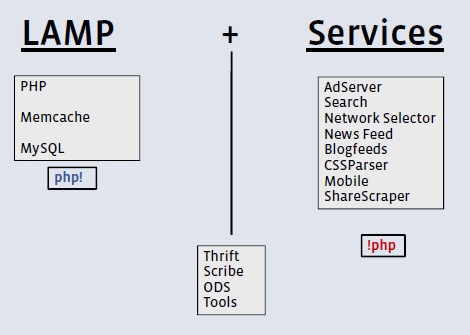
Facebook使用LAMP(Linux、Apache、MySQL、PHP)作为技术构架,为了配合其他大量的组件和服务,Facebook对已有的方法做了必要的改变、拓展和修改。比如:
- Facebook依然使用PHP,但已重建新的编译器,以满足在其Web服务器上加载本地代码,从而提升性能;
- Facebook使用Linux系统,但为了自身目的,也已做了必要的优化,尤其是在网络吞吐量方面;
- Facebook使用MySQL,也对其做优化;
- 还有定制的系统,比如:

- Linux、Oracle、C++、Perl、Mason、Java、Jboss、Servlets
- 超过5500万活动顾客帐号
- 世界范围内超过100万活动零售合作商
- 构建一个页面所需访问的服务介于100至150个之间
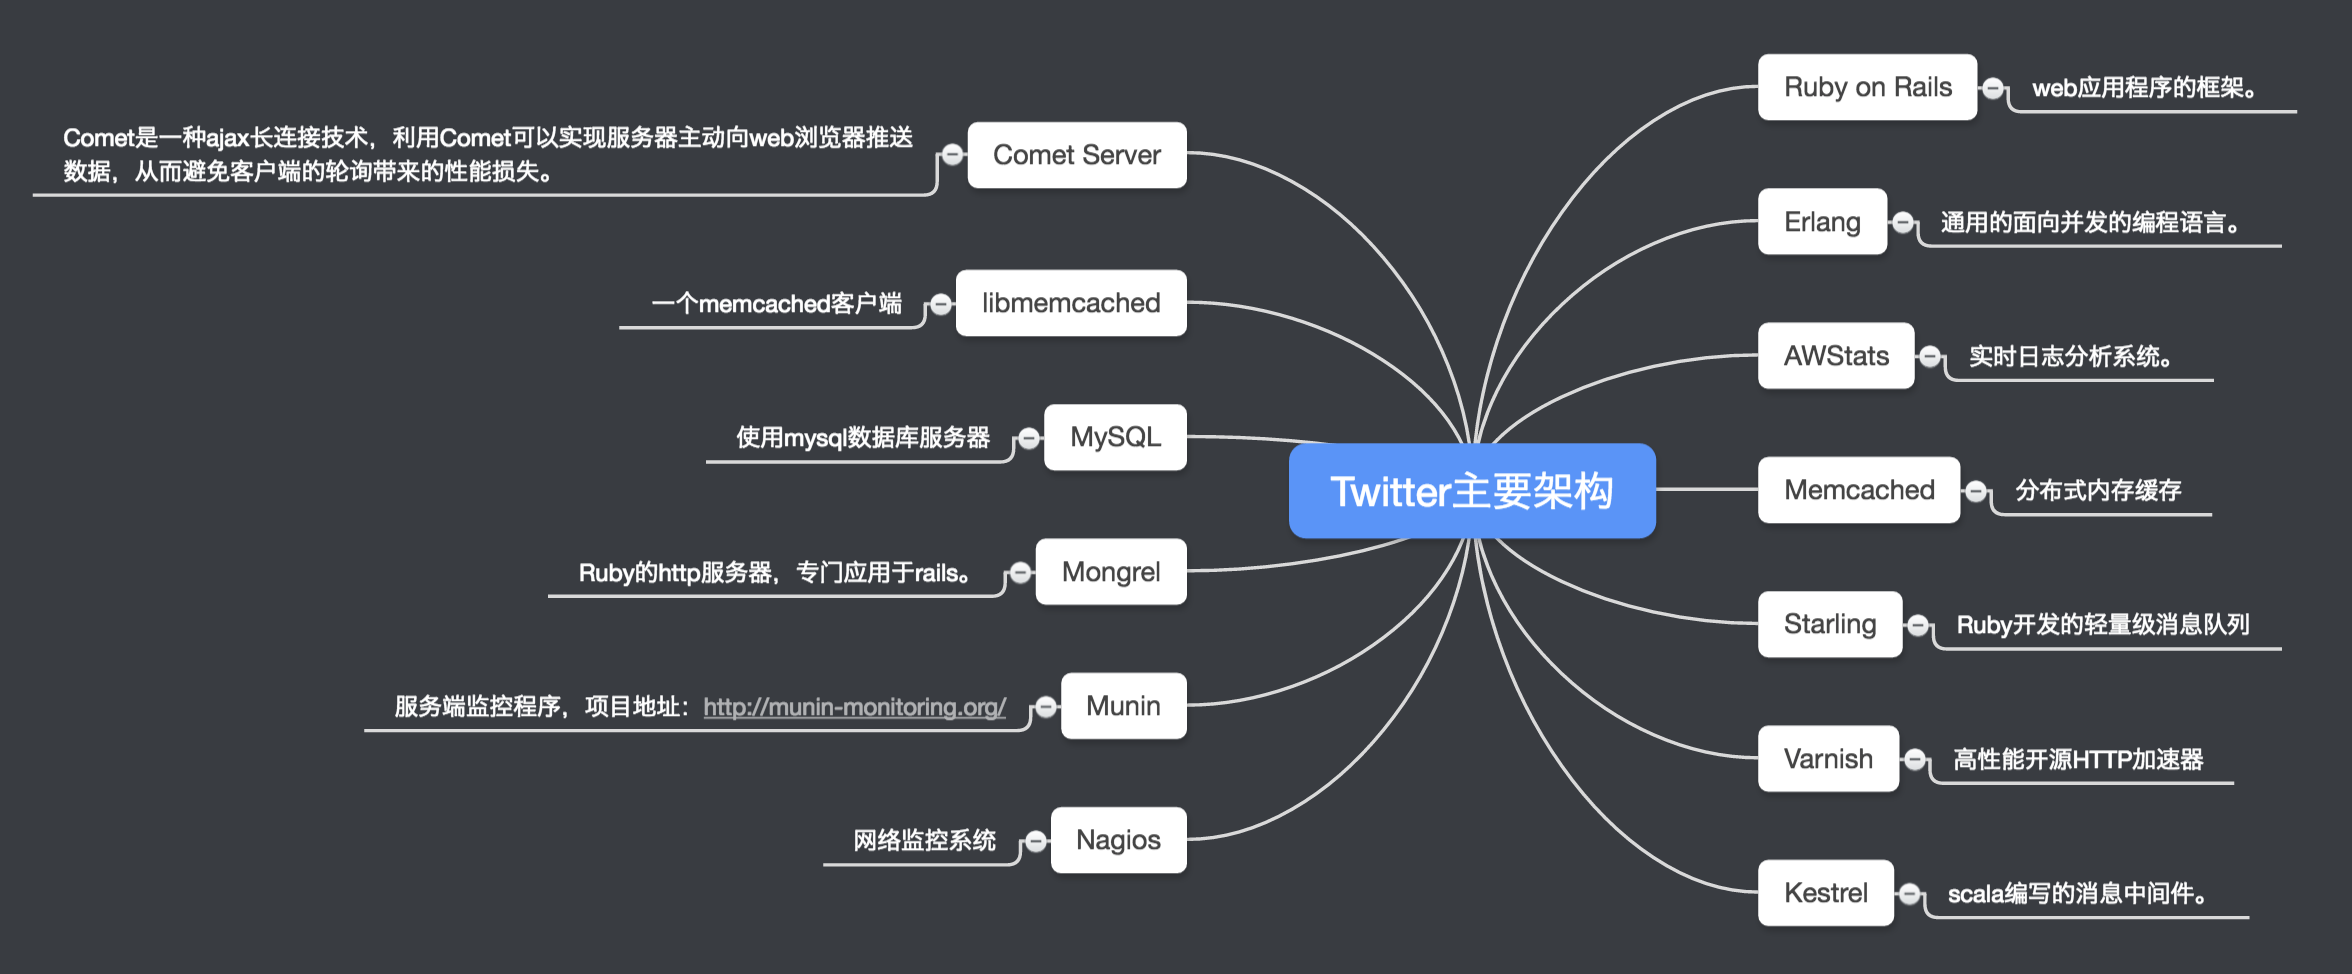
- twitter每月有180万独立访问用户数,并且75%的流量来自twitter.com以外的网站。
- 每天通过API有30亿次请求
- 每天平均产生5500次tweet,37%活跃用户为手机用户,约60%的tweet来自第三方的应用。

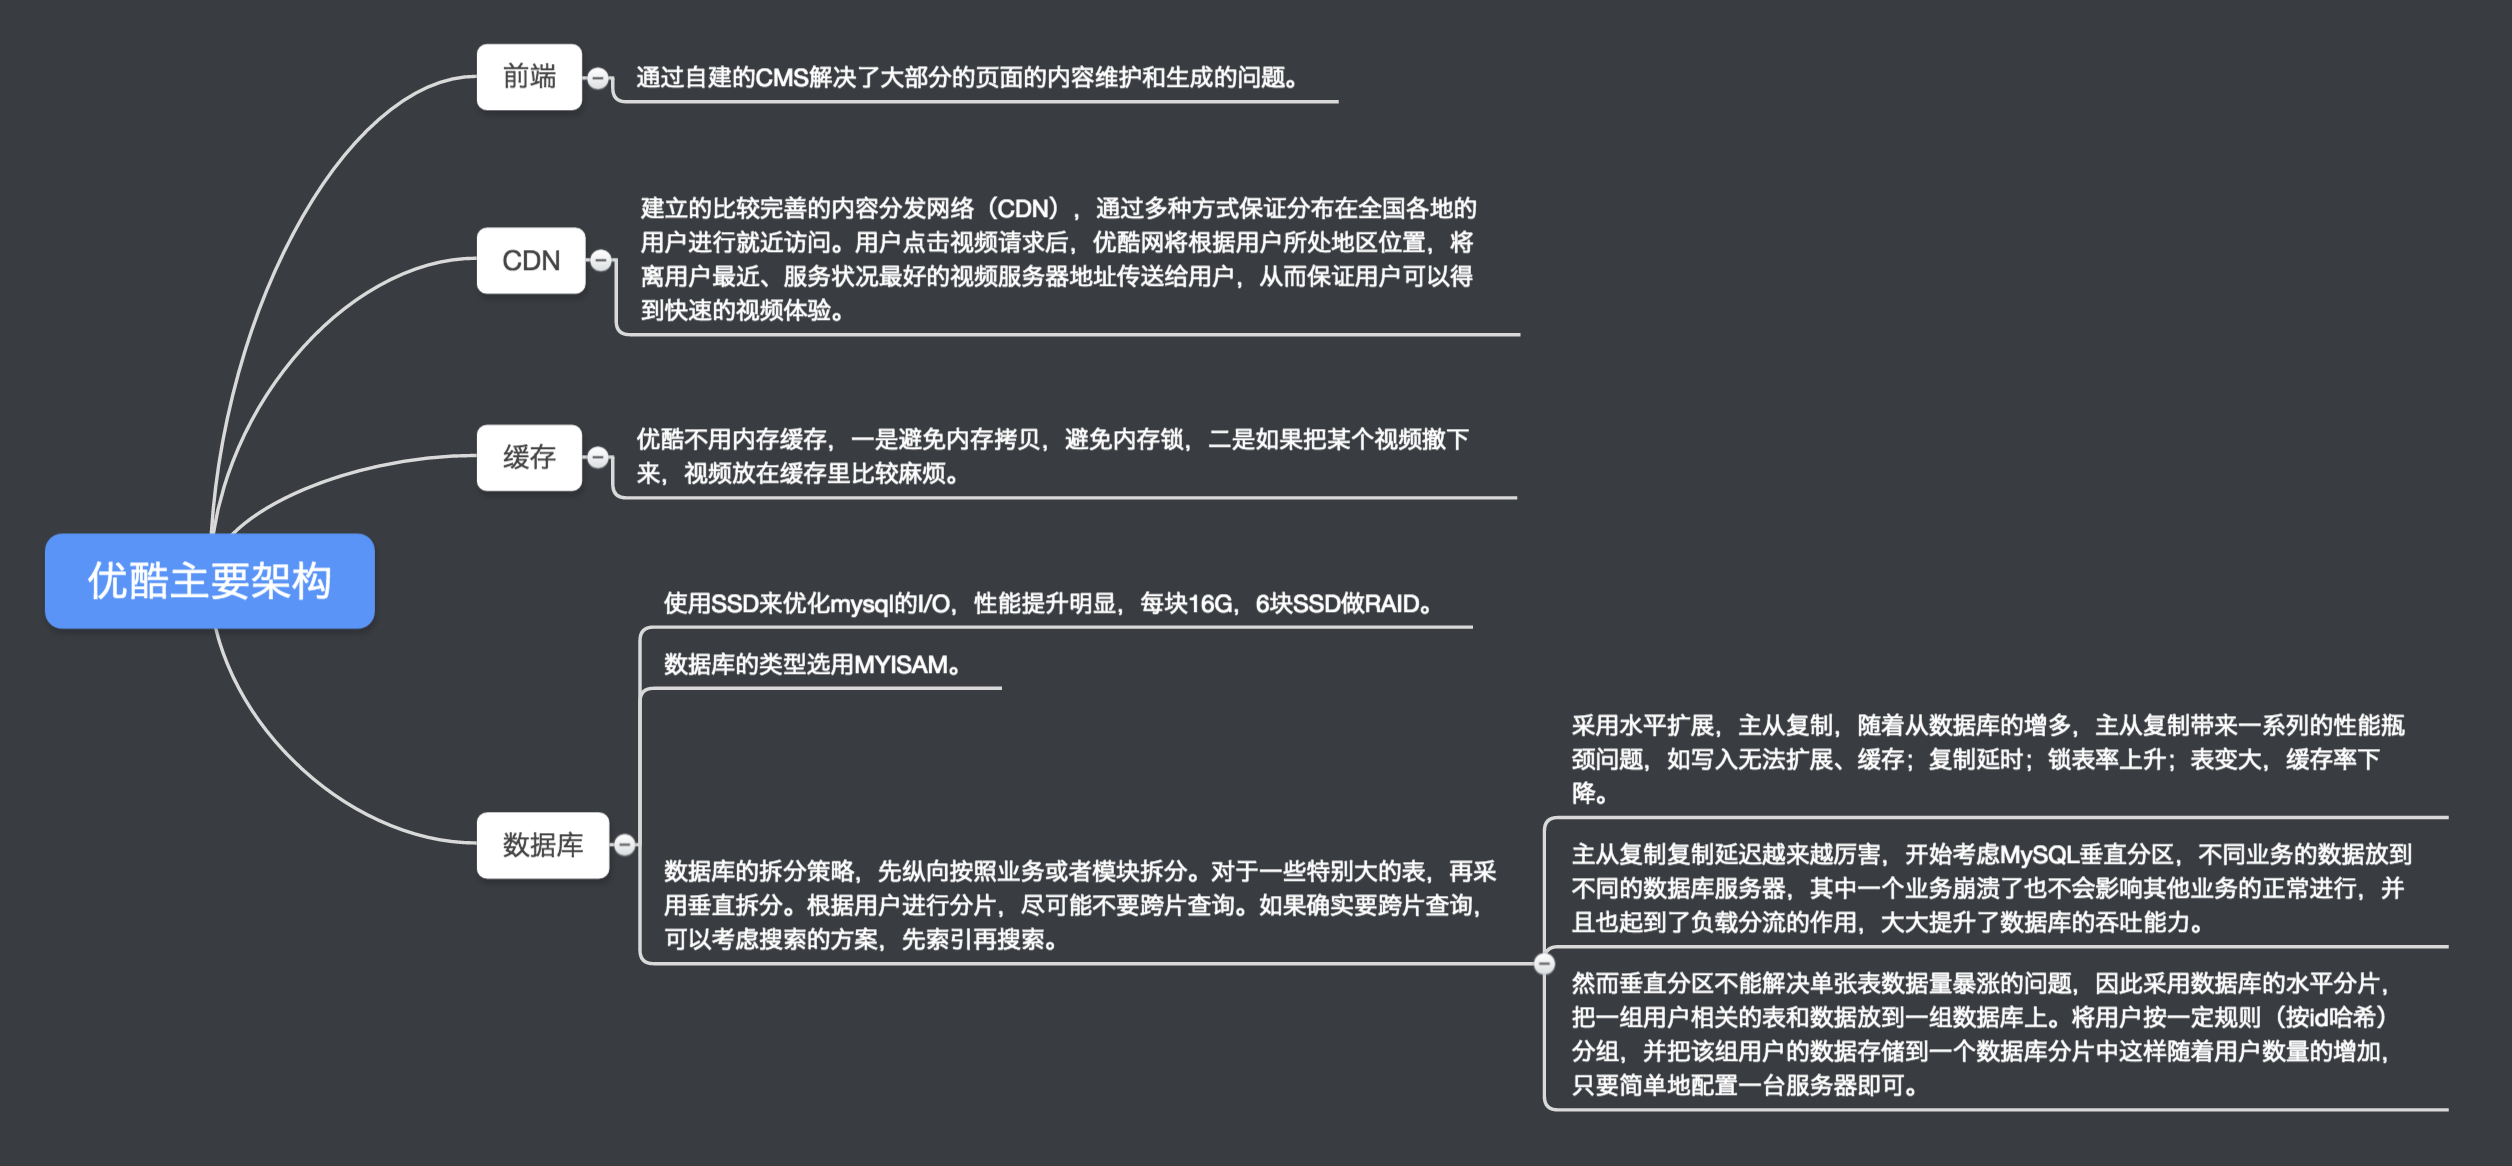
- 日均独立访问人数(uv)达到了8900万(2010年数据)
- 日均访问量(pv)达到了17亿,凭借这一数据成为google榜单中国内视频网站排名最高的厂商(2010年数据)
- 1000多台服务器(2007年数据)
2017-6-6&6-8/大型网站架构总结的更多相关文章
- Drupal与大型网站架构(译)- Large-Scale Web Site Infrastructure and Drupal
Drupal与大型网站架构(译)- Large-Scale Web Site Infrastructure and Drupal Linuxjournal 网站经典文章翻译,原文地址: Large-S ...
- 《大型网站系统与JAVA中间件实践》读书笔记-大型网站架构演进
大型网站架构演进 大型网站是一种很常见的分布式系统,除了海量数据和高并发的访问量,本身业务和系统也复杂. 大型网站的架构演进 我们现在常用的大型网站都是从小网站一步一步发展起来的,这个过程中会 有一些 ...
- Java程序员的职业发展道路 附:大型网站 -- 架构技能图谱(Java版)
职业发展道路基本有3条: 第一条路线(技术专精): 初级Java开发---中级--高级---项目主管--Java项目经理---网站架构师----资深专家 第二条路线(技术转产品):初级Java开发-- ...
- 各大型网站架构分析收集-原网址http://blog.csdn.net/lovingprince/article/details/3379710
1. PlentyOfFish 网站架构学习http://www.dbanotes.net/arch/plentyoffish_arch.html 采取 Windows 技术路线的 Web 2.0 站 ...
- 大型网站架构之JAVA中间件
中间件就是在大型网站中,帮助各子模块间实现互相访问,消息共享或统一访问等功能的软件产品.常见的有: 远程服务框架中间件:主要解决各子模块之间互相访问的问题. 消息队列中间件:主要解决各子模之间消息共享 ...
- 大型网站架构演进(6)使用NoSQL和搜索引擎
随着网站业务越来越复杂,对数据存储和检索的需求也越来越复杂,网站需要采用一些非关系型数据库技术(即NoSQL)和非数据库查询技术如搜索引擎.NoSQL数据库一般使用MongoDb,搜索引擎一般使用El ...
- 大型网站架构演化(八)——使用NoSQL和搜索引擎
随着网站业务越来越复杂,对数据存储和检索的需求也越来越复杂,网站需要采用一些非关系数据库技术如NoSQL和非数据库查询技术如搜索引擎,如图. NoSQL和搜索引擎都是源自互联网的技术手段,对可伸缩的分 ...
- 大型网站架构演化(六)——使用反向代理和CDN加速网站响应
随着网站业务不断发展,用户规模越来越大,由于中国复杂的网络环境,不同地区的用户访问网站时,速度差别也极大.有研究表明,网站访问延迟和用户流失率正相关,网站访问越慢,用户越容易失去耐心而离开.为了提供更 ...
- 大型网站技术架构(四)--核心架构要素 开启mac上印象笔记的代码块 大型网站技术架构(三)--架构模式 JDK8 stream toMap() java.lang.IllegalStateException: Duplicate key异常解决(key重复)
大型网站技术架构(四)--核心架构要素 作者:13GitHub:https://github.com/ZHENFENG13版权声明:本文为原创文章,未经允许不得转载.此篇已收录至<大型网站技 ...
随机推荐
- pgAdmin的数据恢复
DOC 本地添加server 1.设置备份.恢复的exe路径.一般在pgAdmin的安装路径下可以找到 2.恢复restore,备份backup
- java泛型的作用和好处
转载于:https://blog.csdn.net/u012760183/article/details/52092692 之前参加面试的时候遇到面试官问泛型的作用,只是说了大概自己的理解, 在此转载 ...
- java.lang.OutOfMemoryError:GC overhead limit exceeded
在调测程序时报java.lang.OutOfMemoryError:GC overhead limit exceeded 错误 错误原因:在用程序进行数据切割时报了该错误.由于在本地执行数据切割测试的 ...
- 17秋 SDN课程 第二次上机作业
1.控制器floodlight所示可视化图形拓扑的截图,及主机拓扑连通性检测截图 拓扑 连通性 2.利用字符界面下发流表,使得'h1'和'h2' ping 不通 流表截图 连通性 3.利用字符界面下发 ...
- Wordpress搭建
Install Environment apt install apache2 php mysql-server apt install php-mysql php-fpm Config mysql ...
- 中国地区免费注册bitcointalk论坛教程
bitcointalk论坛是著名的老牌比特币论坛,中本聪当年也在这里和各路大神探讨.但现在国家的高墙禁止网民访问. 你可能会用一个国外的代理工具来看贴,看贴确实可以,但是如果想注册,注册完后就会发现帐 ...
- 使用python读取yaml文件
在做APP测试时,通常需要把参数存到一个字典变量中,这时可以将参数写入yaml文件中,再读取出来. 新建yaml文件(android_caps.yaml),文件内容为: platformName: A ...
- aar的使用(module或者library)
引入: 1. android studio正常的module引用aar文件需要配置如下: ① 在module的build.gradle的android节点下 repositories { flatDi ...
- 学习笔记29—Linux基础
一.简单命令: 1.进入文件夹heyi目录:cd ./heyi 2.查看该目录下内容:ls 二.linux压缩和解压缩命令大全 tar命令 解包:tar zxvf FileName.tar 打包:ta ...
- cocos2dx lua 绑定之一:自动绑定自定义类中的函数
cococs2dx 3.13.1 + vs2013 + win10 1.首先定义C++类Student 在cocos2d-x\cocos文件夹下新建一个user_define的文件夹放置两个文件. 注 ...