
Python学习笔记(五十)爬虫的自我修养(三)爬取漂亮妹纸图
import random

import urllib

from urllib import request

import os

#########################################################

# 参数设置

wsp = 'DouziOOXX'

# 打开连接

def url_open(url):

    req = urllib.request.Request(url)

    req.add_header('User-Agent',

                   'Mozilla/5.0 (Windows NT 6.1; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/60.0.3112.78 Safari/537.36')

    response = urllib.request.urlopen(req)

    html = response.read()

    # print(url)

    return html

def get_page(url):

    # 打开链接

    html = url_open(url).decode('utf-8')

    # 查找 current-comment-page

    a = html.find('current-comment-page') + 23

    b = html.find(']', a)   # 从a开始,找到第一个 ], 返回索引

    return html[a:b]

def find_imgs(url):

    html = url_open(url).decode('utf-8')

    img_addrs = []

    a = html.find('img src=')

    while a != -1:

        b = html.find('.jpg', a, a + 255)

        if b != -1:   # 找到一个 jpg

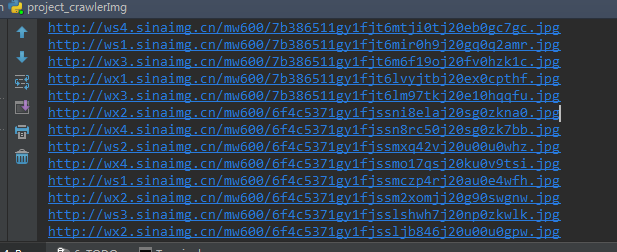
            img_addrs.append(html[a+9 : b+4])  # 加入列表

        else:         # 到不到, 移动b的位置

            b = a + 9

        a = html.find('img src=', b)  # 在b之后开始,再找img src

    # for each in img_addrs:

    #     print(each)

    return img_addrs

def save_imgs(folder, img_addrs):

    for each in img_addrs:

        filename = each.split('/')[-1]

        # print('http:' + each)

        with open(filename, 'wb') as f:

            img = url_open('http:' + each)

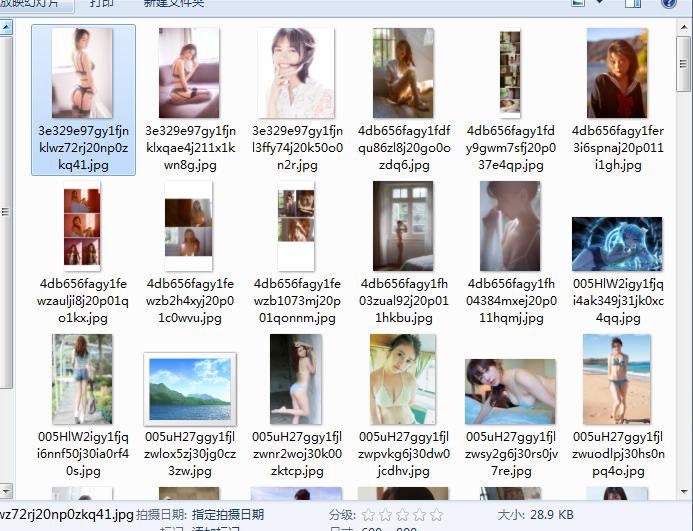
            f.write(img)

def download_mm(folder = wsp, pages = 10):

    os.mkdir(folder)

    # 切换到工作目录

    os.chdir(folder)

    url = "http://jandan.net/ooxx/"

    # 获得页面的地址

    page_num = int(get_page(url))

    for i in range(pages):

        page_num -= i

        # 打开这个地址

        page_url = url + "page-" + str(page_num)

        # 获取图片地址, 保存为一个列表

        img_addrs = find_imgs(page_url)

        # 保存到图片到指定文件夹

        save_imgs(folder, img_addrs)

if __name__=='__main__':

    download_mm()
Python学习笔记(五十)爬虫的自我修养(三)爬取漂亮妹纸图的更多相关文章
- Python学习笔记(十四)
Python学习笔记(十四): Json and Pickle模块 shelve模块 1. Json and Pickle模块 之前我们学习过用eval内置方法可以将一个字符串转成python对象,不 ...
- Python学习笔记(十)
Python学习笔记(十): 装饰器的应用 列表生成式 生成器 迭代器 模块:time,random 1. 装饰器的应用-登陆练习 login_status = False # 定义登陆状态 def ...
- Python学习笔记(十五):类基础
以Mark Lutz著的<Python学习手册>为教程,每天花1个小时左右时间学习,争取两周完成. --- 写在前面的话 2013-7-24 23:59 学习笔记 1,Python中的大多 ...
- Python学习笔记(十四):模块高级
以Mark Lutz著的<Python学习手册>为教程,每天花1个小时左右时间学习,争取两周完成. --- 写在前面的话 2013-7-23 21:30 学习笔记 1,包导入是把计算机上的 ...
- Python学习笔记:利用爬虫自动保存图片
兴趣才是第一生产驱动力. Part 1 起先,源于对某些网站图片浏览只能一张一张的翻页,心生不满.某夜,冒出一个想法,为什么我不能利用爬虫技术把想看的图片给爬下来,然后在本地看个够. 由此经过一番初尝 ...
- Python学习笔记第二十五周(Django补充)
1.render_to_reponse() 不同于render,render_to_response()不用包含request,直接写template中文件 2.locals() 如果views文件中 ...
- python学习笔记-(十五)RabbitMQ队列
rabbitMQ是消息队列:想想之前的我们学过队列queue:threading queue(线程queue,多个线程之间进行数据交互).进程queue(父进程与子进程进行交互或者同属于同一父进程下的 ...
- Python学习笔记第十五周
目录: 一.CSS补充 1.position 2.overflow 3.hover 4.background 二.JavaScript 三.DOM 主要内容: 一.CSS补充 1.position 可 ...
- Python 学习笔记(十五)Python类拓展(二)方法
方法 绑定方法和非绑定方法 绑定方法和非绑定方法在创建时没有任何区别,同一方法,既可以为绑定方法,也可以为非绑定方法,一切不同都只在调用时的手法上有所区别. 绑定方法即该方法绑定类的一个实例上,必须将 ...
随机推荐
- mysql You can't specify target table 'xxx' for update in FROM clause
含义:您不能在子句中为更新指定目标表'xxx'. 错误描述:删除语句中直接含select,如下: DELETE FROM meriadianannotation WHERE SeriesID IN ( ...
- CodeForces 483B 二分答案
题目: B. Friends and Presents time limit per test 1 second memory limit per test 256 megabytes input s ...
- 今目标登录时报网络错误E110
今目标登录的时候报错了,错误代码:E110不论怎么修改都修复不了,百度相关资料也没有,只能联系客服. 经过好久终于联系上了客服,客服给出的解决方案是修改:Enternet选项: 第一步:打开,控制面板 ...
- jQuery的2把利器
<!-- $是一个函数,首先是给window添加$,然后该值是一个函数,函数返回的值是对象.1. jQuery核心函数 * 简称: jQuery函数($/jQuery) * jQuery库向外直 ...
- 6/2 sprint2 看板和燃尽图的更新
- Mac下Git的基础操作
目前最火的版本控制软件是Git了吧,今天简单梳理一下Mac下Git的基础操作~~ 一.什么是Git Git是一个分布式代码管理工具,用于敏捷的处理或大或小的项目,类似的工具还有svn. 基于Git的快 ...
- jetty之maven配置
<!-- jetty 插件配置 --><plugin> <groupId>org.mortbay.jetty</groupId> <artifac ...
- 安装php先行库
libmcrypt libconv mhash ./configure --prefix=/usr/local mcrypt 安装完成后在当前目录还要 /sbin/ldconfig ./config ...
- PHP中与类有关的运算符
与类有关的运算符: new, instanceof:判断一个“变量”(对象,数据),是否是某个类的“实例”: 示意如下: class A {} class B {} class C extend ...
- Linux服务器开启tomcat的gc日志
压力测试,为了能监控长期对gc的变化的情况,那么就需要在tomcat中进行配置相关的gc输入日志,以便后续来对gc中进行分析 工具 :linux+tomcat 1.进入到了tomcat的bin的目录下 ...