
Flink学习(二) 应用场景和架构模型
实时计算最好的时代
在过去的十年里,面向数据时代的实时计算技术接踵而至。从我们最初认识的 Storm,再到 Spark 的异军突起,迅速占领了整个实时计算领域。直到 2019 年 1 月底,阿里巴巴内部版本 Flink 正式开源!一石激起千层浪,Flink 开源的消息立刻刷爆朋友圈,整个大数据计算领域一直以来由 Spark 独领风骚,瞬间成为两强争霸的时代。
Apache Flink(以下简称 Flink)以其先进的设计理念、强大的计算能力备受关注,如何将 Flink 快速应用在生产环境中,更好的与现有的大数据生态技术完美结合,充分挖掘数据的潜力,成为了众多开发者面临的难题。
Flink 实际应用场景
Flink 自从 2019 年初开源以来,迅速成为大数据实时计算领域炙手可热的技术框架。作为 Flink 的主要贡献者阿里巴巴率先将其在全集团进行推广使用,另外由于 Flink 天然的流式特性,更为领先的架构设计,使得 Flink 一出现便在各大公司掀起了应用的热潮。
阿里巴巴、腾讯、百度、字节跳动、滴滴、华为等众多互联网公司已经将 Flink 作为未来技术重要的发力点,迫切地在各自公司内部进行技术升级和推广使用。同时,Flink 已经成为 Apache 基金会和 GitHub 社区最为活跃的项目之一。
我们来看看 Flink 支持的众多应用场景。
实时数据计算
如果你对大数据技术有所接触,那么下面的这些需求场景你应该并不陌生:
阿里巴巴每年双十一都会直播,实时监控大屏是如何做到的?
公司想看一下大促中销量最好的商品 TOP5?
我是公司的运维,希望能实时接收到服务器的负载情况?
......

我们可以看到,数据计算场景需要从原始数据中提取有价值的信息和指标,比如上面提到的实时销售额、销量的 TOP5,以及服务器的负载情况等。
传统的分析方式通常是利用批查询,或将事件(生产上一般是消息)记录下来并基于此形成有限数据集(表)构建应用来完成。为了得到最新数据的计算结果,必须先将它们写入表中并重新执行 SQL 查询,然后将结果写入存储系统比如 MySQL 中,再生成报告。
Apache Flink 同时支持流式及批量分析应用,这就是我们所说的批流一体。Flink 在上述的需求场景中承担了数据的实时采集、实时计算和下游发送。
实时数据仓库和 ETL
ETL(Extract-Transform-Load)的目的是将业务系统的数据经过抽取、清洗转换之后加载到数据仓库的过程。

传统的离线数据仓库将业务数据集中进行存储后,以固定的计算逻辑定时进行 ETL 和其他建模后产出报表等应用。离线数据仓库主要是构建 T+1 的离线数据,通过定时任务每天拉取增量数据,然后创建各个业务相关的主题维度数据,对外提供 T+1 的数据查询接口。
上图展示了离线数据仓库 ETL 和实时数据仓库的差异,可以看到离线数据仓库的计算和数据的实时性均较差。数据本身的价值随着时间的流逝会逐步减弱,因此数据发生后必须尽快的达到用户的手中,实时数仓的构建需求也应运而生。
实时数据仓库的建设是“数据智能 BI”必不可少的一环,也是大规模数据应用中必然面临的挑战。
Flink 在实时数仓和实时 ETL 中有天然的优势:
状态管理,实时数仓里面会进行很多的聚合计算,这些都需要对于状态进行访问和管理,Flink 支持强大的状态管理;
丰富的 API,Flink 提供极为丰富的多层次 API,包括 Stream API、Table API 及 Flink SQL;
生态完善,实时数仓的用途广泛,Flink 支持多种存储(HDFS、ES 等);
批流一体,Flink 已经在将流计算和批计算的 API 进行统一。

事件驱动型应用
你是否有这样的需求:
我们公司有几万台服务器,希望能从服务器上报的消息中将 CPU、MEM、LOAD 信息分离出来做分析,然后触发自定义的规则进行报警?
我是公司的安全运维人员,希望能从每天的访问日志中识别爬虫程序,并且进行 IP 限制?
......
事件驱动型应用是一类具有状态的应用,它从一个或多个事件流提取数据,并根据到来的事件触发计算、状态更新或其他外部动作。
在传统架构中,我们需要读写远程事务型数据库,比如 MySQL。在事件驱动应用中数据和计算不会分离,应用只需访问本地(内存或磁盘)即可获取数据,所以具有更高的吞吐和更低的延迟。

Flink 的以下特性完美的支持了事件驱动型应用:
高效的状态管理,Flink 自带的 State Backend 可以很好的存储中间状态信息;
丰富的窗口支持,Flink 支持包含滚动窗口、滑动窗口及其他窗口;
多种时间语义,Flink 支持 Event Time、Processing Time 和 Ingestion Time;
不同级别的容错,Flink 支持 At Least Once 或 Exactly Once 容错级别。
Apache Flink 从底层支持了针对多种不同场景的应用开发。
Flink 的主要特性包括:批流一体、Exactly-Once、强大的状态管理等。
同时,Flink 还支持运行在包括 YARN、 Mesos、Kubernetes 在内的多种资源管理框架上。阿里巴巴已经率先将 Flink 在全集团进行推广使用,事实证明,Flink 已经可以扩展到数千核心,其状态可以达到 TB 级别,且仍能保持高吞吐、低延迟的特性。
因此,Flink 已经成为我们在实时计算的领域的第一选择。
Flink 的架构模型
Flink 的分层模型
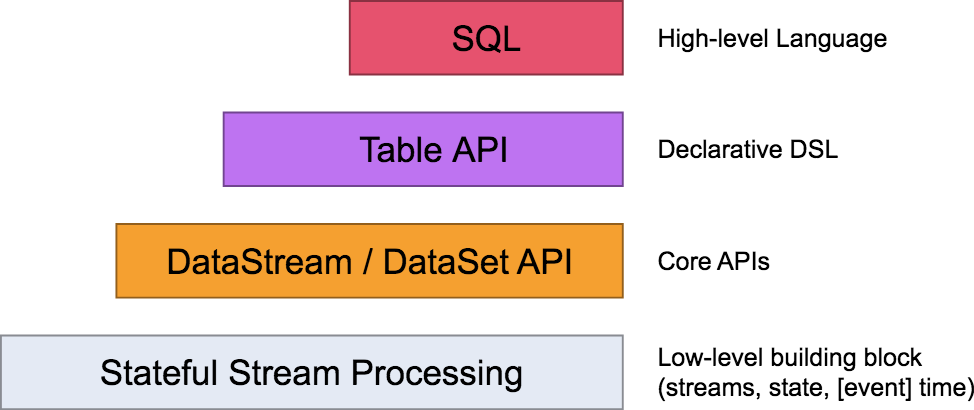
Flink 自身提供了不同级别的抽象来支持我们开发流式或者批量处理程序,上图描述了 Flink 支持的 4 种不同级别的抽象。
对于我们开发者来说,大多数应用程序不需要上图中的最低级别的 Low-level 抽象,而是针对 Core API 编程, 比如 DataStream API(有界/无界流)和 DataSet API (有界数据集)。这些流畅的 API 提供了用于数据处理的通用构建块,比如各种形式用户指定的转换、连接、聚合、窗口、状态等。
Table API 和 SQL 是 Flink 提供的更为高级的 API 操作,Flink SQL 是 Flink 实时计算为简化计算模型,降低用户使用实时计算门槛而设计的一套符合标准 SQL 语义的开发语言。
Flink 的数据流模型
Flink 程序的基础构建模块是流(Streams)与转换(Transformations),每一个数据流起始于一个或多个 Source,并终止于一个或多个 Sink。数据流类似于有向无环图(DAG)。
我们以一个最经典的 WordCount 计数程序举例:

在上图中,程序消费 Kafka 数据,这便是我们的 Source 部分。
然后经过 Map、Keyby、TimeWindow 等方法进行逻辑计算,该部分就是我们的 Transformation 转换部分,而其中的 Map、Keyby、TimeWindow 等方法被称为算子。通常,程序中的转换与数据流中的算子之间存在对应关系,有时一个转换可能包含多个转换算子。
最后,经过计算的数据会被写入到我们执行的文件中,这便是我们的 Sink 部分。
实际上面对复杂的生产环境,Flink 任务大都是并行进行和分布在各个计算节点上。在 Flink 任务执行期间,每一个数据流都会有多个分区,并且每个算子都有多个算子任务并行进行。算子子任务的数量是该特定算子的并行度(Parallelism),对并行度的设置是 Flink 任务进行调优的重要手段,我们会在后面的课程中详细讲解。
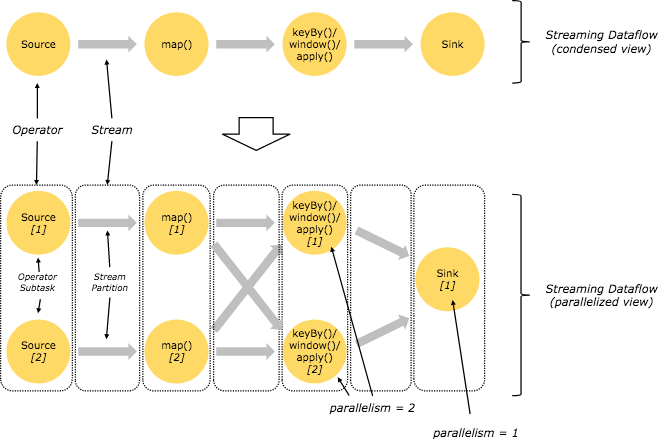
从上图中可以看到,在上面的 map 和 keyBy/window 之间,以及 keyBy/window 和 Sink 之间,因为并行度的差异,数据流都进行了重新分配。
Flink 中的窗口和时间
窗口和时间是 Flink 中的核心概念之一。在实际成产环境中,对数据流上的聚合需要由窗口来划定范围,比如“计算过去的 5 分钟”或者“最后 100 个元素的和”。
Flink 支持了多种窗口模型比如滚动窗口(Tumbling Window)、滑动窗口(Sliding Window)及会话窗口(Session Window)等。
下图展示了 Flink 支持的多种窗口模型:

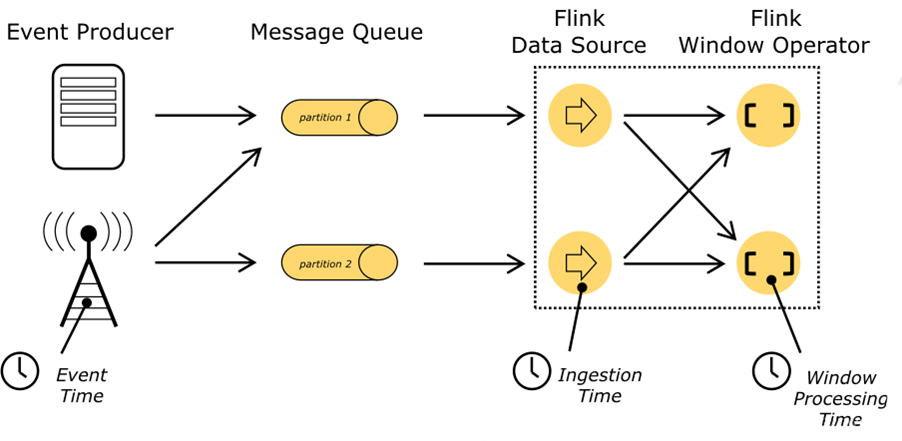
同时,Flink 支持了事件时间(Event Time)、摄取时间(Ingestion Time)和处理时间(Processing Time)三种时间语义用来满足实际生产中对于时间的特殊需求。
其他
此外,Flink 自身还支持了有状态的算子操作、容错机制、Checkpoint、Exactly-once 语义等更多高级特性,来支持用户在不同的业务场景中的需求。
Flink学习(二) 应用场景和架构模型的更多相关文章
- 第01讲:Flink 的应用场景和架构模型
你好,欢迎来到第 01 课时,本课时我们主要介绍 Flink 的应用场景和架构模型. 实时计算最好的时代 在过去的十年里,面向数据时代的实时计算技术接踵而至.从我们最初认识的 Storm,再到 Spa ...
- 深入学习Hive应用场景及架构原理
Hive背景介绍 Hive最初是Facebook为了满足对海量社交网络数据的管理和机器学习的需求而产生和发展的.互联网现在进入了大数据时代,大数据是现在互联网的趋势,而hadoop就是大数据时代里的核 ...
- HBase学习笔记(四)—— 架构模型
在逻辑上,HBase 的数据模型同关系型数据库很类似,数据存储在一张表中,有行有列. 但从 HBase 的底层物理存储结构(K-V)来看,HBase 更像是一个 multi-dimensional m ...
- hadoop学习二:hadoop基本架构与shell操作
1.hadoop1.0与hadoop2.0的区别:
- python 3+djanjo 2.0.7简单学习(二)--创建数据库和模型
我们紧接上次,这里将建立数据库,创建第一个模型提示:这里我们不需要去一直启动,django会在我们ctrl+s的时候自动刷新并启动服务,很方便吧 1.数据库配置 现在,打开 vote_mysite/ ...
- Struts2框架学习(二)——访问流程及架构
1.Struts2的执行流程 从客户端发送请求过来,先经过前端控制器(核心过滤器StrutsPrepareAndExecuteFilter)过滤器中执行一组拦截器(一组拦截器就会完成部分功能代码),拦 ...
- (转)MyBatis框架的学习(二)——MyBatis架构与入门
http://blog.csdn.net/yerenyuan_pku/article/details/71699515 MyBatis框架的架构 MyBatis框架的架构如下图: 下面作简要概述: S ...
- Flink的应用场景和架构
Flink的应用场景 Flink项目的理念就是:Flink是为分布式,高性能,随时可用以及准确的流处理应用程序打造的开源流处理框架.自2019年开源以来,迅速成为大数据实时计算领域炙手可热的技术框架. ...
- 【深度学习篇】--神经网络中的池化层和CNN架构模型
一.前述 本文讲述池化层和经典神经网络中的架构模型. 二.池化Pooling 1.目标 降采样subsample,shrink(浓缩),减少计算负荷,减少内存使用,参数数量减少(也可防止过拟合)减少输 ...
- 基于TensorFlow Object Detection API进行迁移学习训练自己的人脸检测模型(二)
前言 已完成数据预处理工作,具体参照: 基于TensorFlow Object Detection API进行迁移学习训练自己的人脸检测模型(一) 设置配置文件 新建目录face_faster_rcn ...
随机推荐
- OpenEuler安装MongoDB并配置访问密码
1. 下载MongoDB.安装 wget https://fastdl.mongodb.org/linux/mongodb-linux-x86_64-rhel80-4.4.18.tgz tar zxv ...
- Fake JSON Server
Fake JSON Server https://github.com/ttu/dotnet-fake-json-server Fake JSON Server 是 Fake REST API,可以作 ...
- 【MyBatis】学习笔记06:各种查询所返回数据的数据类型
[Mybatis]学习笔记01:连接数据库,实现增删改 [Mybatis]学习笔记02:实现简单的查 [MyBatis]学习笔记03:配置文件进一步解读(非常重要) [MyBatis]学习笔记04:配 ...
- kubectl get deploy
for i in `kubectl get deployments.apps -n nvpc-apps-02|grep -v NAME|awk '{print $1}'`; do kubectl ge ...
- 2019.12.10笔记——Spring Boot热部署的使用和实现自己的热部署(类加载器相关)
Spring Boot热部署 热部署的使用 引入依赖 <!-- spring boot热部署的依赖 --> <dependency> <groupId>org.sp ...
- 在openEuler RISC-V上无痛部署Solidity
近几年区块链很火,随着各国政府对加密技术的监管政策不断变化和BTC的暴涨,越来越多人对这项去中心化的技术充满着期待.这次我用openEuler 24.09 RISC-V的远程机器尝试编译了Solidi ...
- opencv只在bin目录下编译dll,在lib目录下编译lib,在bin目录下不编译测试程序的各种exe
penCV是一个开源的计算机视觉库,它提供了多种编程语言的接口.如果你只想编译出DLL和Lib库文件,而不编译EXE(可执行文件),这通常是因为你想要进行某种形式的动态链接或者库的分发,而不关心EXE ...
- 命名空间“System.Web.UI.Design”中不存在类型或命名空间名称“ControlDesigner”
命名空间"System.Web.UI.Design"中不存在类型或命名空间名称"ControlDesigner" 命名空间"System.Web.UI ...
- 陌陌技术分享:陌陌IM在后端KV缓存架构上的技术实践
本文由冀浩东分享,原题"单核QPS近6000S,陌陌基于OceanBase的持久化缓存探索与实践",为了阅读便利,本文进行了排版和内容优化等. 1.引言 挚文集团于 2011 年 ...
- 即时通讯技术文集(第15期):IM跨平台和社交软件红包技术 [共19篇]
为了更好地分类阅读 52im.net 总计1000多篇精编文章,我将在每周三推送新的一期技术文集,本次是第15 期. [- 1 -] IM跨平台技术学习(一):快速了解新一代跨平台桌面技术--Elec ...