
mapreduce统计单词
源代码:
WordCountMapper.java:
package cn.idcast.mapreduce;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Mapper;

import java.io.IOException;

/*

 四个泛型解释:

 KEYIN:k1的类型

 VALUEIN:v1的类型

 KEYOUT:k2的类型

 VALUEOUT:v2的类型

*/

public class WordCountMapper extends Mapper<LongWritable,Text,Text,LongWritable> {

    //map方法就是将K1和v1 转为k2和v2

    /*

        参数:

           key    :k1    行偏移量

           value  :v1    每一行的文本数据

           context:表示上下文对象

     */

    /*

       如何将K1和v1 转为k2和v2

       k1         v1

       0    hello,world,hadoop

       15   hdfs,hive,hello

      -------------------------

       k2         v2

       hello      1

       world      1

       hdfs       1

       hadoop     1

       hello      1

     */

    @Override

    protected void map(LongWritable key, Text value, Context context) throws IOException, InterruptedException {

        Text text = new Text();

        LongWritable longWritable = new LongWritable();

        //1:将一行的文本数据进行拆分

        String[] split = value.toString().split(",");

        //2:遍历数组,组装k2和v2

        for (String word : split) {

            //3:将k2和v2写入上下文中

            text.set(word);

            longWritable.set(1);

            context.write(text,longWritable);

        }

    }

}
WordCountReducer.java:
package cn.idcast.mapreduce;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Reducer;

import java.io.IOException;

/*

 四个泛型解释:

 KEYIN:k2的类型

 VALUEIN:v2的类型

 KEYOUT:k3的类型

 VALUEOUT:v3的类型

*/

public class WordCountReducer extends Reducer<Text,LongWritable,Text,LongWritable> {

    //reduce方法作用:将新的k2和v2转为 k3和v3,将k3 和v3写入上下文中

    /*

        参数:

           key    :新k2

           values :集合 新v2

           context:表示上下文对象

          -----------------------

           如何将新的k2和v2转为k3和v3

           新 k2         v2

             hello       <1,1,1>

             world       <1,1>

             hadoop      <1>

         -------------------------

              k3         v3

             hello        3

             world        2

             hadoop       1

     */

    @Override

    protected void reduce(Text key, Iterable<LongWritable> values, Context context) throws IOException, InterruptedException {

        long count=0;

        //1:遍历集合,将集合中的数字相加,得到v3

        for (LongWritable value : values) {

            count +=value.get();

        }

        //2:将k3和v3写入上下文中

        context.write(key,new LongWritable(count));

    }

}
JobMain.java:
package cn.idcast.mapreduce;

import org.apache.hadoop.conf.Configuration;

import org.apache.hadoop.conf.Configured;

import org.apache.hadoop.fs.FileSystem;

import org.apache.hadoop.fs.Path;

import org.apache.hadoop.io.LongWritable;

import org.apache.hadoop.io.Text;

import org.apache.hadoop.mapreduce.Job;

import org.apache.hadoop.mapreduce.lib.input.TextInputFormat;

import org.apache.hadoop.mapreduce.lib.output.TextOutputFormat;

import org.apache.hadoop.util.Tool;

import org.apache.hadoop.util.ToolRunner;

import java.net.URI;

public class JobMain extends Configured implements Tool {

    //该方法用于指定一个job任务

    @Override

    public int run(String[] args) throws Exception {

        //1:创建一个job任务对象

        Job job = Job.getInstance(super.getConf(), "wordcount");

        //如果打包运行出错,则需要加该配置

        job.setJarByClass(JobMain.class);

        //2:配置job任务对象(八个步骤)

        //第一步:指定文件的读取方式和读取路径

        job.setInputFormatClass(TextInputFormat.class);

        TextInputFormat.addInputPath(job,new Path("hdfs://node1:8020/wordcount"));

        //第二部:指定Map阶段的处理方式

        job.setMapperClass(WordCountMapper.class);

        //设置Map阶段k2的类型

        job.setMapOutputKeyClass(Text.class);

        //设置Map阶段v2的类型

        job.setMapOutputValueClass(LongWritable.class);

        //第三,四,五,六 采用默认方式,现阶段不做处理

        //第七步:指定Reduce阶段的处理方式和数据类型

        job.setReducerClass(WordCountReducer.class);

        //设置k3的类型

        job.setOutputKeyClass(Text.class);

        //设置v3的类型

        job.setOutputValueClass(LongWritable.class);

        //第八步:设置输出类型

        job.setOutputFormatClass(TextOutputFormat.class);

        //设置输出的路径

        Path path=new Path("hdfs://node1:8020/wordcount_out");

        TextOutputFormat.setOutputPath(job,path);

        //获取FileSystem

        FileSystem fs = FileSystem.get(new URI("hdfs://node1:8020/wordcount_out"),new Configuration());

        //判断目录是否存在

        if (fs.exists(path)) {

            fs.delete(path, true);

            System.out.println("存在此输出路径,已删除!!!");

        }

        //等待任务结束

        boolean bl = job.waitForCompletion(true);

        return bl ? 0:1;

    }

    public static void main(String[] args) throws Exception {

        Configuration configuration = new Configuration();

        //启动job任务

        int run = ToolRunner.run(configuration, new JobMain(), args);

        System.exit(run);

    }

}
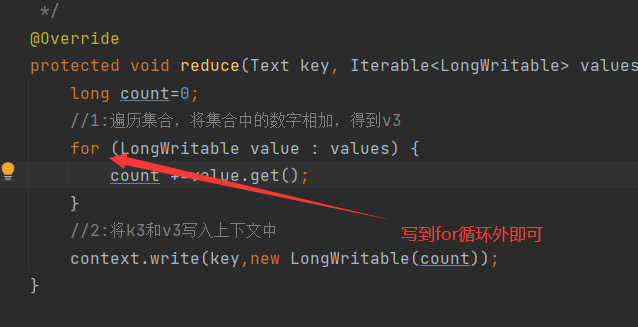
记录一个小错误:

发现key重复输出了,原因:reduce步骤中把提交上下文放到循环里去了,导致每加一次就输出一次
mapreduce统计单词的更多相关文章
- 第六章 第一个Linux驱动程序:统计单词个数
现在进入了实战阶段,使用统计单词个数的实例让我们了解开发和测试Linux驱动程序的完整过程.第一个Linux驱动程序是统计单词个数. 这个Linux驱动程序没有访问硬件,而是利用设备文件作为介质与应用 ...
- 第六章第一个linux个程序:统计单词个数
第六章第一个linux个程序:统计单词个数 从本章就开始激动人心的时刻——实战,去慢慢揭开linux神秘的面纱.本章的实例是统计一片文章或者一段文字中的单词个数. 第 1 步:建立 Linu x 驱 ...
- NOIP200107统计单词个数
NOIP200107统计单词个数 难度级别: A: 编程语言:不限:运行时间限制:1000ms: 运行空间限制:51200KB: 代码长度限制:2000000B 试题描述 给出一个长度不超过200的由 ...
- python 统计单词个数
根据一篇英文文章统计其中单词出现最多的10个单词. # -*- coding: utf-8 -*-import urllib2import refrom collections import Coun ...
- NOIP2001 统计单词个数
题三 统计单词个数(30分) 问题描述 给出一个长度不超过200的由小写英文字母组成的字母串(约定;该字串以每行20个字母的方式输入,且保证每行一定为20个).要求将此字母串分成k份(1<k&l ...
- Codevs_1040_[NOIP2001]_统计单词个数_(划分型动态规划)
描述 http://codevs.cn/problem/1040/ 与Codevs_1017_乘积最大很像,都是划分型dp. 给出一个字符串和几个单词,要求将字符串划分成k段,在每一段中求共有多少单词 ...
- 电子科大POJ "统计单词"
统计单词 Time Limit: 3000/1000MS (Java/Others) Memory Limit: 65535/65535KB (Java/Others) C-sources: ...
- 统计单词频率--map
问题描述: 输入一个单词列表,每行一个单词,统计单词出现的频率 思路: 主要是使用c++中的map容器.map实质上是一个二叉查找树,可以做到插入.删除.查询,平均查询时间在O(logn).n为map ...
- 洛谷 P1308 统计单词数【字符串+模拟】
P1308 统计单词数 题目描述 一般的文本编辑器都有查找单词的功能,该功能可以快速定位特定单词在文章中的位置,有的还能统计出特定单词在文章中出现的次数. 现在,请你编程实现这一功能,具体要求是:给定 ...
随机推荐
- Pycharm新建Python项目
关于新建项目时配置项目环境(最好是每个项目单独的虚拟Python环境): Python为什么要使用虚拟环境-Python虚拟环境的安装和配置-virtualenv Pycharm创建Python项目 ...
- laravel7 权限菜单设置简易升缩
1:数据库填写数据,pid=0为顶级菜单,pid=对应的id为顶级菜单的子菜单 2:laravel7 创建模型并链接对应的表名 <?php namespace App\models; use I ...
- tp5怎么防sql注入 xss跨站脚本攻击
在 application/config.php 中有个配置选项 框架默认没有设置任何过滤规则,你可以是配置文件中设置全局的过滤规则 则会调用这些函数 自动过滤 // 默认全局过滤方法 用逗号分隔多个 ...
- mac电脑sublime text3安装pretty json插件
因http://packagecontrol.io/地址被墙无法实现自动安装,导致sublime Text3安装插件非常麻烦,总是出现There Are No Packages Available F ...
- spring boot使用注解进行模糊查询
spring boot中mybatis使用注解进行模糊查询@Select("select * from dept where dname like CONCAT('%',#{dname},' ...
- Python函数-5 生成器
生成器有时候,序列或集合内的元素的个数非常巨大,如果全制造出来并放入内存,对计算机的压力是非常大的.比如,假设需要获取一个10**20次方如此巨大的数据序列,把每一个数都生成出来,并放在一个内存的列表 ...
- 阿里一面,说说你对Mysql死锁的理解
又到了金三银四的时候,大家都按耐不住内心的躁动,我在这里给大家分享下之前面试中遇到的一个知识点(死锁问题),如有不足,欢迎大佬们指点指点. 1.什么是死锁? 死锁指的是在两个或两个以上不同的进程或线程 ...
- django之model,crm操作
一.字段 AutoField(Field) - int自增列,必须填入参数 primary_key=True BigAutoField(AutoField) - bigint自增列,必须填入参数 pr ...
- CVE-2017-12635(Couchdb垂直权限绕过漏洞)
简介 Apache CouchDB是一个开源数据库,专注于易用性和成为"完全拥抱web的数据库".它是一个使用JSON作为存储格式,JavaScript作为查询语言,MapRedu ...
- [转载]Linux后门整理合集(脉搏推荐)
我在思考要不要联系下....都禁止转载了.... 简介 利用 Unix/Linux 自带的 Bash 和 Crond 实现远控功能,保持反弹上线到公网机器. 利用方法 先创建 /etc/xxxx 脚本 ...