
【深度学习 论文篇 02-1 】YOLOv1论文精读
原论文链接:https://gitee.com/shaoxuxu/DeepLearning_PaperNotes/blob/master/YOLOv1.pdf
笔记版论文链接:https://gitee.com/shaoxuxu/DeepLearning_PaperNotes/blob/master/YOLOv1-PaperNotes.pdf
你只需要看一次:统一的、实时的目标检测
1. 简介
(1)主要作者简介:
Joseph Redmon:YOLOv1、YOLOv2、YOLOv3、DarkNet深度学习框架。
Ross Girshick:人称RGB大神,主要论文有DPM、R-CNN、Fast R-CNN、Faster R-CNN、FPN、Mask R-CNN、RetinaNet、YOLOv1等。
Ali Farhadi:Joseph Redmon在华盛顿大学的导师。
(2)YOLOv1特点:
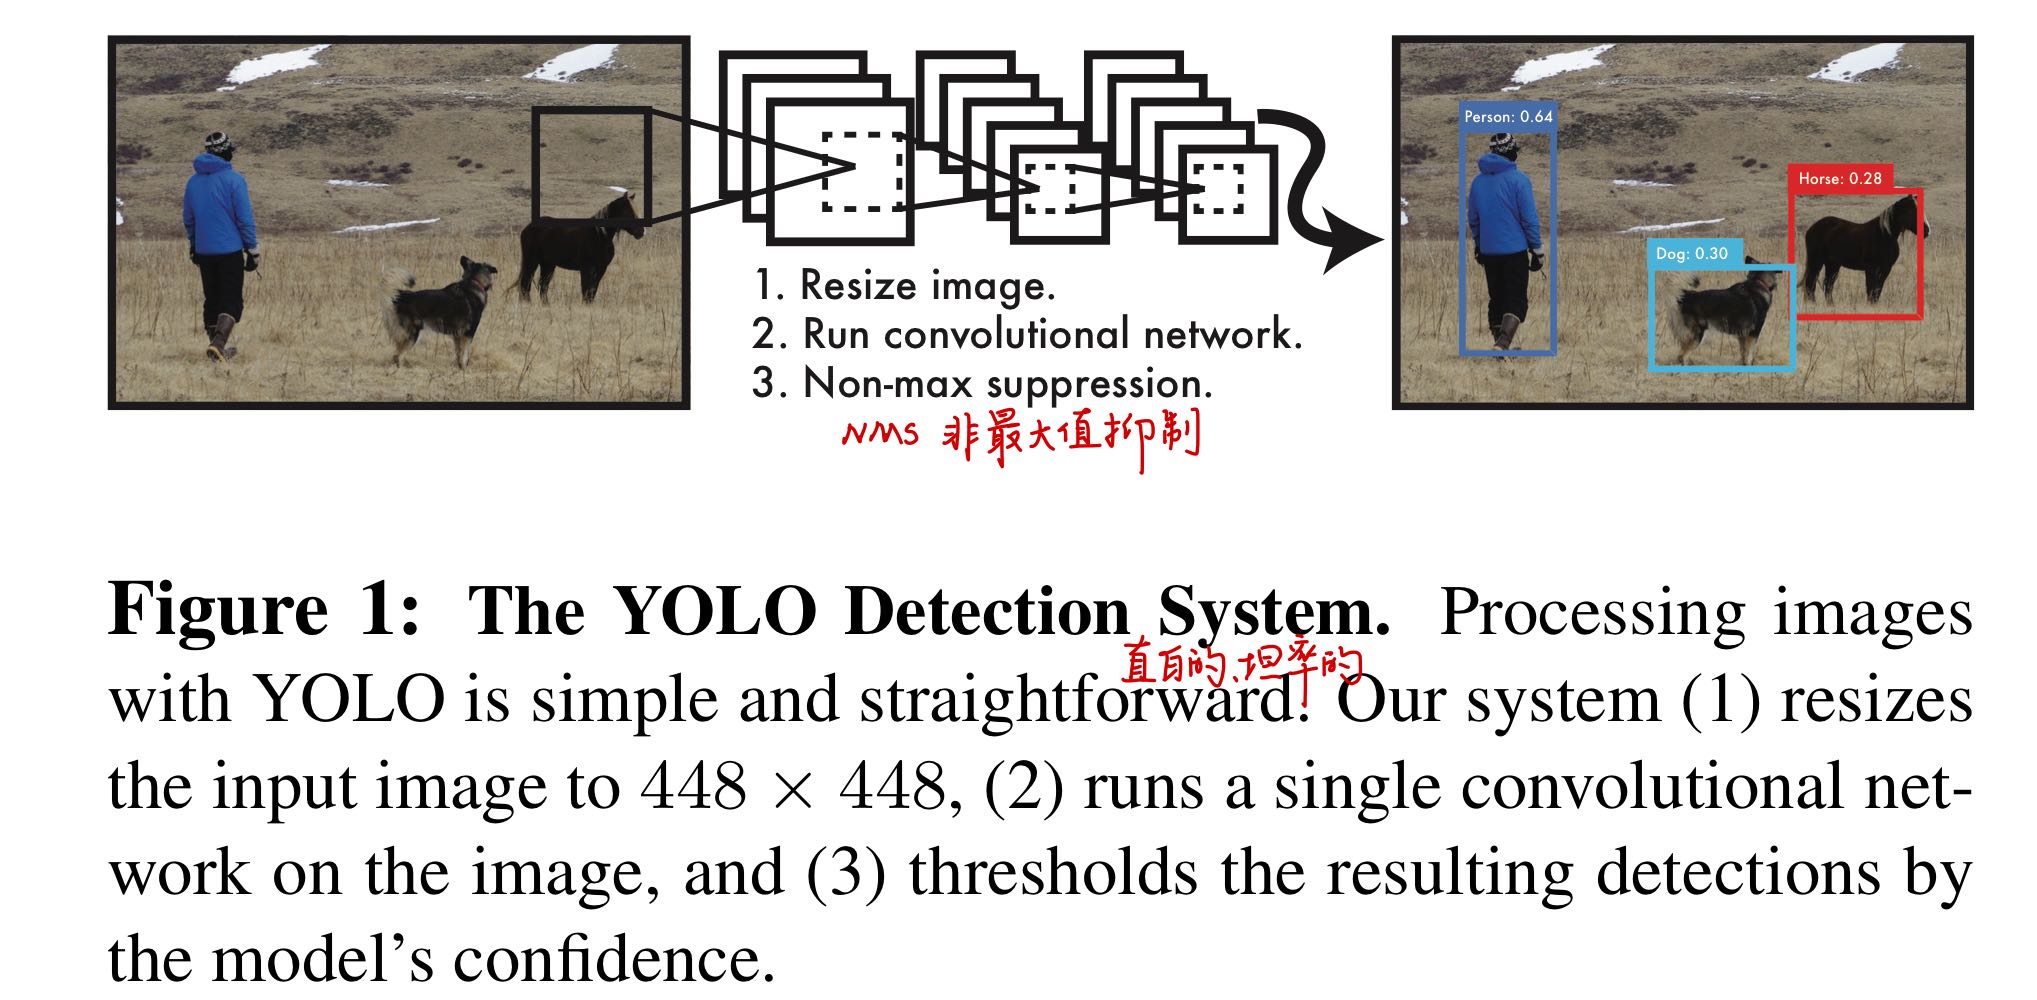
R-CNN、SPP-Net、Fast R-CNN,Faster R-CNN等都是two-stage目标检测器,即第一阶段生成潜在候选框(Region Proposal);第二阶段用CNN分类器逐一筛选每个候选框。这类网络虽然准确性较好,但速度太慢,很难达到实时检测(>30FPS)的需求。而YOLO属于one-stage(单阶段)目标检测器,可以直接端对端的优化检测性能,通常输入图像只需要经过一次前向预测就可回归得到类别和定位信息,且速度极快,能够很好地实现实时的目标检测(YOLO实时最准、Fast YOLO实时最快)。
2. 论文思想
2.1 算法流程

(1)将原图划分为S*S网格(grid cell);
(2)物体的中心点(也即Ground Truth人工标记框的中心点)落到哪个grid cell里, 就由该grid cell负责检测这个物体,且检测这个物体的bounding box由该grid cell生成;
(3)每个grid cell预测B个bounding box(每个bounding box由5个参数组成:4个坐标(x, y, w, h)和一个置信度confidence);
x, y 是bounding box中心点相对于所在grid cell左上角格点的坐标;
w, h 是bounding box相对于整幅图像的宽和高;
bounding box的confidence score定义如下:
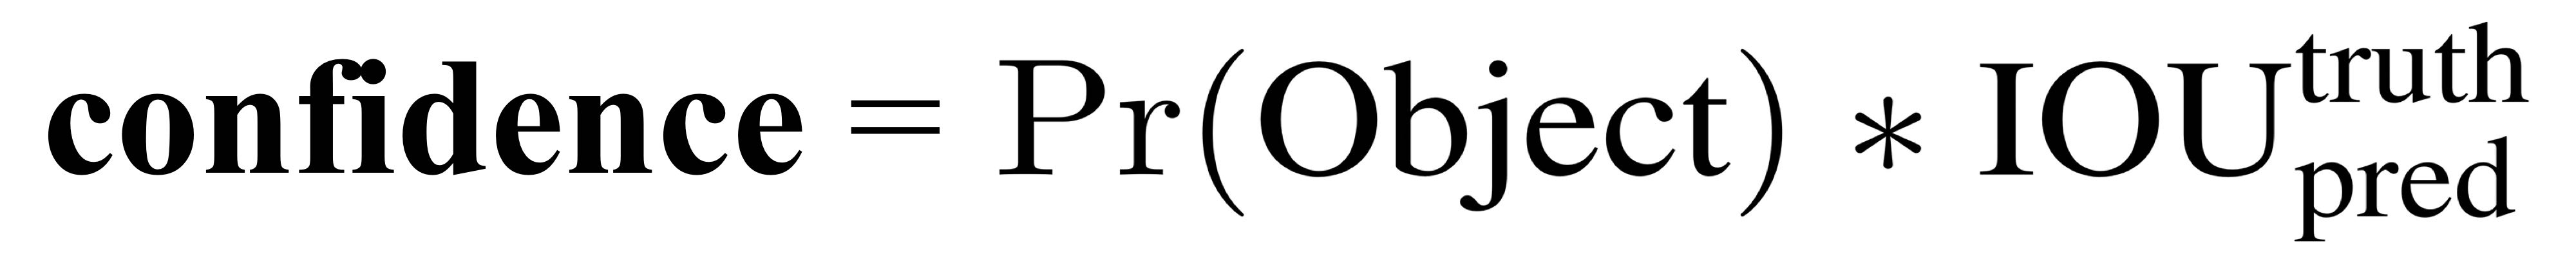
- Pr(Object):bounding box是否包含物体,包含为1不包含为0;
- IOU:Intersection Over Union,是指bounding box与ground truth的交并比,也就是预测框和真实标记框的交并比。
- 其乘积就是confidence score的标签值,对于负责预测的bounding box,Pr=1,这个标签值就相当于IOU。
- 注意上述的步骤是训练阶段,而在预测阶段直接回归得到confidence,不需要直接计算Pr和IOU,而是隐含地包含两者。
(4)B个bounding box中与Ground Truth框的IOU最大的bounding box负责检测这个物体;
(5)每个grid cell预测C个条件类别概率:Pr(Classi|Object) ,C表示目标检测的类别数,Pr(Classi|Object) 表示确认grid cell内有物体的前提下该物体是某类别的概率;
最终每个bounding box分类的confidence就是上述的Pr(Classi|Object)与(3)中bounding box置信度预测的乘积:
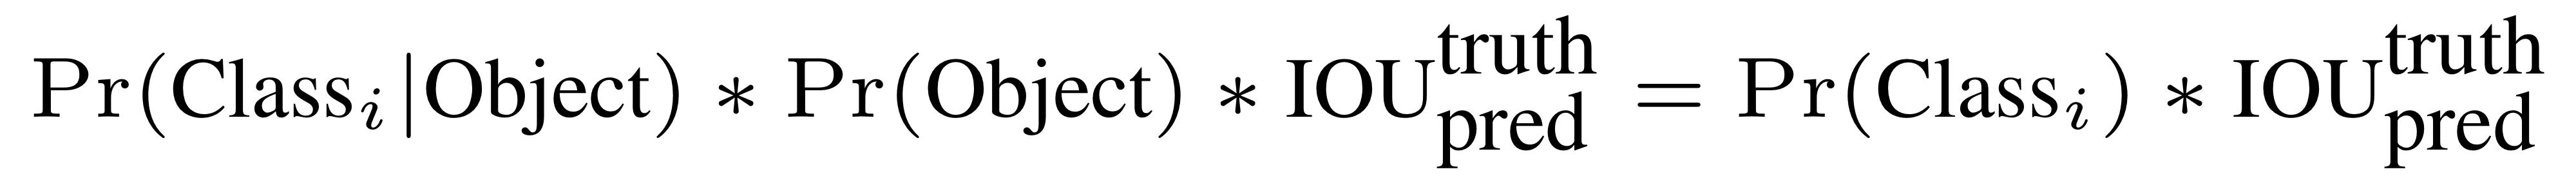
上式代表每个bounding box中第i个类别的概率,包含物体的分类精度和定位精度。
(6)训练阶段,就是不断迭代上述步骤,通过监督学习使得损失函数最小化的过程;而预测阶段,输入448*448*3的图像,只需经过一次神经网络,即可输出7*7*30的张量(包含定位和分类信息)。
2.2 网络结构
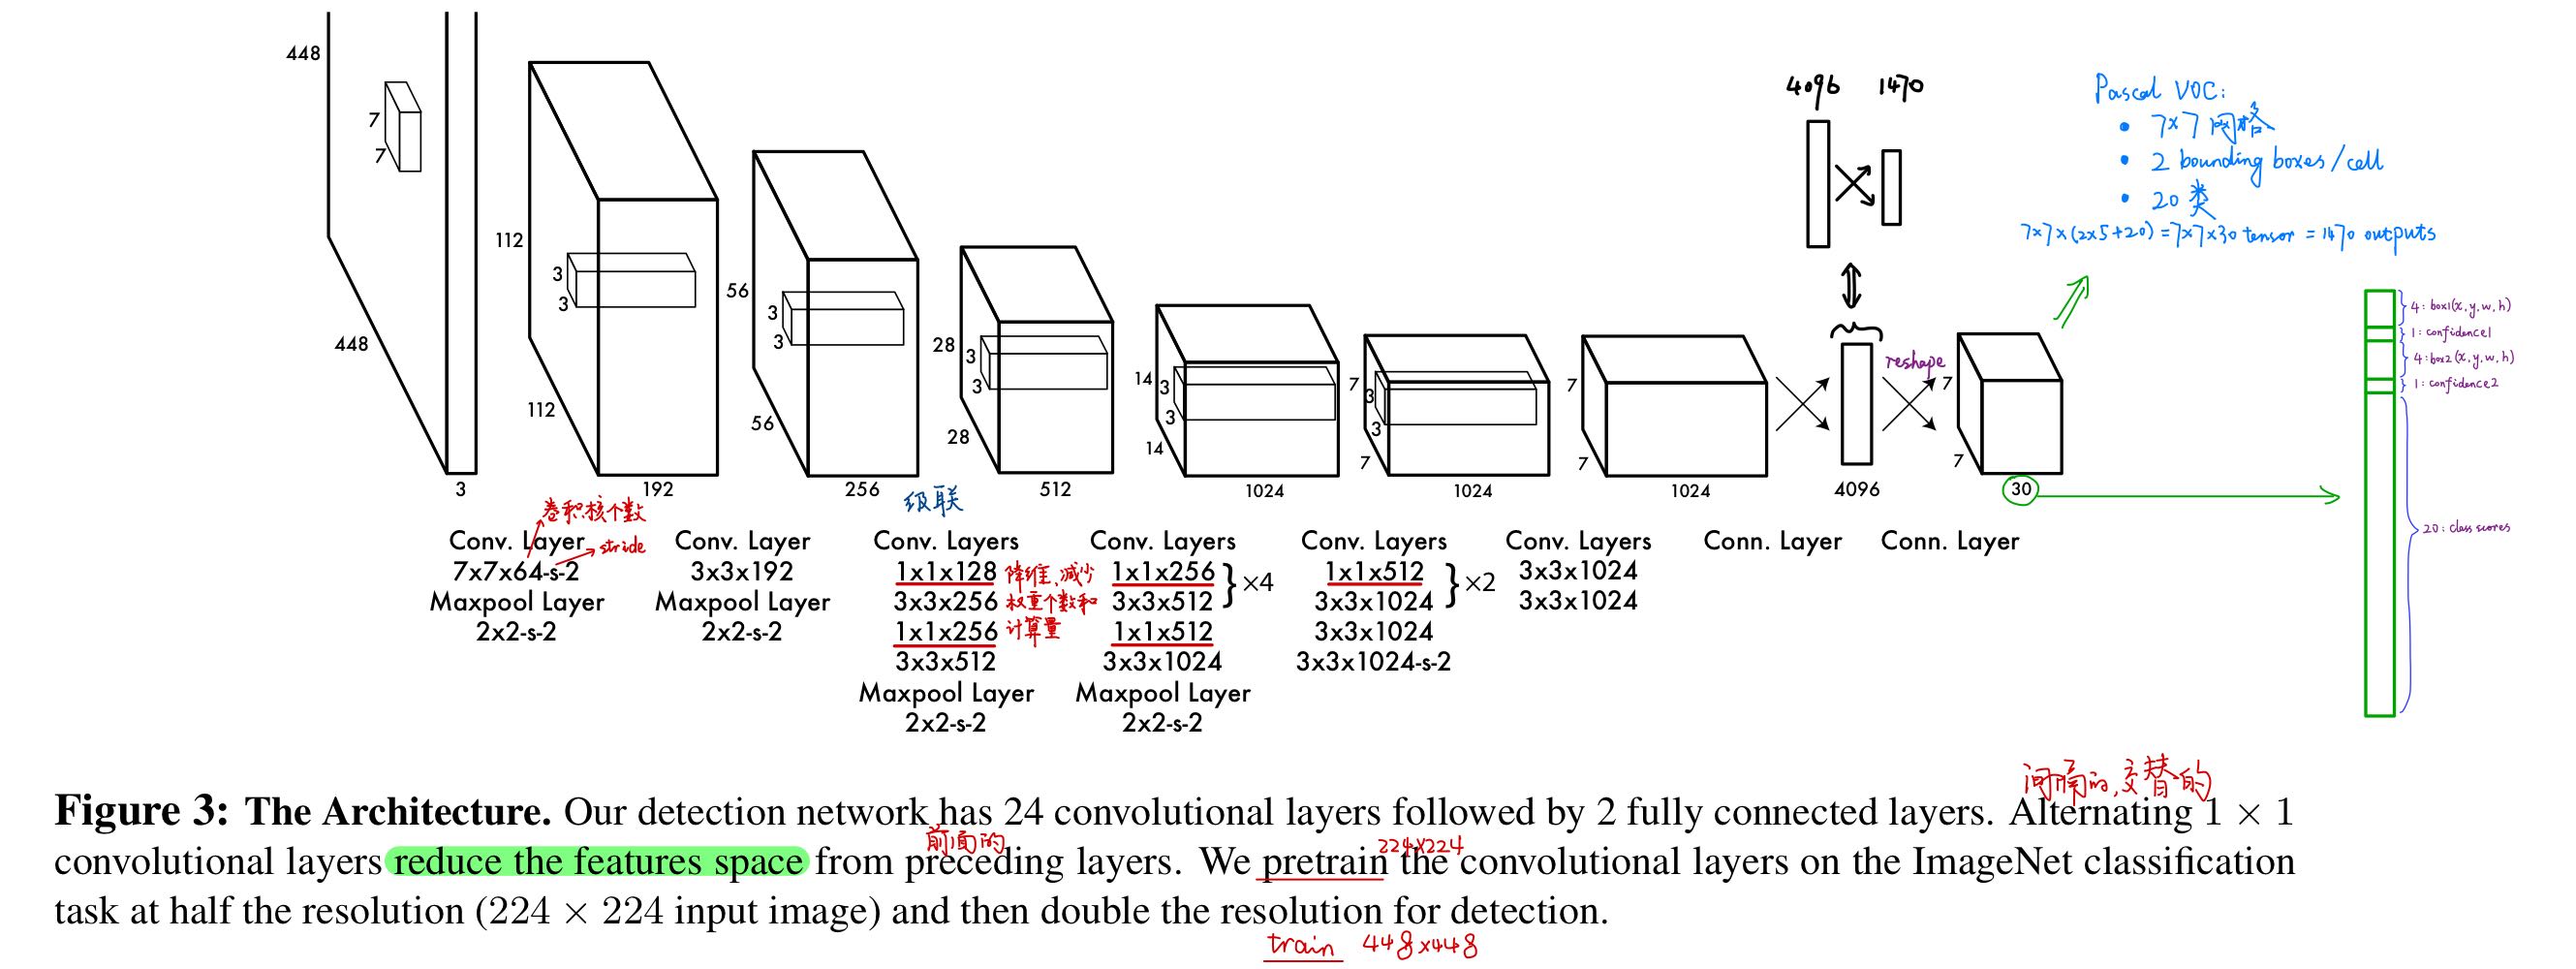
该网络模型由24个卷积层+2个全连接层构成。输入448*448*3的图像,输出7*7*30的张量。网络中的1*1卷积层,出自Network in network(NiN),在这里的作用是降维,减少权重个数和计算量。
Tips:CNN小知识补充
预训练:使用大型数据集预先训练模型的过程。常用预训练模型有VGG16/19、ResNet50等。
微调:将预训练过的模型作用于自己的数据集,并使参数适应自己数据集的过程。
卷积神经网络的核心是:
(1)浅层卷积层提取基础特征,比如边缘、轮廓等;
(2)深层卷积层提取抽象特征,比如整个脸型;
(3)全连接层根据特征组合进行评分分类。
预训练模型的特点就是:用大型数据集做训练,已经具备了提取浅层基础特征和深层抽象特征的能力。
2.3 预训练分类网络
在ImageNet 1000-class competition dataset上预训练了一个分类器,预训练网络使用图中前20个卷积 + 1个GAP(Global Average Pooling) + 1个全连接层,网络输入为224*224大小。
2.4 训练检测网络
(1)由于检测需要细粒度的图像信息,所以网络输入由预训练的224*224改为448*448;
(2)任少卿等人提出在预训练网络上增加卷积层和全连接层能够提升性能,所以训练网络改为上图所示:24个卷积层 + 2个全连接层;
(3)检测框的位置信息(x, y, w, h)都做了归一化处理;
x, y 是bounding box中心点相对于所在grid cell左上角格点的坐标;
w, h 是相对于整幅图像的宽和高。
(4)使用Leaky ReLU非线性激活函数;
θ(x) = x, x>0
θ(x) = 0.1x, otherwise
(5)使用sum-squared error损失函数;
(6)训练过程中采用变化的学习率;
最初的epoch,慢慢从10e-3升到10e-2(一上来就10e-2容易造成发散);
紧接着75个epoch,学习率设为10e-2;
再接下来30个epoch,学习率降为10e-3;
最后30个epoch,学习率将为10e-4。
(7)为了避免过拟合,使用dropout和数据增强,数据增强包括:随机缩放,20%全图大小的平移,调整HSV色彩空间。
2.5 损失函数(L2 Loss)

损失函数分五部分,第1、2项为坐标回归误差;第3、4项为Confidence(置信度)回归误差;第5项为类别预测误差,即分类误差。
(1)负责检测物体的bbox中心定位误差
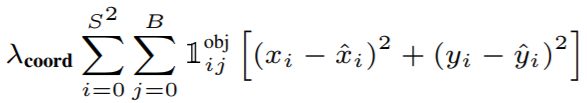
此处λcoord 取值为5,而(4)中λnoobj 取值为0.5,之所以如此设定,是因为图像中有很多grid cell是不包含物体的,这些grid cell中bbox的置信度都为0,这通常会压制或者说弱化那些含有包含物体的grid cell的梯度,导致模型不稳定,造成训练过早发散。所以设定λcoord = 5,λnoobj = 0.5,相当于加强bbox坐标预测损失(也就是定位误差),削弱不包含物体的bbox的置信度损失。
(2)负责检测物体的bbox宽高定位误差
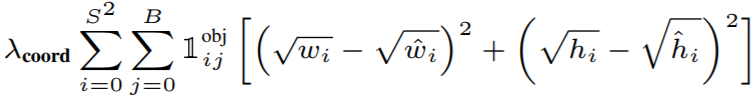
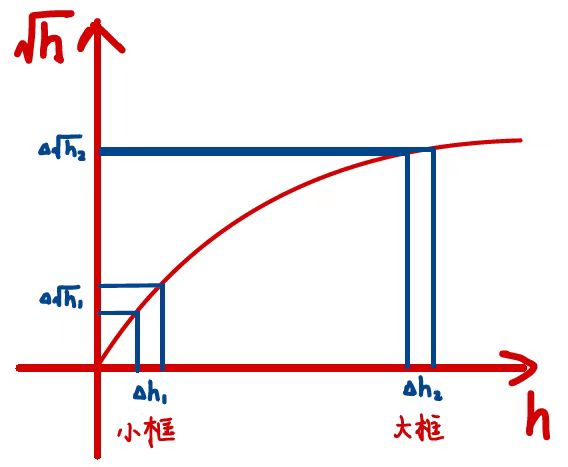
式中,使用宽和高的平方根来代替宽和高,是因为在小框里边小的偏差比在大框里边影响更大,如下图示:
(3)负责检测物体的bbox的confidence误差

(4)不负责检测物体的bbox的confidence误差
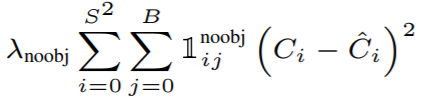
(5)负责检测物体的grid cell的分类误差
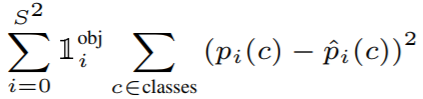
3. YOLOv1的缺陷
(1)小目标检测差强人意,由于空间的约束导致可预测的目标数量受限,每个grid cell只能预测一个目标,整幅图像最多预测7*7=49个目标;
(2)很难泛化到新的或不常见纵横比或形状的目标;
(3)预测框使用了相对较粗粒度的特征(由于存在很多下采样层),这导致其定位误差较高;
(4)小框里的小的误差比在大框里的影响更大。(这个在损失函数的第二项中有相应的优化措施,即用宽高的平方根来代替宽高。个人猜测可能并没有达到预期效果)
4. 其他一些检测器的特点
- DPM(Deformable parts models)
传统特征HOG、传统分类器SVM、滑动窗口方法、弹簧模型:子模型+主模型。
- R-CNN 使用region proposals代替sliding window apporoach
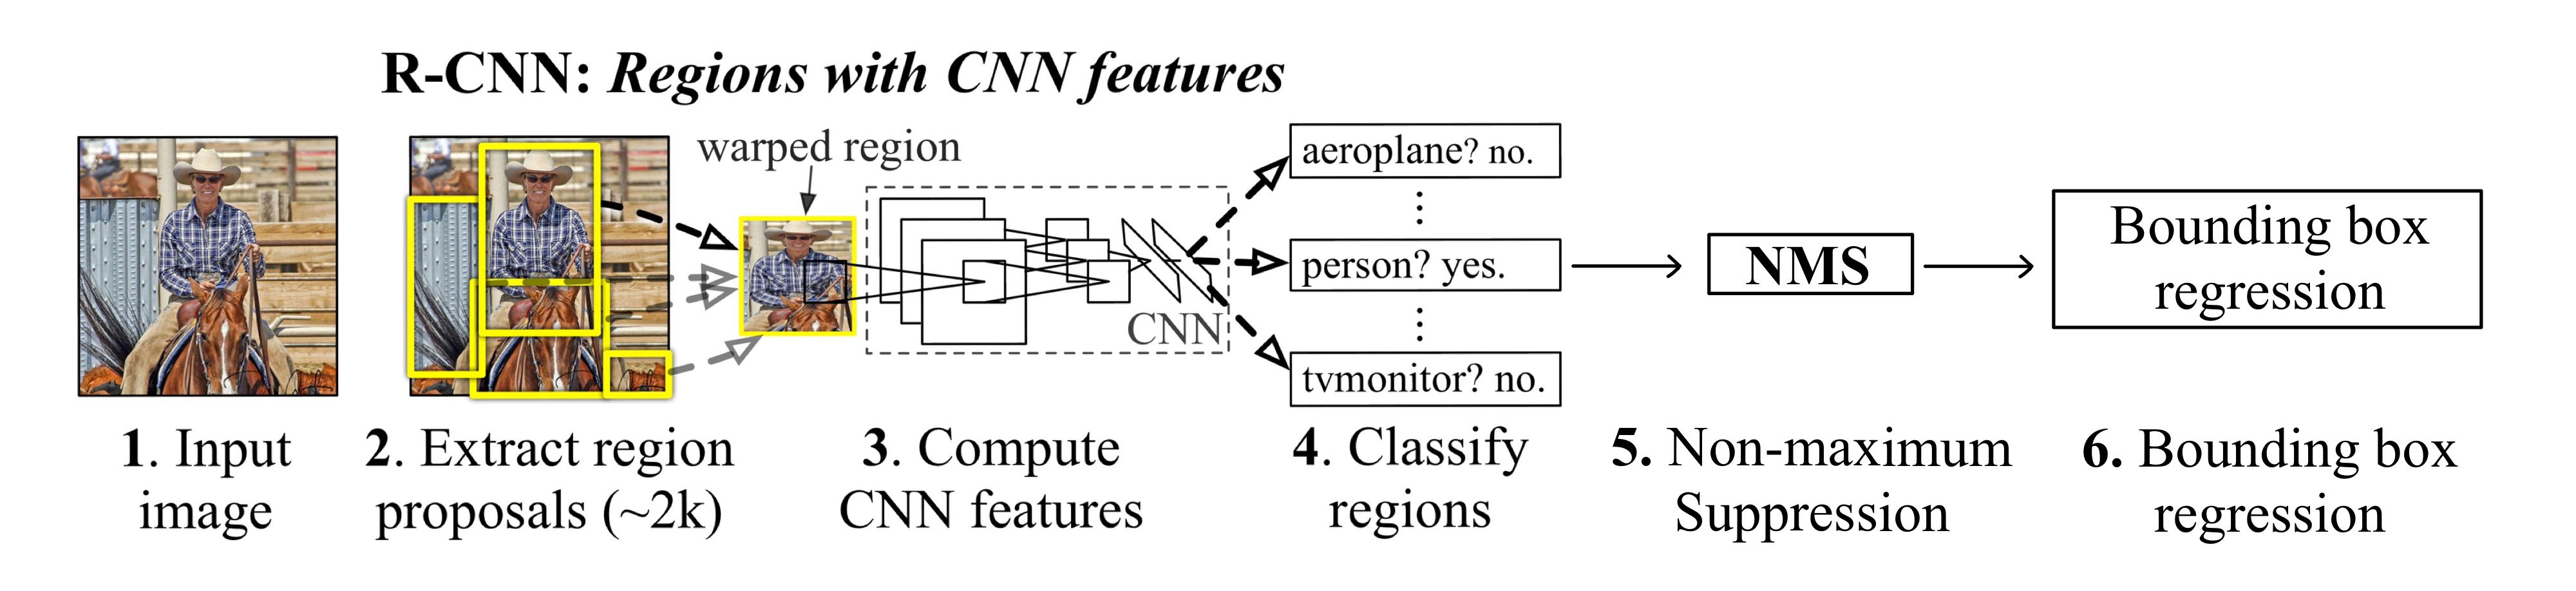
选择性搜索(Selective Search)生成潜在边界框、卷积网络提取特征、SVM打分、线性模型调整边界框、NMS非最大值抑制剔除重复检测框。
- Fast R-CNN
相比于R-CNN,做了以下几点改进
(1)卷积不再是对每个Region Proposal进行,而是直接对整张图像,相当于共享计算;
(2)用ROI Pooling进行特征的尺寸变换,因为全连接层的输入要求尺寸大小一样,因此不能把Region Proposal作为输入;
(3)用SoftMax代替原来的SVM分类器。
- Faster R-CNN
核心改进是使用RPN(Region Propose Network)提取区域,代替Selective Search,极大的提升了检测框的生成速度。

RPN模块主要执行的流程为输入Faster R-CNN的公共Feature Map,生成Anchors,通过SoftMax分类器提取Positive Anchors;最后Proposal Layer负责综合positive anchors和对应bounding box regression偏移量获取proposals,同时剔除重叠和超出边界的proposals。
- Deep MultiBox
使用卷积神经网路代替Selective Search来预测ROI;但无法进行通用目标检测。
- OverFeat
使用卷积神经网路定位(高效实现了滑窗);但是其优化的是定位而非检测性能,且是基于局部来预测的,无法推理全局背景。
- MultiGrasp
提出regression方法来预测抓取物体,但它只是一个更简单的目标检测任务,只需要预测目标的区域,而不需要预测目标的大小、位置、边界信息以及类别。
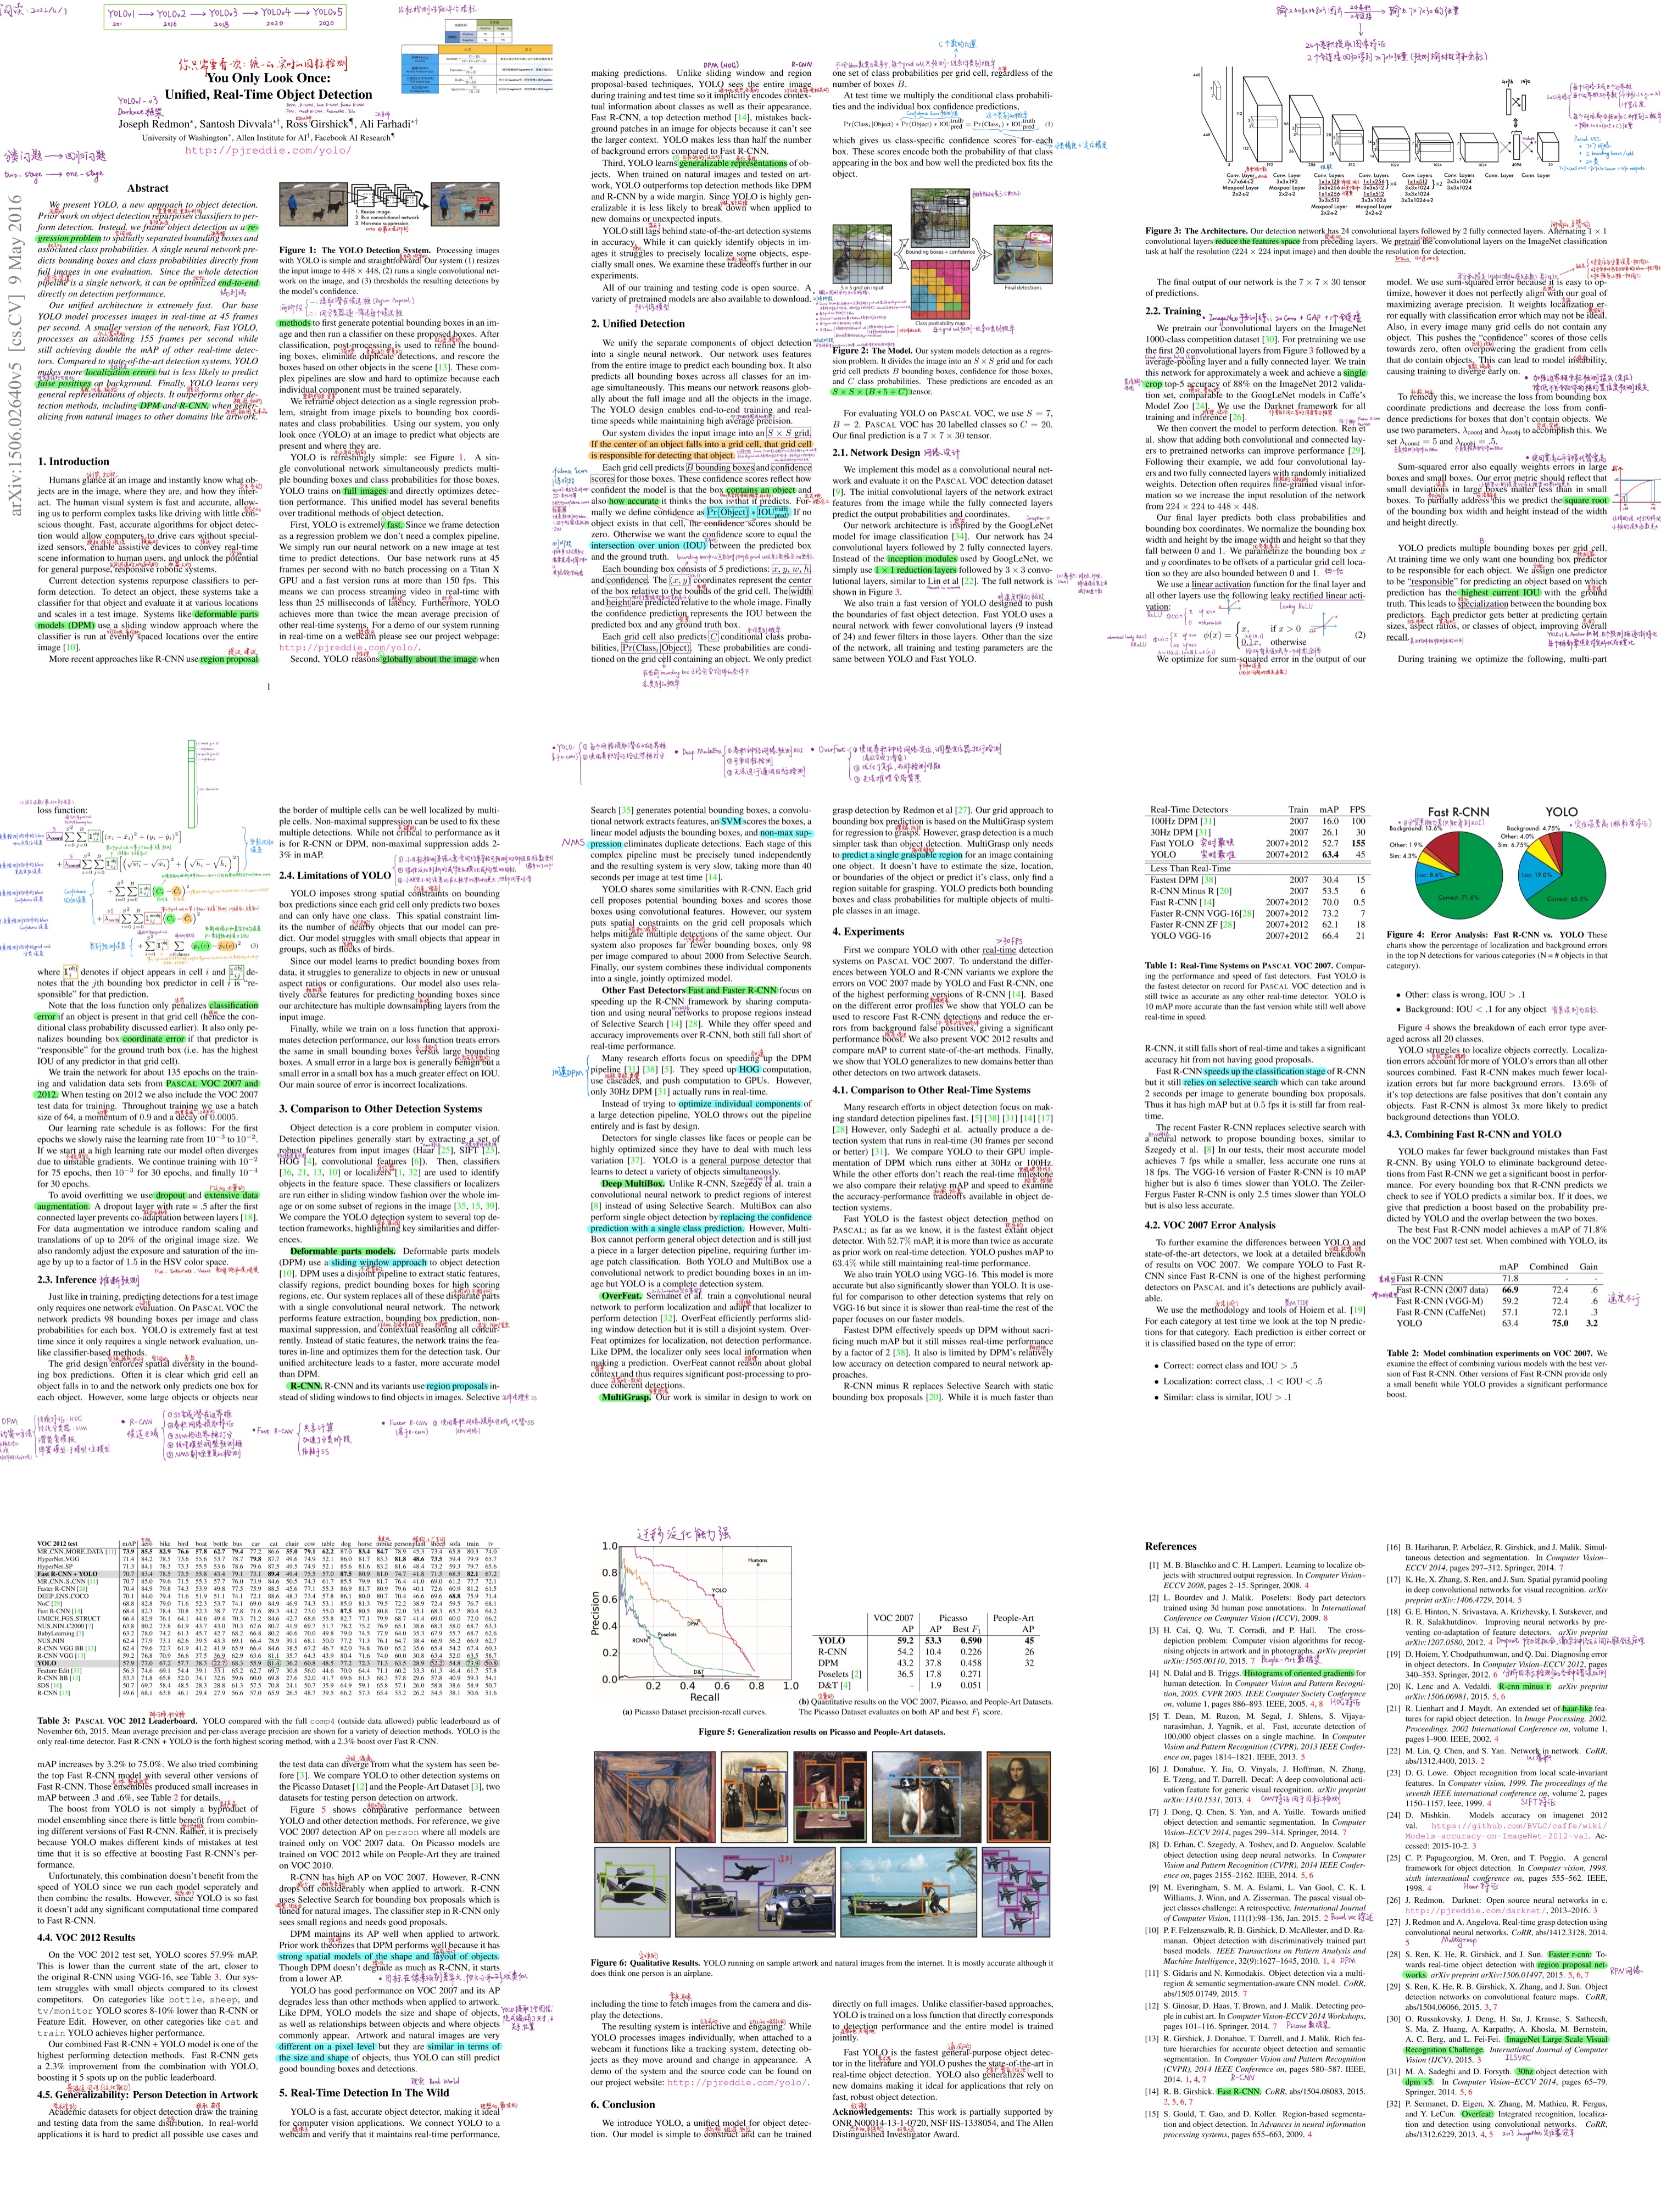
5. 论文精读笔记
可以点击链接下载高清原版笔记pdf,论文重点、专有名词解释、公式推导、复杂单词释义等都有清晰的标注。
参考资料
1、b站子豪兄YOLOv1论文精度(讲的特别清晰,建议一看)
3、一文详解R-CNN、Fast R-CNN、Faster R-CNN
4、读论文:YOLO
【深度学习 论文篇 02-1 】YOLOv1论文精读的更多相关文章
- 深度学习实战篇-基于RNN的中文分词探索
深度学习实战篇-基于RNN的中文分词探索 近年来,深度学习在人工智能的多个领域取得了显著成绩.微软使用的152层深度神经网络在ImageNet的比赛上斩获多项第一,同时在图像识别中超过了人类的识别水平 ...
- Facebook 发布深度学习工具包 PyTorch Hub,让论文复现变得更容易
近日,PyTorch 社区发布了一个深度学习工具包 PyTorchHub, 帮助机器学习工作者更快实现重要论文的复现工作.PyTorchHub 由一个预训练模型仓库组成,专门用于提高研究工作的复现性以 ...
- deep learning...深入学习深度学习 --工具篇
Caffe( http://caffe.berkeleyvision.org/ )是一个清晰而高效的深度学习框架,其作者是博士毕业于UC Berkeley的贾扬清( http://daggerfs.c ...
- 深度学习入门篇--手把手教你用 TensorFlow 训练模型
欢迎大家前往腾讯云技术社区,获取更多腾讯海量技术实践干货哦~ 作者:付越 导语 Tensorflow在更新1.0版本之后多了很多新功能,其中放出了很多用tf框架写的深度网络结构(https://git ...
- 【深度学习 论文篇 01-1 】AlexNet论文翻译
前言:本文是我对照原论文逐字逐句翻译而来,英文水平有限,不影响阅读即可.翻译论文的确能很大程度加深我们对文章的理解,但太过耗时,不建议采用.我翻译的另一个目的就是想重拾英文,所以就硬着头皮啃了.本文只 ...
- 深度学习笔记(七)SSD 论文阅读笔记简化
一. 算法概述 本文提出的SSD算法是一种直接预测目标类别和bounding box的多目标检测算法.与faster rcnn相比,该算法没有生成 proposal 的过程,这就极大提高了检测速度.针 ...
- 深度学习笔记(七)SSD 论文阅读笔记
一. 算法概述 本文提出的SSD算法是一种直接预测目标类别和bounding box的多目标检测算法.与faster rcnn相比,该算法没有生成 proposal 的过程,这就极大提高了检测速度.针 ...
- 状态机引擎在vivo营销自动化中的深度实践 | 引擎篇02
本文是<vivo营销自动化技术解密>的第3篇文章,分析了营销自动化业务背景和状态机引入原因.状态机的三种基本实现方式,同时介绍了几种业界流行的开源状态机框架实现和特点,以及在项目开发过程中 ...
- 从DeepNet到HRNet,这有一份深度学习“人体姿势估计”全指南
从DeepNet到HRNet,这有一份深度学习"人体姿势估计"全指南 几十年来,人体姿态估计(Human Pose estimation)在计算机视觉界备受关注.它是理解图像和视频 ...
随机推荐
- # Redhat7 安装 yum源
第一步:先卸载原来的yum rpm -qa |grep yum 查看原来是否安装 yum-3.4.3-118.el7.noarch yum-utils-1.1.31-24.el7.noarch yum ...
- 4月17日 python学习总结 反射、object内置方法、元类
一.反射 下述四个函数是专门用来操作类与对象属性的,如何操作? 通过字符串来操作类与对象的属性,这种操作称为反射 class People: country="China" def ...
- 使用systemd-analyze 工具来分析各个服务进程的启动性能
systemd-analyze是一个分析启动性能的工具,用于分析启动时服务时间消耗.默认显示启动是内核和用户空间的消耗时间:使用systemd-analyze plot > boot.svg生成 ...
- Vue中import和require的对比
Vue中import和require的对比 一.前言 vue框架想必是我们前端朋友们必学的知识点,说它难也没有那么难,说简单也没有那么简单,主要技术就是那么几个,可是里面的细节很多,有些时候我们会 ...
- 数据库篇:mysql锁详解
前言 sql事务的执行,如果需要锁定数据进行更新操作,则必定离不开锁 共享锁和排他锁 表锁 行锁 Record Lock 间隙锁 Gap Lock 行锁+间隙锁 Next-Key Lock 加锁场景( ...
- APUE1--3.8-3.10wirte、read函数以及IO效率
1read函数 #include<unistd.h> ssize_t read(int fd,void* buf,size_t nbytes) 返回值:读到的字节数,若已到文件尾,返回0; ...
- flexible如何实现自动判断dpr?
判断机型, 找出样本机型去适配. 比如iphone以6为样本, 宽度375px, dpr是2
- Redis 最适合的场景?
1.会话缓存(Session Cache) 最常用的一种使用 Redis 的情景是会话缓存(session cache).用 Redis 缓存会 话比其他存储(如 Memcached)的优势在于:Re ...
- Spring-MVC 里面的ModelAndView
作用: 由于本身http是无状态的并不会保存什么请求信息. 但是目标页面可能又需要一些信息.这时候可以用ModelAndView存放一些业务数据之类等.然后返回给页面 用法: 比较重要的方法: 往对 ...
- idea推送项目到github
参考: https://blog.csdn.net/SoWhatWorld/article/details/103817786?depth_1-utm_source=distribute.pc_rel ...