
实践2:如何使用word2vec和k-means聚类寻找相似的城市
理解业务
一个需求:把相似的目的地整理出来,然后可以通过这些相似目的地做相关推荐,或者是相关目的地的推荐
准备数据
Word2Vec算法:可以学习输入的文本,并输出一个词向量模型
对数据进行清洗,去出异常的数据;对文本内容进行分词;把数据存储在文本文件中
训练Word2Vec模型
import gensim

import os

import re

import sys

import multiprocessing #引入多线程操作

from time import time

class getSentence(object):

#初始化,获取文件路径

   def __init__(self,dirname):

     self.dirname=dirname

#构建一个迭代器

def __iter__(self):

   for root,dirs,files in os.walk(self.dirname):

      for filename in files:

         file_path = root +'/'+filename

         for line in open(file_path):

              try:

             #清除异常数据,主要是去除空白符以及长度为0的内容

                 s_line = line.strip()

                 if s_line=="":

                       continue

       #把句子拆成词

                 word_line = [word for word in s_line.split()]

                 yeild word_line

               except Exception:

                  print("catch exception")

                  yeild ""

if __name__='__main__':

#记录一个起始时间

   begin=time()

#获取句子迭代器

   setences=getSentences("traindata")

#训练word2vec模型,使用句子迭代器作为语料的输入,设定的最终向量长度为200维;窗口长度为15;词的最小计数为10,词频少于10的词不会进行计算;使用并行处理

   model=

gensim.models.Word2Vec(sentences,size=200,window=15,min_count=10,workers=multiprocessing.cpu_count())

#模型存储,这块记得预先新建一个model路径,或者增加一段代码来识别是否已经创建,如果没有则新建一个路径

    model.save("model/word2vec_gensim")

    model.wv.save_word2vec_format("model/word2vec_org",

                "model/vocabulary",binary=False)

    end.time()

#输出运算所用时间

    print("Total processing time:%d seconds" % (end-begin))
训练k-means模型
import gensim

from sklearn.cluster import KMeans

from sklearn.externals import joblib

from time import time

#加载之前已经训练好的word2vec模型

def load_model():

  model=

gensim.models.Word2Vec.load('../word2vec/model/word2vec_gensim')

   return model

#加载城市名称词库

   fd=open("mddwords.txt","r")

   filterword=[]

   for line in fd.readlines():

      line=line.strip()

      fliterword.append(line)

   return fliterword

if __name__=="__main__":

  start=time()

#加载word2vec模型

  model=load_filterword()

#输出词汇表长度

  print(len(filterword))

  wordvector=[]

  filterkey={}

#获取城市名称词库的词向量

  for word in filterword:

     wordvector.append(model[word])

     filterkey[word]=model[word]

#输出词汇数量

  print(len(wordvector))

#训练K-means模型,这里设置的聚类数为2000,最大迭代次数为100,n_jobs设置的是有多少个任务同时在跑,这样可以进行多组实验来消除初始化点带来的影响

  clf=KMeans(n_clusters=2000,max_iter=100,n_jobs=10)

  s=clf.fit_predict(wordvector)

#把模型保存下来

   joblib.dump(clf,"kmeans_mdd2000.pkl")

   labels=clf.labels_

   labellist=labels.tolist()

   print(clf.inertia_)

#把所有城市名称的聚类标签保存下来

   fp=open("label_mdd2000",'w')

   fp.write(str(labellist))

   fp.close()

#把所有城市名称保存下来,其中顺序与聚类标签顺序一致

   fp1=open("keys_mdd2000",'w')

   for k in filterkey:

      fp1.write(key+'\n')

   print("over")

   end=time()

   print("use time")

   print(end-start)
最终确定的聚类簇数是100
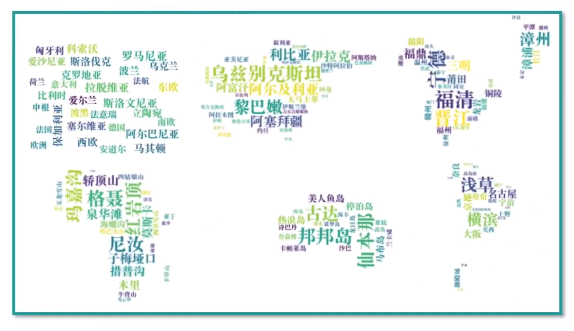
把这些数据存储到数据库中,并在具体的业务中进行应用
实践2:如何使用word2vec和k-means聚类寻找相似的城市的更多相关文章
- 机器学习算法与Python实践之(六)二分k均值聚类
http://blog.csdn.net/zouxy09/article/details/17590137 机器学习算法与Python实践之(六)二分k均值聚类 zouxy09@qq.com http ...
- 机器学习算法与Python实践之(五)k均值聚类(k-means)
机器学习算法与Python实践这个系列主要是参考<机器学习实战>这本书.因为自己想学习Python,然后也想对一些机器学习算法加深下了解,所以就想通过Python来实现几个比较常用的机器学 ...
- ML: 聚类算法-K均值聚类
基于划分方法聚类算法R包: K-均值聚类(K-means) stats::kmeans().fpc::kmeansruns() K-中心点聚类(K-Medoids) ...
- 【转】算法杂货铺——k均值聚类(K-means)
k均值聚类(K-means) 4.1.摘要 在前面的文章中,介绍了三种常见的分类算法.分类作为一种监督学习方法,要求必须事先明确知道各个类别的信息,并且断言所有待分类项都有一个类别与之对应.但是很多时 ...
- 5-Spark高级数据分析-第五章 基于K均值聚类的网络流量异常检测
据我们所知,有‘已知的已知’,有些事,我们知道我们知道:我们也知道,有 ‘已知的未知’,也就是说,有些事,我们现在知道我们不知道.但是,同样存在‘不知的不知’——有些事,我们不知道我们不知道. 上一章 ...
- 机器学习实战5:k-means聚类:二分k均值聚类+地理位置聚簇实例
k-均值聚类是非监督学习的一种,输入必须指定聚簇中心个数k.k均值是基于相似度的聚类,为没有标签的一簇实例分为一类. 一 经典的k-均值聚类 思路: 1 随机创建k个质心(k必须指定,二维的很容易确定 ...
- Python实现kMeans(k均值聚类)
Python实现kMeans(k均值聚类) 运行环境 Pyhton3 numpy(科学计算包) matplotlib(画图所需,不画图可不必) 计算过程 st=>start: 开始 e=> ...
- 机器学习理论与实战(十)K均值聚类和二分K均值聚类
接下来就要说下无监督机器学习方法,所谓无监督机器学习前面也说过,就是没有标签的情况,对样本数据进行聚类分析.关联性分析等.主要包括K均值聚类(K-means clustering)和关联分析,这两大类 ...
- R与数据分析旧笔记(十五) 基于有代表性的点的技术:K中心聚类法
基于有代表性的点的技术:K中心聚类法 基于有代表性的点的技术:K中心聚类法 算法步骤 随机选择k个点作为"中心点" 计算剩余的点到这个k中心点的距离,每个点被分配到最近的中心点组成 ...
随机推荐
- 在java中静态方法与非静态方法
在java中public void与public static void有什么区别 ? public void 修饰是非静态方法,该类方法属于对象,在对象初始化(new Object())后才能被调用 ...
- Swift字符串的介绍
字符串的介绍 字符串在任何的开发中使用都是非常频繁的 OC和Swift中字符串的区别 在OC中字符串类型时NSString,在Swift中字符串类型是String OC中字符串@"" ...
- ubuntu memcached安装与配置
转载请注明来源:https://www.cnblogs.com/hookjc/ 关于Memcache与memcachedMemcache是项目名,memcached是服务名.让很多初接触的人感觉很是莫 ...
- Fastjson的JSONObject.toJSON()解析复杂对象发生内存泄漏问题
这可能是fastjson的一个bug,我使用最新版依然存在该问题. 在用做报表功能的时候,发现一旦单元格过多,大概有80-100个单元格,就会发生程序假死,CPU持续占用超过90%,内存持续占用超90 ...
- Java 给Word每一页设置不同文字水印效果
Word中设置水印时,可预设的文字或自定义文字设置为水印效果,但通常添加水印效果时,会对所有页面都设置成统一效果,如果需要对每一页或者某个页面设置不同的水印效果,则可以参考本文中的方法.下面,将以Ja ...
- world.construct(me);
目录 0 引言 0.1 所谓构造题 0.2 重点是动机 (motivation) 1 实践出真知 1.1 「CSP-S 2021」「洛谷 P7915」回文 1.1.1 题目大意 1.1.2 解题过程 ...
- Solution -「JOISC 2021」「LOJ #3491」道路建设
\(\mathcal{Description}\) Link. 平面上有 \(n\) 个互不重合的点 \((x_{1..n},y_{1..n})\),求其两两曼哈顿距离的前 \(m\) 小值. ...
- MYSQL 获取最近多少天时间列表
1.首先获取一个最近1000天的时间列表,如果不够可以按规则再加 SELECT adddate(CURDATE(),-(t2.i * 100 + t1.i * 10 + t0.i)) date FRO ...
- 软件性能测试分析与调优实践之路-Java应用程序的性能分析与调优-手稿节选
Java编程语言自从诞生起,就成为了一门非常流行的编程语言,覆盖了互联网.安卓应用.后端应用.大数据等很多技术领域,因此Java应用程序的性能分析和调优也是一门非常重要的课题.Java应用程序的性能直 ...
- monowall
https://www.cat-home.org/?action=show&id=158