
Spark 大数据文本统计
此程序功能:
1.完成对10.4G.csv文件各个元素频率的统计
2.获得最大的统计个数
3.对获取到的统计个数进行降序排列
4.对各个元素出现次数频率的统计
import org.apache.spark.{SparkConf, SparkContext}

/**

  */

object 大数据统计 {

  def main(args: Array[String]): Unit = {

    val conf=new SparkConf().setAppName("大数据").setMaster("local[4]")

    val sc=new SparkContext(conf)

//    val text= sc.textFile("/home/soyo/桌面/shell编程测试/1.txt")

val text= sc.textFile("/home/soyo/下载/Hadoop+Spark+Hbase/all2.csv")

    //text.foreach(println)

    val wordcount= text.flatMap(line=>line.split(",")).map(word=>(word,))

         .reduceByKey((a,b)=>a+b)

        wordcount.collect().foreach(println)

//    wordcount.saveAsTextFile("/home/soyo/桌面/shell编程测试/1-1-1.txt")

        println("单独文件中各个数的统计个数")

//        wordcount.map(_._2).foreach(println)

    println("获取统计的最大数")

   // wordcount.map(_._2).saveAsTextFile("/home/soyo/下载/Hadoop+Spark+Hbase/77.txt")

    println(wordcount.map(_._2).max())

        println("对获取到的数降序排列")

        wordcount.map(_._2).sortBy(x=>x,false).foreach(println)  //false:降序 true:升序

       println("转变为key-value形式")

        wordcount.map(_._2).map(num=>(num,)).reduceByKey((a,b)=>a+b).foreach(println)

        println("对key-value按key再排序,获得结果表示:假设文件中'soyo5'总共出现10次,可文件'soyo1'也出现10次,最后整个排序获得的是(10,2)10次的共出现2次")

    wordcount.map(_._2).map(num=>(num,)).reduceByKey((a,b)=>a+b).sortByKey().foreach(println)

  }

}
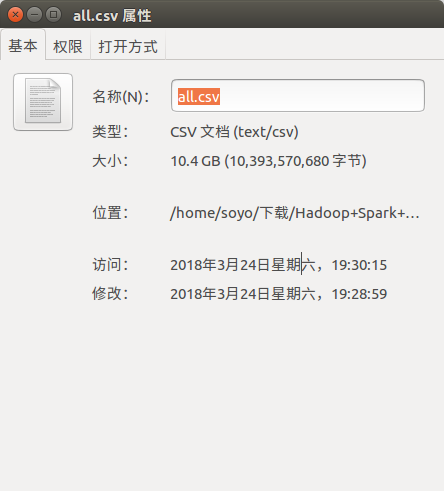
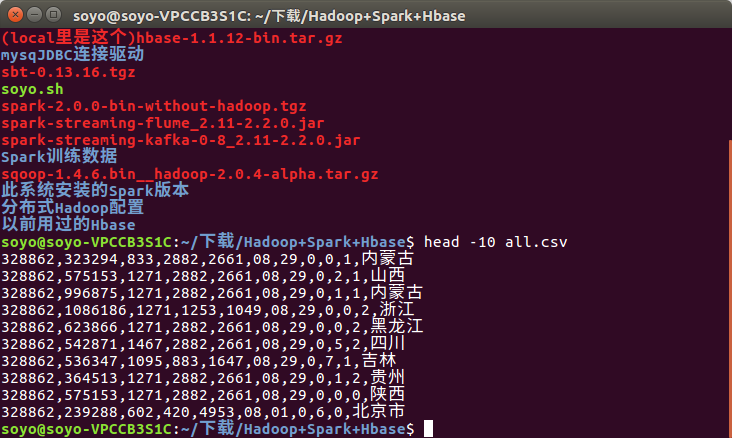
数据内容:
Spark 保存的文件是这样的:
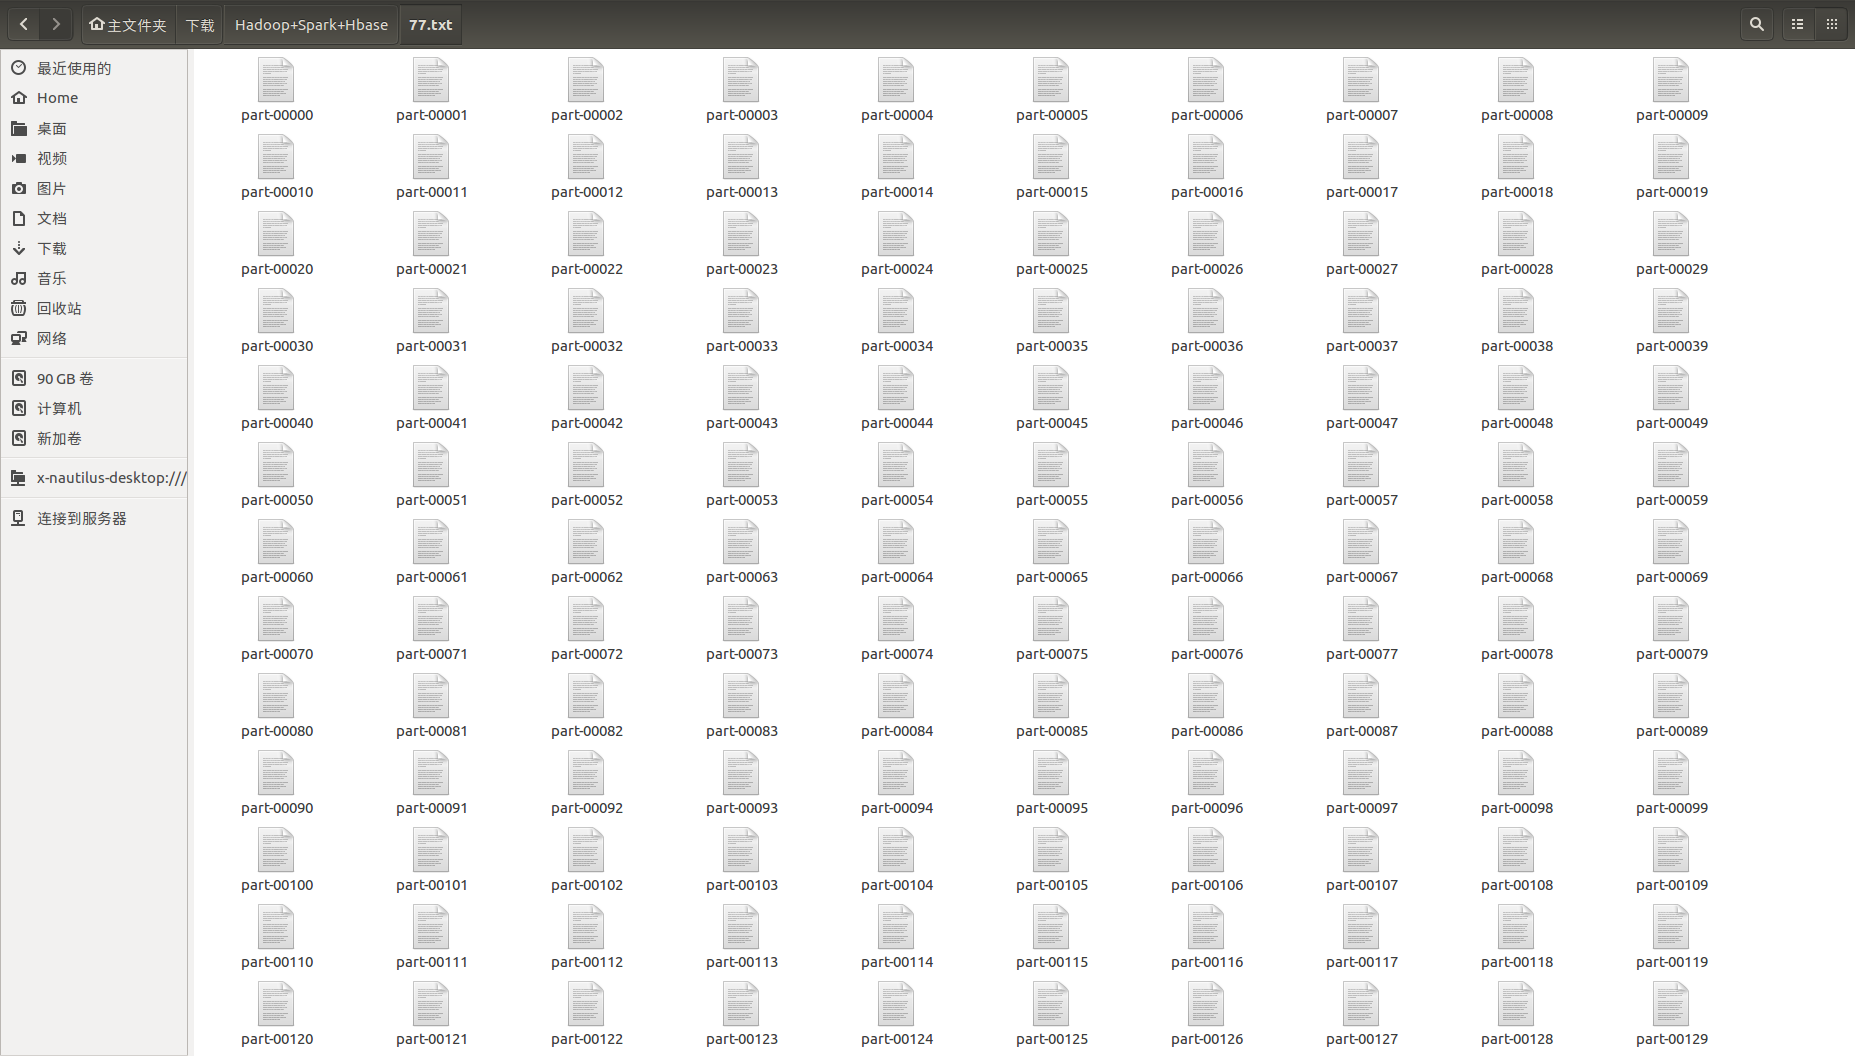
这里可以用一个脚本将这么多的文件进行合并:
#!/bin/bash

cat * >>soyoo.txt
结果太多只写一个:
获取统计的最大数
294887496 (数据中有一个元素出现了这么多次)
Spark 大数据文本统计的更多相关文章
- C#大数据文本高效去重
C#大数据文本高效去重 转载请注明出处 http://www.cnblogs.com/Huerye/ TextReader reader = File.OpenText(@"C:\Users ...
- SQL大数据操作统计
SQL大数据操作统计 1:select count(*) from table的区别SELECT object_name(id) as TableName,indid,rows,rowcnt FROM ...
- 学习Hadoop+Spark大数据巨量分析与机器学习整合开发-windows利用虚拟机实现模拟多节点集群构建
记录学习<Hadoop+Spark大数据巨量分析与机器学习整合开发>这本书. 第五章 Hadoop Multi Node Cluster windows利用虚拟机实现模拟多节点集群构建 5 ...
- 教你如何成为Spark大数据高手?
教你如何成为Spark大数据高手? Spark目前被越来越多的企业使用,和Hadoop一样,Spark也是以作业的形式向集群提交任务,那么如何成为Spark大数据高手?下面就来个深度教程. Spark ...
- Spark大数据针对性问题。
1.海量日志数据,提取出某日访问百度次数最多的那个IP. 解决方案:首先是将这一天,并且是访问百度的日志中的IP取出来,逐个写入到一个大文件中.注意到IP是32位的,最多有个2^32个IP.同样可以采 ...
- Azure HDInsight 和 Spark 大数据实战(一)
What is HDInsight? Microsoft Azure HDInsight 是基于 Hortonoworks Data Platform (HDP) 的 Hadoop 集群,包括Stor ...
- Spark大数据的学习历程
Spark主要的编程语言是Scala,选择Scala是因为它的简洁性(Scala可以很方便在交互式下使用)和性能(JVM上的静态强类型语言).Spark支持Java编程,但对于使用Java就没有了Sp ...
- 【福利】送Spark大数据平台视频学习资料
没有套路真的是送!! 大家都知道,大数据行业spark很重要,那话我就不多说了,贴心的大叔给你找了份spark的资料. 多啰嗦两句,一个好的程序猿的基本素养是学习能力和自驱力.视频给了你们,能不能 ...
- 小试牛刀ElasticSearch大数据聚合统计
ElasticSearch相信有不少朋友都了解,即使没有了解过它那相信对ELK也有所认识E即是ElasticSearch.ElasticSearch最开始更多用于检索,作为一搜索的集群产品简单易用绝对 ...
随机推荐
- hdu 4091
#include<stdio.h> #include<math.h> __int64 gcd(__int64 a,__int64 b) { if(b==0) return ...
- WebService流行框架CXF
CXF官方网址:http://cxf.apache.org/ CXF官方网址:官网学习地址:http://cxf.apache.org/docs/index.html 官网下载cxf压缩文件: ...
- Hihocoder #1067 : 最近公共祖先·二
时间限制:10000ms 单点时限:1000ms 内存限制:256MB 描述 上上回说到,小Hi和小Ho用非常拙劣——或者说粗糙的手段山寨出了一个神奇的网站,这个网站可以计算出某两个人的所有共同祖先中 ...
- php之ThinkPHP的memcached类的修改
php之ThinkPHP的memcached类的修改 在Think\Cache\Driver\Memcached.class.php中,增加方法获取错误信息的方法,方便调试, public funct ...
- HUD——1083 Courses
HUD——1083 Courses Time Limit: 20000/10000 MS (Java/Others) Memory Limit: 65536/32768 K (Java/Ot ...
- hihocoder 1165 : 益智游戏
时间限制:20000ms 单点时限:1000ms 内存限制:256MB 描述 幽香今天心情不错,正在和花田里的虫子玩一个益智游戏.这个游戏是这样的,对于一个数组A,幽香从A中选择一个数a,虫子从A中选 ...
- POJ 2240 【这题貌似可以直接FLOYD 屌丝用SPFA通过枚举找正权值环 顺便学了下map】
题意: 给了n种硬币的名称,给了m种硬币间的转换关系. 从任意兑换地点开始兑换,看是否能够通过兑换的方式增加金钱. 思路: 用SPFA不断对各个点进行松弛操作,寻找正权值的环.如果找到则输出Yes. ...
- loj6158 A+B Problem (扩展KMP)
题目: https://loj.ac/problem/6158 分析: 先把S串逆置,就是从低位向高位看 我们再弄个T串,S串前面有x个连续的0,那么T串前面也有x个连续的0 第x+1位,满足S[x+ ...
- 表皮囊肿?wtf
https://baike.baidu.com/item/%E8%A1%A8%E7%9A%AE%E5%9B%8A%E8%82%BF/7852024?fr=aladdin
- UVA 4857 Halloween Costumes 区间背包
题目链接:https://icpcarchive.ecs.baylor.edu/index.php?option=com_onlinejudge&Itemid=8&page=show_ ...