
Python爬虫使用Selenium+PhantomJS抓取Ajax和动态HTML内容
1,引言
在Python网络爬虫内容提取器一文我们详细讲解了核心部件:可插拔的内容提取器类gsExtractor。本文记录了确定gsExtractor的技术路线过程中所做的编程实验。这是第二部分,第一部分实验了用xslt方式一次性提取静态网页内容并转换成xml格式。留下了一个问题:javascript管理的动态内容怎样提取?那么本文就回答这个问题。
2,提取动态内容的技术部件
在上一篇python使用xslt提取网页数据中,要提取的内容是直接从网页的source code里拿到的。但是一些Ajax动态内容是在source code找不到的,就要找合适的程序库把异步或动态加载的内容加载上来,交给本项目的提取器进行提取。
python可以使用selenium执行javascript,selenium可以让浏览器自动加载页面,获取需要的数据。selenium自己不带浏览器,可以使用第三方浏览器如Firefox,Chrome等,也可以使用headless浏览器如PhantomJS在后台执行。
3,源代码和实验过程
假如我们要抓取京东手机页面的手机名称和价格(价格在网页源码是找不到的),如下图:

第一步:利用集搜客谋数台的直观标注功能,可以极快速度自动生成一个调试好的抓取规则,其实是一个标准的xslt程序,如下图,把生成的xslt程序拷贝到下面的程序中即可。注意:本文只是记录实验过程,实际系统中,将采用多种方式把xslt程序注入到内容提取器重。

第二步:执行如下代码(在windows10, python3.2下测试通过,源代码下载地址请见文章末尾GitHub),请注意:xslt是一个比较长的字符串,如果删除这个字符串,代码没有几行,足以见得Python之强大
#/usr/bin/python

from urllib import request

from lxml import etree

from selenium import webdriver

import time

# 京东手机商品页面

url="http://item.jd.com/1312640.html"

# 下面的xslt是通过集搜客的谋数台图形界面自动生成的

xslt_root = etree.XML("""\

<xsl:stylesheet version="1.0" xmlns:xsl="http://www.w3.org/1999/XSL/Transform" >

<xsl:template match="/">

<商品>

<xsl:apply-templates select="//*[@id='itemInfo' and count(.//*[@id='summary-price']/div[position()=2]/strong/text())>0 and count(.//*[@id='name']/h1/text())>0]" mode="商品"/>

</商品>

</xsl:template>

<xsl:template match="//*[@id='itemInfo' and count(.//*[@id='summary-price']/div[position()=2]/strong/text())>0 and count(.//*[@id='name']/h1/text())>0]" mode="商品">

<item>

<价格>

<xsl:value-of select="*//*[@id='summary-price']/div[position()=2]/strong/text()"/>

<xsl:value-of select="*[@id='summary-price']/div[position()=2]/strong/text()"/>

<xsl:if test="@id='summary-price'">

<xsl:value-of select="div[position()=2]/strong/text()"/>

</xsl:if>

</价格>

<名称>

<xsl:value-of select="*//*[@id='name']/h1/text()"/>

<xsl:value-of select="*[@id='name']/h1/text()"/>

<xsl:if test="@id='name'">

<xsl:value-of select="h1/text()"/>

</xsl:if>

</名称>

</item>

</xsl:template>

</xsl:stylesheet>""")

# 使用webdriver.PhantomJS

browser=webdriver.PhantomJS(executable_path='C:\\phantomjs-2.1.1-windows\\bin\\phantomjs.exe')

browser.get(url)

time.sleep(3)

transform = etree.XSLT(xslt_root)

# 执行js得到整个dom

html = browser.execute_script("return document.documentElement.outerHTML")

doc = etree.HTML(html)

# 用xslt从dom中提取需要的字段

result_tree = transform(doc)

print(result_tree)
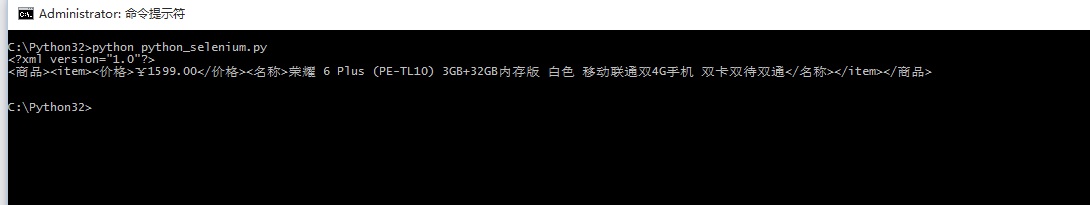
第三步:可以看到,网页中的手机名称和价格被正确抓取下来了
4,接下来阅读
至此,我们通过两篇文章演示怎样抓取静态和动态网页内容,都采用了xslt一次性将需要的内容从网页上提取出来,其实xslt是一个比较复杂的程序语言,如果手工编写xslt,那么还不如写成离散的xpath。如果这个xslt不是手工写出来的,而是程序自动生成的,这就有意义了,程序员再也不要花时间编写和调测抓取规则了,这是很费时费力的工作。下一篇《1分钟快速生成用于网页内容提取的xslt》将讲述怎样生成xslt。
5,集搜客GooSeeker开源代码下载源
1. GooSeeker开源Python网络爬虫GitHub源
6,文档修改历史
2016-05-26:V2.0,增补文字说明
2016-05-29:V2.1,增加第五章:源代码下载源,并更换github源的网址
Python爬虫使用Selenium+PhantomJS抓取Ajax和动态HTML内容的更多相关文章
- [Python爬虫] 之十三:Selenium +phantomjs抓取活动树会议活动数据
抓取活动树网站中会议活动数据(http://www.huodongshu.com/html/index.html) 具体的思路是[Python爬虫] 之十一中抓取活动行网站的类似,都是用多线程来抓取, ...
- [Python爬虫] 之九:Selenium +phantomjs抓取活动行中会议活动(单线程抓取)
思路是这样的,给一系列关键字:互联网电视:智能电视:数字:影音:家庭娱乐:节目:视听:版权:数据等.在活动行网站搜索页(http://www.huodongxing.com/search?city=% ...
- C#使用Selenium+PhantomJS抓取数据
本文主要介绍了C#使用Selenium+PhantomJS抓取数据的方法步骤,具有很好的参考价值,下面跟着小编一起来看下吧 手头项目需要抓取一个用js渲染出来的网站中的数据.使用常用的httpclie ...
- Python爬虫实战四之抓取淘宝MM照片
原文:Python爬虫实战四之抓取淘宝MM照片其实还有好多,大家可以看 Python爬虫学习系列教程 福利啊福利,本次为大家带来的项目是抓取淘宝MM照片并保存起来,大家有没有很激动呢? 本篇目标 1. ...
- Python爬虫实战六之抓取爱问知识人问题并保存至数据库
大家好,本次为大家带来的是抓取爱问知识人的问题并将问题和答案保存到数据库的方法,涉及的内容包括: Urllib的用法及异常处理 Beautiful Soup的简单应用 MySQLdb的基础用法 正则表 ...
- selenium+PhantomJS 抓取淘宝搜索商品
最近项目有些需求,抓取淘宝的搜索商品,抓取的品类还多.直接用selenium+PhantomJS 抓取淘宝搜索商品,快速完成. #-*- coding:utf-8 -*-__author__ =''i ...
- 一次Python爬虫的修改,抓取淘宝MM照片
这篇文章是2016-3-2写的,时隔一年了,淘宝的验证机制也有了改变.代码不一定有效,保留着作为一种代码学习. 崔大哥这有篇>>小白爬虫第一弹之抓取妹子图 不失为学python爬虫的绝佳教 ...
- [Python爬虫] 之十一:Selenium +phantomjs抓取活动行中会议活动信息
一.介绍 本例子用Selenium +phantomjs爬取活动行(http://www.huodongxing.com/search?qs=数字&city=全国&pi=1)的资讯信息 ...
- [Python爬虫] 之十:Selenium +phantomjs抓取活动行中会议活动
一.介绍 本例子用Selenium +phantomjs爬取活动树(http://www.huodongshu.com/html/find_search.html?search_keyword=数字) ...
随机推荐
- 函数:内嵌函数和闭包 - 零基础入门学习Python020
函数:内嵌函数和闭包 让编程改变世界 Change the world by program 内嵌函数和闭包 接下来这两节课我们谈的话题可能会"比较高级",所以如果是零基础的朋友, ...
- 对Spring.Net+NHibenate+Asp.Net Mvc+Easyui框架的个人认识
对Spring.Net+NHibenate+Asp.Net Mvc+Easyui框架的个人认识 初次接触Spring.Net+NHibenate+Asp.Net Mvc+Easyui框架,查阅了相 ...
- Ubuntu下配置NFS服务
Table of Contents 1.下载相关软件 2.建立共享目录 3.修改该配置文件 4.重启服务 5.测试服务器 6.测试客户端 测试系统:Ubuntu8.04 1.下载相关软件 使用如下命令 ...
- Java学习系列(一)Java的运行机制、JDK的安装配置及常用命令详解
俗话说:“十五的月亮十六圆”.那学习是不是也是如此呢?如果把月亮看成是我们的愿望,那十五便是我们所处的“高原期”,坚持迈过这个坎,我相信你的愿望终究会现实的.记得马云曾说:今天很残酷,明天更残酷,后天 ...
- c++ 10
一.二叉树 1.基本特征 1)树型结构的最简模型,每个节点最多有两个子节点--左子节点和右子节点. 2)单根性,每个子节点有且仅有一个父节点,整棵树有且仅有一个根节点. 3)递归性,以任何一个节点为根 ...
- (heap)239. Sliding Window Maximum
题目: Given an array nums, there is a sliding window of size k which is moving from the very left of t ...
- Smallest Rectangle Enclosing Black Pixels 解答
Question An image is represented by a binary matrix with 0 as a white pixel and 1 as a black pixel. ...
- Android基础之退出应用程序Demo
对于Android我也不是很熟悉,只是学习一些基本内容就OK.所以写的内容也很简单.本Demo要实现的效果就是双击返回键弹出提示框确认是否退出程序. 一.废话少说直接上代码.至于涉及到的相关包在Ecl ...
- [Regex Expression] Tagline --- {0, } {1,10}
Using a character set repeated 1 or more times, make a pattern to search for strings that do not con ...
- Git 多人协作的工作模式
多人协作 148次阅读 当你从远程仓库克隆时,实际上Git自动把本地的master分支和远程的master分支对应起来了,并且,远程仓库的默认名称是origin. 要查看远程库的信息,用git rem ...