
Storm概念学习系列之storm核心组件
不多说,直接上干货!
Storm核心组件
了解 Storm 的核心组件对于理解 Storm 原理非常重要,下面介绍 Storm 的整体,然后介绍 Storm 的核心。 Storm 集群由一个主节点和多个工作节点组成。主节点运行一个名为“Nimbus”的守护进程,工作节点都运行一个名为“Supervisor”的守护进程,两者的协调工作由 ZooKeeper 来完成, ZooKeeper 用于管理集群中的不同组件。
每一个工作节点上运行的 Supervisor 监听分配给它那台机器的工作,根据需要启动 / 关闭工作进程,每一个工作进程执行一个 Topology 的一个子集;一个运行的 Topology 由运行在很多机器上的很多工作进程 Worker 组成。那么 Storm 的核心就是主节点(Nimbus)、工作节点(Supervisor)、协调器(ZooKeeper)、工作进程( Worker)、任务线程(Task)。
1、主节点 Nimbus
主节点通常运行一个后台程序——Nimbus,用于响应分布在集群中的节点,分配任务和监测故障,这类似于 Hadoop 中的 JobTracker。
Nimbus 进程是快速失败( fail-fast)和无状态的,所有的状态要么在 ZooKeeper 中,要么在本地磁盘上。可以使用 kill -9 来杀死 Nimbus 进程,然后重启即可继续工作。
2、工作节点 Supervisor
工作节点同样会运行一个后台程序——Supervisor,用于收听工作指派并基于要求运行工作进程。每个工作节点都是Topology中一个子集的实现。而Nimbus 和 Supervisor 之间的协调则通过 ZooKeeper 系统。
同 样,Supervisor进程也是快速失败(fail-fast)和无状态的, 所有的状态要么在ZooKeeper中,要么在本地磁盘上,用kill -9来杀死Supervisor进程,然后重启就可以继续工作。
3、协调服务组件 ZooKeeper
ZooKeeper 是完成 Nimbus 和 Supervisor 之间协调的服务。 Storm使用ZooKeeper 协调集群,由于ZooKeeper 并不用于消息传递,所以Storm给ZooKeeper 带来的压力相当低。在大多数情况下,单个节点的 ZooKeeper 集群足够胜任,不过为了确保故障恢复或者部署大规模Storm集群,可能需要更大规模的 ZooKeeper 集群。 Nimbus、 Supervisor 与 ZooKeeper 的关系如图 1 所示。
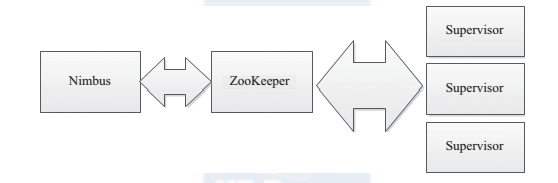
图 1 Nimbus、 Supervisor 与 ZooKeeper 关系图
4、其他核心组件
Storm 的组件不止上面的,还有一些组件也是 Storm 的核心,缺一不可。下面简单介绍Worker 和 Task。
1)具体处理事务进程 Worker:运行具体处理组件逻辑的进程。
2)具体处理线程 Task : Worker 中的每一个 Spout/Bolt 线程称为一个 Task。在 Storm 0.8之后, Task 不再与物理线程对应,同一个 Spout/Bolt 的 Task 可能会共享一个物理线程,该线程称为 Executor。
Storm概念学习系列之storm核心组件的更多相关文章
- Storm概念学习系列之storm的雪崩
不多说,直接上干货! Storm的雪崩问题的解决办法1: Storm概念学习系列之并行度与如何提高storm的并行度 Storm的雪崩问题的解决办法2:
- Storm概念学习系列之storm流程图
把stream当做一列火车, tuple当做车厢,spout当做始发站,bolt当做是中间站点!!! 见 Storm概念学习系列之Spout数据源 Storm概念学习系列之Topology拓扑 Sto ...
- Storm概念学习系列之storm的定时任务
不多说,直接上干货! 至于为什么,有storm的定时任务.这个很简单.但是,这个在工作中非常重要! 假设有如下的业务场景 这个spoult源源不断地发送数据,boilt呢会进行处理.然后呢,处理后的结 ...
- Storm概念学习系列之storm的可靠性
这个概念,对于理解storm很有必要. 1.worker进程死掉 worker是真实存在的.可以jps查看. 正是因为有了storm的可靠性,所以storm会重新启动一个新的worker进程. 2.s ...
- Storm概念学习系列之storm简介
不多说,直接上干货! storm简介 Storm 是 Twitter 开源的.分布式的.容错的实时计算系统,遵循 Eclipse Public License1.0. Storm 通过简单的 API ...
- Storm概念学习系列之storm的功能和三大应用
不多说,直接上干货! storm的功能 Storm 有许多应用领域:实时分析.在线机器学习.持续计算.分布式 RPC(远过程调用协议,一种通过网络从远程计算机程序上请求服务). ETL(Extract ...
- Storm概念学习系列之storm的特性
不多说,直接上干货! storm的特性 Storm 是一个开源的分布式实时计算系统,可以简单.可靠地处理大量的数据流. Storm支持水平扩展,具有高容错性,保证每个消息都会得到处理,而且处理速度很快 ...
- Storm概念学习系列之Storm与Hadoop的角色和组件比较
不多说,直接上干货! Storm与Hadoop的角色和组件比较 Storm 集群和 Hadoop 集群表面上看很类似.但是 Hadoop 上运行的是 MapReduce 作业,而在 Storm 上运行 ...
- Storm概念学习系列之storm的设计思想
不多说,直接上干货! storm的设计思想 在 Storm 中也有对流(Stream)的抽象,流是一个不间断的.无界的连续 Tuple(Storm在建模事件流时,把流中的事件抽象为 Tuple 即元组 ...
随机推荐
- 创建Azure Blob Snapshot的脚本
在前面的文章中介绍了如何创建Azure Blob Snapshot.那篇文章中创建的脚本思路是:遍历所有Storage Account,找到所有vhd文件,进行Snapshot的创建. 但这种方式不够 ...
- mysql查询语句in和exists二者的区别和性能影响
mysql中的in语句是把外表和内表作hash 连接,而exists语句是对外表作loop循环,每次loop循环再对内表进行查询.一直大家都认为exists比in语句的效率要高,这种说法其实是不准确的 ...
- RN控件之View Text
/** * 模仿美团首页部分 * */ 'use strict' import React,{ AppRegistry, Component, StyleSheet, Text, View, Imag ...
- Hadoop YARN配置参数剖析(3)—MapReduce相关参数
MapReduce相关配置参数分为两部分,分别是JobHistory Server和应用程序参数,Job History可运行在一个独立节点上,而应用程序参数则可存放在mapred-site.xml中 ...
- 2、linux-compress and uncompresse
1.单个文件 压缩 解压 gzip file1 gzip -d file1.gz或者gunzip file1.gz #file1文件即会被压缩为 file1.gz,file1原文件删除:解压后同样删 ...
- 阶段2-新手上路\项目-移动物体监控系统\Sprint3-移动监控主系统设计与开发
移动图像监控系统 去找一些相关开源程序进行移植:百度搜索-linux 移动监控 motion是一套免费开源的移动图像监测程序 前面我们已经使用了很多开源软件,他们的使用方法都是大同小异的 1).先在当 ...
- 快速搭建LAMP
1.安装Apache sudo apt-get install apache2 2.安装Mysql sudo apt-get install mysql-server 中间会出现输入 Mysql 的 ...
- sql获取上月同期
select CONVERT(varchar(10), CONVERT(varchar(8),dateadd(month,-1,getdate()),23)+CONVERT(varchar(10),d ...
- c#事件1
Private void button_clicked( object sender ,RouteEventArgs e) sender :引发事件的对象 源 e : 路由事件,提供可能重要 ...
- Haproxy+Keepalived高可用配置
基本实验 参考文档 博文地址 环境拓扑 下面使我们要实现的负载均衡集群图示 主节点地址: 92.0.0.11 从节点地址: 92.0.0.12 共享虚拟地址:92.0.0.8 下面是负载均衡集群可能出 ...