
ES 实战复杂sql查询、修改字段类型
转载请注明出处:
1.查询索引得 mapping 与 setting
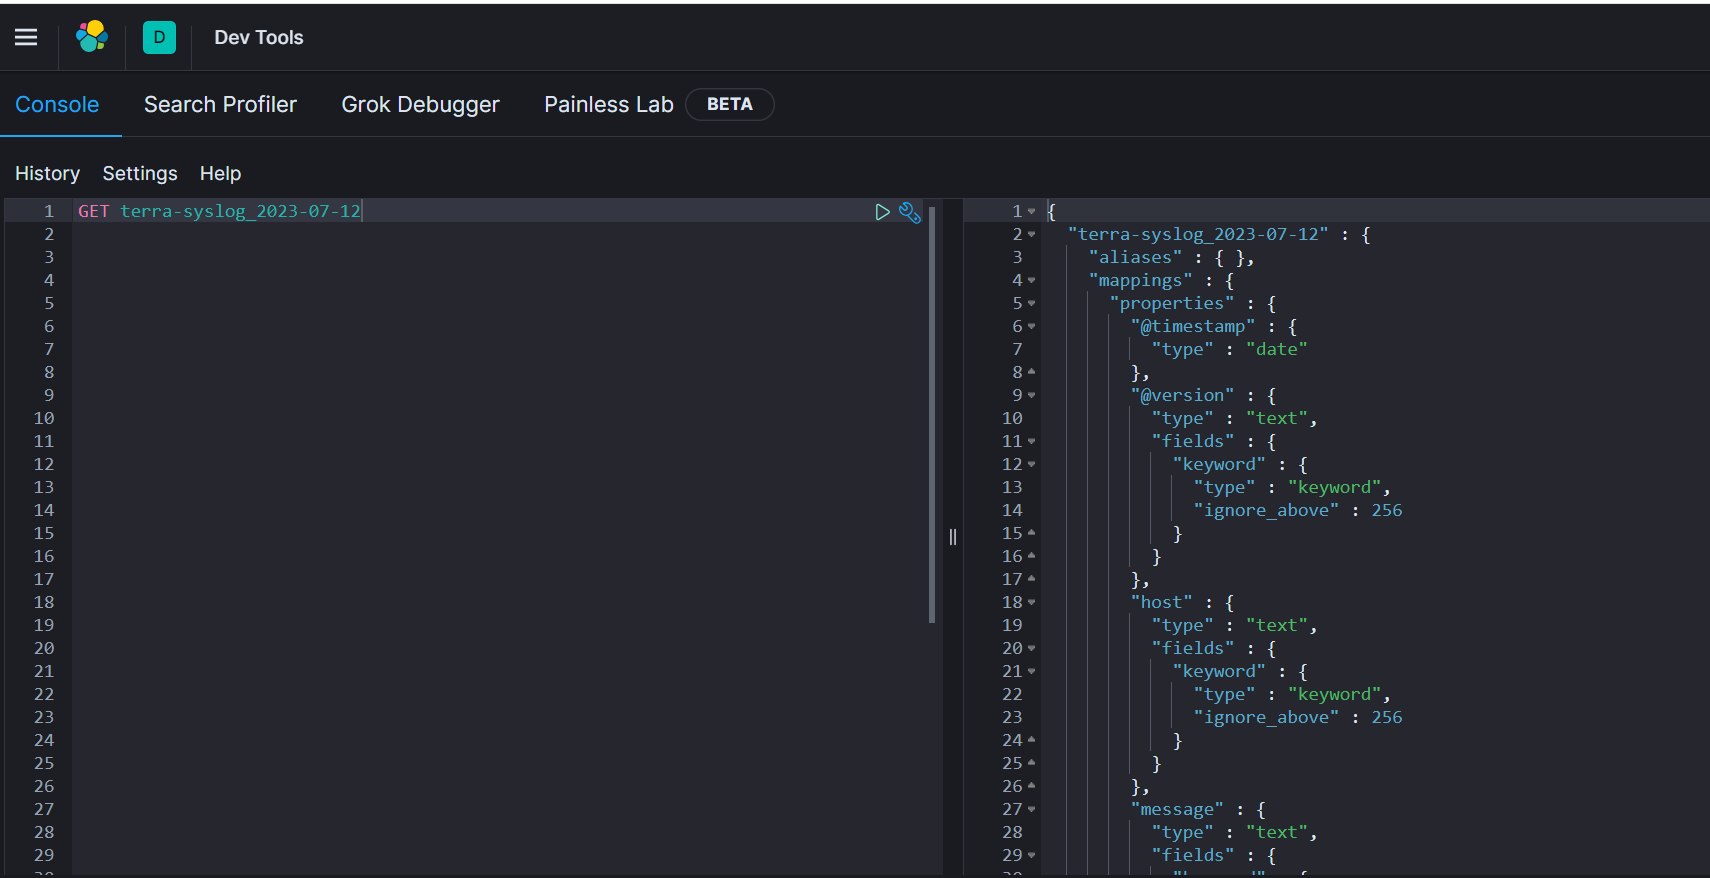
get 直接查询 索引名称时,会返回 该 索引得 mapping 和 settings 得配置,上述返回得结构如下:


{

  "terra-syslog_2023-07-12" : {

    "aliases" : { },

    "mappings" : {

      "properties" : {

        "@timestamp" : {

          "type" : "date"

        },

        "@version" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        },

        "host" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        },

        "message" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        },

        "received_at" : {

          "type" : "date"

        },

        "received_from" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        },

        "syslog_facility" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        },

        "syslog_facility_code" : {

          "type" : "long"

        },

        "syslog_hostname" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        },

        "syslog_message" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        },

        "syslog_program" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        },

        "syslog_severity" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        },

        "syslog_severity_code" : {

          "type" : "long"

        },

        "syslog_timestamp" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        },

        "tags" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        },

        "type" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        },

        "user" : {

          "type" : "text",

          "fields" : {

            "keyword" : {

              "type" : "keyword",

              "ignore_above" : 256

            }

          }

        }

      }

    },

    "settings" : {

      "index" : {

        "creation_date" : "1689137630855",

        "number_of_shards" : "1",

        "number_of_replicas" : "1",

        "uuid" : "Qew4uoNUQ9q8-JQDPTWVPw",

        "version" : {

          "created" : "7080199"

        },

        "provided_name" : "terra-syslog_2023-07-12"

      }

    }

  }

}
2. 执行复杂条件得查询:

该dsl 为:
GET terra-syslog_2023-07-15/_search

{

  "size": 0,

  "query": {

    "bool": {

      "must": [

        {

          "wildcard": {

            "syslog_program.keyword": {

              "wildcard": "*SSH_USER_LOGIN*",

              "boost": 1

            }

          }

        }

      ],

      "adjust_pure_negative": true,

      "boost": 1

    }

  },

  "aggregations": {

    "time_agg": {

      "date_histogram": {

        "field": "received_at",

        "format": "EEE",

        "fixed_interval": "1d",

        "offset": 0,

        "order": {

          "_key": "asc"

        },

        "keyed": false,

        "min_doc_count": 0

      },

      "aggregations": {

        "user_agg": {

          "terms": {

            "field": "user.keyword",

            "size": 10,

            "min_doc_count": 1,

            "shard_min_doc_count": 0,

            "show_term_doc_count_error": false,

            "order": [

              {

                "_count": "desc"

              },

              {

                "_key": "asc"

              }

            ]

          }

        }

      }

    }

  }

}
这段 DSL 具有以下作用:
"size": 0: 设置返回的结果集大小为 0,即只返回聚合结果,不返回匹配的文档。query部分:构建了一个布尔查询,包含多个exists和range子查询,用于过滤符合条件的文档。exists子查询检查指定字段是否存在,这里依次检查了source.ip、source.port、destination.ip、destination.port、host.name和flow.rep_tags字段的存在。range子查询指定了对@timestamp字段进行范围筛选,从给定的时间戳范围中选择满足条件的文档。
aggregations部分:定义了聚合操作,通过terms聚合按照host.name字段进行分组,并计算每个组内的文档数。terms聚合将按照host.name字段的值进行分组。设置size为最大整数2147483647,以确保返回所有分组。min_doc_count设置为 1,表示只返回至少拥有一个文档的分组。shard_min_doc_count设置为 0,表示在单个分片上没有要求文档数量的最小要求。show_term_doc_count_error设置为 false,不显示术语文档计数错误。order指定了排序规则,首先按照分组中的文档数_count降序排序,然后按照host.name字段的值升序排序。在
terms聚合内部定义了一个子聚合cardinality,用于计算每个分组内唯一组合的数量。这里通过拼接source.ip、source.port、destination.ip和destination.port字段的值来作为唯一标识。
该 DSL 查询的作用是在给定时间范围内,统计满足一系列条件(存在指定字段)的文档,并按照 host.name 进行分组并计算每个组内唯一组合的数量。
另外,在查询时,使用 _search 可以执行DSL, 如果没有_search 时,可以查询该索引得文档结构类型,以及该索引得副本、分片等信息
3.修改 该 索引得 mapping 中得字段类型
将前面的映射中的 syslog_timestamp 字段类型修改为日期类型(date),需要更新映射定义并重新创建索引。
删除现有的索引,或者创建一个新的索引。
更新映射定义,将
syslog_timestamp的类型更改为 "date"。以下是更新后的映射示例:
{

  "mappings": {

    "_doc": {

      "properties": {

        // 其他字段...

        "syslog_timestamp": {

          "type": "date"

        },

        // 其他字段...

      }

    }

  }

}
- 使用上述修改后的映射定义来创建索引或更新现有索引的映射。可以使用 Elasticsearch 的 RESTful API 或管理工具(如 Kibana Console)执行以下请求:
PUT terra-syslog_2023-07-15

{

  "mappings": {

    "_doc": {

      "properties": {

        // 其他字段...

        "syslog_timestamp": {

          "type": "date"

        },

        // 其他字段...

      }

    }

  }

}
这样,syslog_timestamp 字段的类型就会被修改为日期类型,并可以存储、索引和查询日期值。根据数据的格式和需求,Elasticsearch 会自动解析日期字符串并将其转换为适当的日期对象。
ES 实战复杂sql查询、修改字段类型的更多相关文章
- Oracle使用SQL语句修改字段类型
Oracle使用SQL语句修改字段类型 1.如果表中没有数据 Sql代码 1 2 3 alter table 表名 modify (字段名1 类型,字段名2 类型,字段名3 类型.....) alt ...
- SQL语句修改字段类型与第一次SQLServer试验解答
SQL语句修改字段类型 mysql中 alert table name modify column name type; 例子:修改user表中的name属性类型为varchar(50) alert ...
- sql语句修改字段类型和增加字段
/*修改字段类型*/ ) go /*增加字段和说明*/ ) EXECUTE sp_addextendedproperty N'MS_Description','说明文字',N'user',N'dbo' ...
- 修改SQL数据库中表字段类型时,报“一个或多个对象访问此列”错误的解决方法
在SQL数据库中使用SQL语句(格式:alter table [tablename] alter column [colname] [newDataType])修改某表的字段类型时,报一下错误:由于一 ...
- sqlServer 2008修改字段类型和重命名字段名称的sql语句
sqlServer 2008修改字段类型和重命名字段名称的sql语句 //修改字段的类型 alter table fdi_news alter column c_author nvarchar(50) ...
- Oracle/SQL 修改字段类型和长度
标准SQL修改字段类型和长度语句: ALTER TABLE tableName modify column columnName 类型;例如Mysql的修改字段类型语句:alter table tes ...
- 使用SQL修改字段类型
修改字段类型步骤: 1.首先需要检查字段约束 2.删除字段约束 3.修改字段类型 4.加上字段约束 --不加这个条件,库中所有默认约束都可以看到 SELECT a.name AS DFName , ...
- SQL Server 添加字段,修改字段类型,修改字段名,删除字段
-- 1.添加字段-- 基本语法alter table 表 add 列名 字段类型 null-- 例:给学生表添加Telephone字段并指定类型为vachar,长度为50,可空alter table ...
- sql语句修改字段长度
sql语句修改字段长度 alter table <表名> alter column <字段名> 新类型名(长度) 例: alter table students alter c ...
- oracle如何修改字段类型(oracle总体知识2)
在一次做开发的时候,遇到需要将数据表的字段类型由number改成varchar,可是该字段又有值, 用 alter table t-name modify cname newType;会报错. 话说 ...
随机推荐
- Django相关配置信息
Django相关配置信息 1.配置数据库mysql 1.1 setting.py中配置信息 DATABASES = { 'default': { 'ENGINE': 'django.db.backen ...
- CSS3实现了左右固定中间自适应的几种方法
1,弹性盒(flex)布局 中间 .center 区域设置 flex-grow: 1 或者 width: 100% .container { width: 100%; min-height: 2 ...
- [Opencv-C++] 3. opencv数据类型
文章目录 Point类 cv::Scalar类 size类 cv::Rect类 cv::RotatedRect类 固定矩阵类 固定向量类 复数类 工具函数 模板结构 Point类 在大多数程序中,Po ...
- ChatGPT最全提示词Prompts总结,看这一篇就够了!
以下几乎涵盖了各类人群想要使用ChatGPT的所有提示词,需要的朋友可以直接复制粘贴使用. 从翻译到整理耗费超过2个小时,如果内容对大家有帮助,请不要吝啬你们的喜欢.点赞.关注~ 如何正确的提问? ...
- 自创简易CSS Tab 选项卡
前段时间我注册了 w3c.run域名,打算做一个W3C相关技术在线试验工具.没错,就是在线编写html.css.js代码然后在线运行,查看效果. 在设计首页时,我打算首页提供三个代码编辑器,介于界面大 ...
- Java设计模式简介(总结)
Java设计模式简介(总结) 什么是设计模式 Java设计模式是一组经过验证的解决特定问题的编程技术,这些技术可以帮助开发人员快速.有效地开发高质量的软件.使用设计模式是为了可重用代码.让代码更容易被 ...
- 2022-04-04:k8s中kubectl源码用到了哪些设计模式?除了工厂和单例。
2022-04-04:k8s中kubectl源码用到了哪些设计模式?除了工厂和单例. 答案2022-04-04: 1.建造者模式.resource.Builder.D:\go_path\src\git ...
- 2022-01-25:序列化和反序列化 N 叉树。 序列化是指将一个数据结构转化为位序列的过程,因此可以将其存储在文件中或内存缓冲区中,以便稍后在相同或不同的计算机环境中恢复结构。 设计一个序列化和反
2022-01-25:序列化和反序列化 N 叉树. 序列化是指将一个数据结构转化为位序列的过程,因此可以将其存储在文件中或内存缓冲区中,以便稍后在相同或不同的计算机环境中恢复结构. 设计一个序列化和反 ...
- 2021-12-31:给定一个arr,里面的数字都是0~9, 你可以随意使用arr中的数字,哪怕打乱顺序也行, 请拼出一个能被3整除的,最大的数字,用str形式返回。 来自去哪儿网。
2021-12-31:给定一个arr,里面的数字都是0~9, 你可以随意使用arr中的数字,哪怕打乱顺序也行, 请拼出一个能被3整除的,最大的数字,用str形式返回. 来自去哪儿网. 答案2021-1 ...
- 常用设计模式之.Net示例代码合集
每一次初学者粉丝朋友,在后台向我咨询编程问题,我除了给他们指导学习路线,我都会建议他们学完基础知识后,一定要要注重编程规范,学习设计模式,修炼内功. 虽然说很多程序员,他们日常主要工作是CRUD,但是 ...