
python爬虫 抓取一个网站的所有网址链接
作者QQ:231469242
关键字:爬虫,网址抓取,python
测试
url=http://db.yaozh.com/
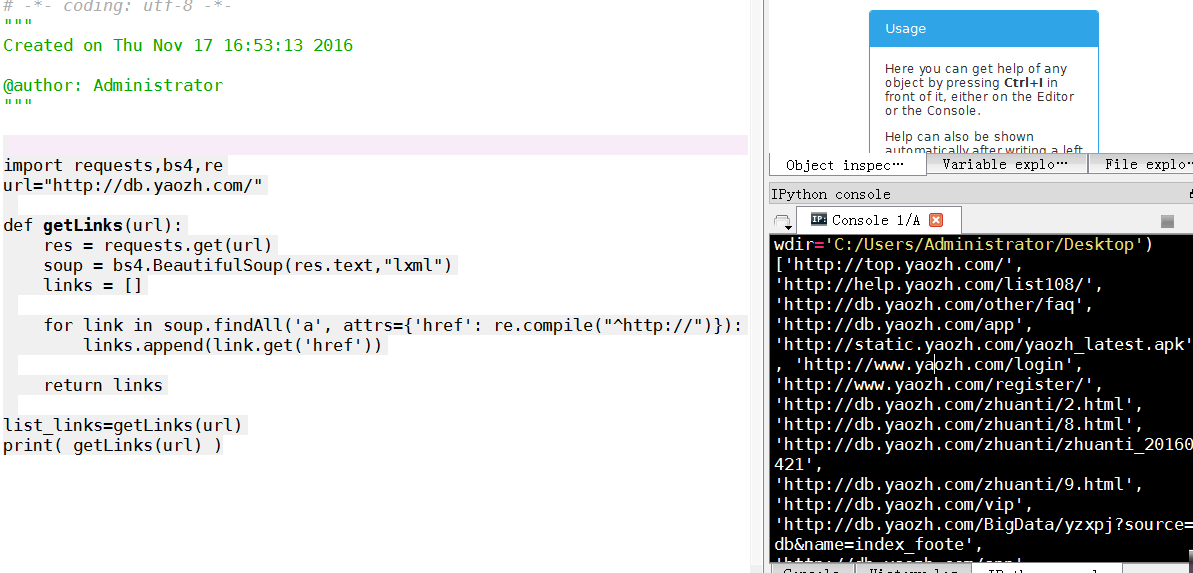
import requests,bs4,re

url="http://db.yaozh.com/"

def getLinks(url):

    res = requests.get(url)

    soup = bs4.BeautifulSoup(res.text,"lxml")

    links = []

    for link in soup.findAll('a', attrs={'href': re.compile("^http://")}):

        links.append(link.get('href'))

    return links

list_links=getLinks(url)

print( getLinks(url) )
测试
url=http://www.yaozh.com
网址共121个
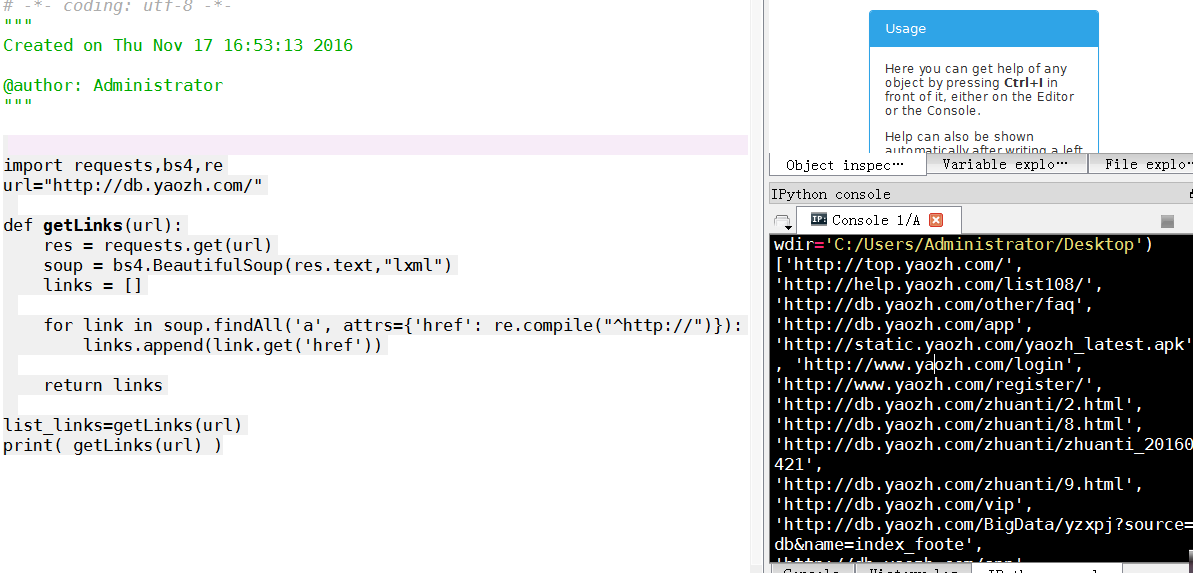
['http://db.yaozh.com', 'http://www.yaozh.com/zhihui', 'http://s.yaozh.com', 'http://news.yaozh.com', 'http://star.yaozh.com', 'http://club.yaozh.com/', 'http://edu.yaozh.com/', 'http://bbs.yaozh.com', 'http://www.35yao.com/', 'http://top.yaozh.com/', 'http://www.yaozh.com/', 'http://news.yaozh.com', 'http://db.yaozh.com', 'http://www.yaozh.com/zhihui', 'http://s.yaozh.com', 'http://bbs.yaozh.com', 'http://club.yaozh.com/', 'http://edu.yaozh.com/', 'http://star.yaozh.com/', 'http://top.yaozh.com/', 'http://db.yaozh.com/Zhuanti/zhuanti_20160721?source=www&name=index_slide', 'http://bbs.yaozh.com/thread-260886-1-1.html?source=www&name=index_slide', 'http://edu.yaozh.com/Course/84.html?source=www&name=index_slide', 'http://bbs.yaozh.com/thread-262781-1-1.html?source=www&name=index_slide', 'http://db.yaozh.com/pqf?source=www&position=index_newdb', 'http://db.yaozh.com/orangebook?source=www&position=index_newdb', 'http://db.yaozh.com/qxzhuce?source=www&position=index_newdb', 'http://db.yaozh.com/yfpw?source=www&name=index_newdb', 'http://db.yaozh.com/orangebook?source=www&name=long_banner', 'http://news.yaozh.com/Detail/index/id/16689.html', 'http://s.yaozh.com/Article/index?id=48?source=www&name=long_banner', 'http://bbs.yaozh.com/thread-262329-1-1.html?source=www&name=long_banner', 'http://bbs.yaozh.com/thread-216363-1-1.html', 'http://s.yaozh.com/3832', 'http://s.yaozh.com/3122', 'http://s.yaozh.com/1389', 'http://s.yaozh.com/1952', 'http://s.yaozh.com/4043', 'http://s.yaozh.com/4058', 'http://s.yaozh.com/3858', 'http://s.yaozh.com/1392', 'http://db.yaozh.com?source=www&name=long_banner', 'http://db.yaozh.com/app?source=www&name=db_left', 'http://news.yaozh.com/archive/12393.html', 'http://news.yaozh.com/archive/12275.html', 'http://news.yaozh.com/archive/12218.html', 'http://news.yaozh.com/archive/12138.html', 'http://news.yaozh.com/archive/11449.html', 'http://news.yaozh.com/archive/11340.html', 'http://news.yaozh.com/archive/11026.html', 'http://news.yaozh.com/archive/10433.html', 'http://news.yaozh.com/archive/10219.html', 'http://news.yaozh.com/archive/10206.html', 'http://news.yaozh.com/archive/9732.html', 'http://news.yaozh.com/archive/9648.html', 'http://news.yaozh.com/archive/9373.html', 'http://news.yaozh.com/archive/9279.html', 'http://news.yaozh.com/archive/8806.html', 'http://news.yaozh.com/archive/8479.html', 'http://news.yaozh.com/archive/8480.html', 'http://news.yaozh.com/archive/7897.html', 'http://news.yaozh.com/archive/7898.html', 'http://news.yaozh.com/archive/7899.html', 'http://db.yaozh.com/zhuangrang?from=www&position=index_hotdb', 'http://db.yaozh.com/zhuce?from=www&position=index_hotdb', 'http://db.yaozh.com/yaopinzhongbiao?from=www&position=index_hotdb', 'http://db.yaozh.com/index.php?action=foreign?from=www&position=index_hotdb', 'http://db.yaozh.com/screening?from=www&position=index_hotdb', 'http://db.yaozh.com/jiegou?from=www&position=index_hotdb', 'http://db.yaozh.com/vip/custom.html?source=www&name=db_right', 'http://www.xinyaohui.com', 'http://www.cqyjs.com/index.html', 'http://www.reed-sinopharm.com/', 'http://www.bucm.edu.cn', 'http://pharmacy.scu.edu.cn/', 'http://www.cqmu.edu.cn/', 'http://www.cqacmm.com/', 'http://www.cpri.com.cn/', 'http://www.cpu.edu.cn/', 'http://pharmacy.swu.edu.cn', 'http://www.mypharma.com', 'http://www.psyzg.com/', 'http://www.viptijian.com/0592', 'http://www.7lk.com/', 'http://www.j1.com/pd-baojianpin.html', 'http://www.3156.cn/', 'http://www.sdyyzs.cn', 'http://www.jiankangle.com', 'http://www.rmttjkw.com', 'http://www.sunyet.com', 'http://www.chinayikao.com/', 'http://www.hxyjw.com/ ', 'http://www.100xhs.com/ask/ ', 'http://www.360zhengrong.com/', 'http://www.ftxk.cn/', 'http://www.jianke.com/zypd/', 'http://www.medlive.cn/', 'http://health.qqyy.com/', 'http://www.wendaifu.com/', 'http://health.cqnews.net/', 'http://www.yaofu.cn/', 'http://www.ipathology.cn/', 'http://nk.99.com.cn/', 'http://www.baxsun.cn/', 'http://www.yiliu88.com ', 'http://www.wiki8.com/', 'http://www.39kf.com/', 'http://www.10000yao.com', 'http://www.3618med.com', 'http://www.chem960.com', 'http://www.yaojobs.com', 'http://www.hc3i.cn/', 'http://about.yaozh.com/about.html', 'http://about.yaozh.com/contact.html', 'http://about.yaozh.com/Qualification.html', 'http://about.yaozh.com/join.html', 'http://about.yaozh.com/link.html', 'http://help.yaozh.com/', 'http://bbs.yaozh.com/forum-123-1.html', 'http://bbs.yaozh.com', 'http://www.beian.gov.cn/portal/registerSystemInfo?recordcode=50010802001068']
测试3
url=http://www.dxy.cn/
丁香园网址链接是501个
测试4
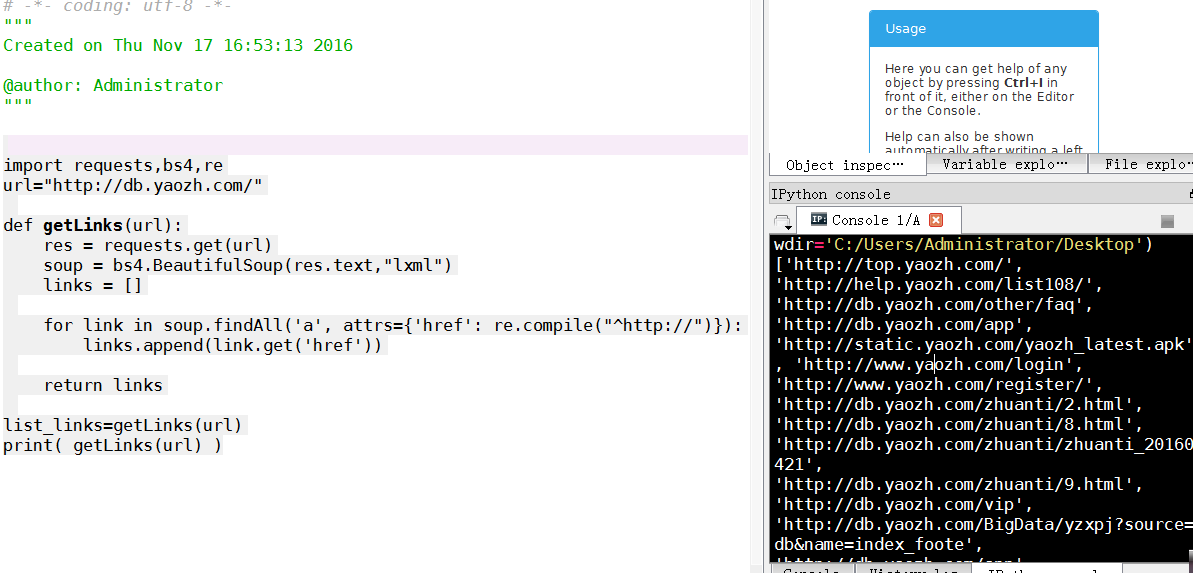
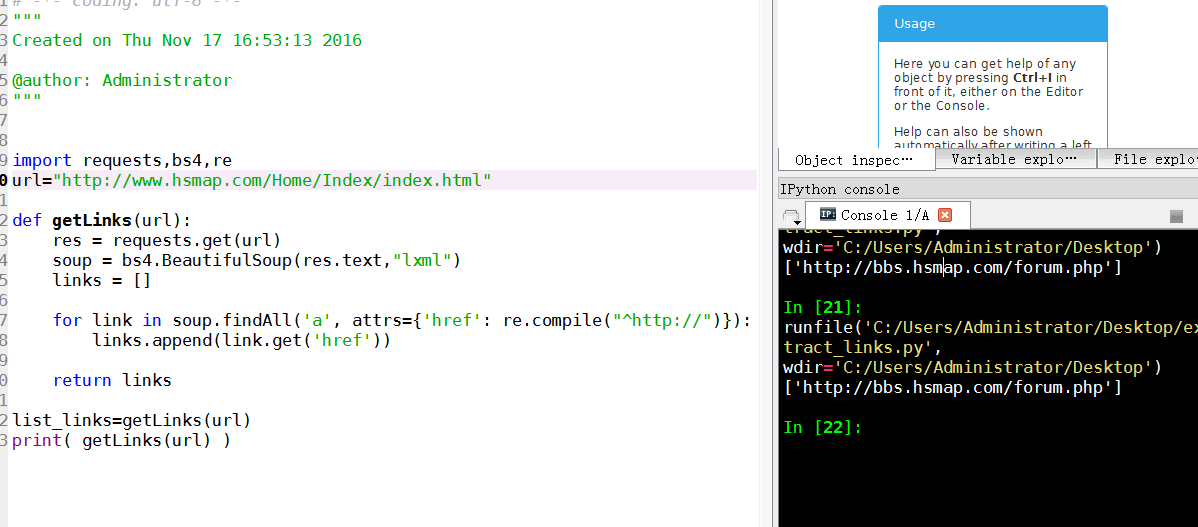
url=http://www.hsmap.com
只有一个链接
python爬虫 抓取一个网站的所有网址链接的更多相关文章
- Python 爬虫-抓取中小企业股份转让系统公司公告的链接并下载
系统运行系统:MAC 用到的python库:selenium.phantomjs等 由于中小企业股份转让系统网页使用了javasvript,无法用传统的requests.BeautifulSoup库获 ...
- python 爬虫抓取心得
quanwei9958 转自 python 爬虫抓取心得分享 urllib.quote('要编码的字符串') 如果你要在url请求里面放入中文,对相应的中文进行编码的话,可以用: urllib.quo ...
- Python爬虫----抓取豆瓣电影Top250
有了上次利用python爬虫抓取糗事百科的经验,这次自己动手写了个爬虫抓取豆瓣电影Top250的简要信息. 1.观察url 首先观察一下网址的结构 http://movie.douban.com/to ...
- Python爬虫抓取东方财富网股票数据并实现MySQL数据库存储
Python爬虫可以说是好玩又好用了.现想利用Python爬取网页股票数据保存到本地csv数据文件中,同时想把股票数据保存到MySQL数据库中.需求有了,剩下的就是实现了. 在开始之前,保证已经安装好 ...
- python爬虫抓取哈尔滨天气信息(静态爬虫)
python 爬虫 爬取哈尔滨天气信息 - http://www.weather.com.cn/weather/101050101.shtml 环境: windows7 python3.4(pip i ...
- Python爬虫抓取某音乐网站MP3(下载歌曲、存入Sqlite)
最近右胳膊受伤,打了石膏在家休息.为了实现之前的想法,就用左手打字.写代码,查资料完成了这个资源小爬虫.网页爬虫, 最主要的是协议分析(必须要弄清楚自己的目的),另外就是要考虑对爬取的数据归类,存储. ...
- Python 爬虫: 抓取花瓣网图片
接触Python也好长时间了,一直没什么机会使用,没有机会那就自己创造机会!呐,就先从爬虫开始吧,抓点美女图片下来. 废话不多说了,讲讲我是怎么做的. 1. 分析网站 想要下载图片,只要知道图片的地址 ...
- Python爬虫 -- 抓取电影天堂8分以上电影
看了几天的python语法,还是应该写个东西练练手.刚好假期里面看电影,找不到很好的影片,于是有个想法,何不搞个爬虫把电影天堂里面8分以上的电影爬出来.做完花了两三个小时,撸了这么一个程序.反正蛮简单 ...
- python爬虫--爬取某网站电影下载地址
前言:因为自己还是python世界的一名小学生,还有很多路要走,所以本文以目的为向导,达到目的即可,对于那些我自己都没弄懂的原理,不做去做过多解释,以免误人子弟,大家可以网上搜索. 友情提示:本代码用 ...
随机推荐
- CS229笔记:线性回归
线性回归问题 首先做一些符号上的说明: \(x^{(i)}\):特征(feature) \(y^{(i)}\):目标变量(target variables) \(\mathcal{X}\):特征空间 ...
- Jmeter(十八)_Ubuntu部署jmeter与ant
Docker部署接口自动化持续集成环境第三步,容器化Jmeter与ant! 接上文:Docker_容器化jenkins 为了整合接口自动化的持续集成工具,我将jmeter与ant都部署在了Jenkin ...
- chrome下的Grunt插件断点调试——基于node-inspector
之前调试grunt插件时,都是通过人肉打log来调试.不仅效率低,而且会产生一堆无用的代码.于是简单google了下node断点调试的方法,总结了下. 借助node-inspector,我们可以通过C ...
- oracle创建用户和角色、管理授权以及表空间操作
show user 显示当前用户connect username/password@datebasename as sysdba 切换用户和数据库 和用户身份 Oracle登录身份有三种: norma ...
- SqlHelper DBHelper
根据自己项目的开发需要,整理了一个SqlHelper类 相比较网上通用的SqlHelper类方法主要有一下几点的不同: 1.因为要操作多个数据库,所以数据库连接字符串没有写死到方法里,作为参数提供出来 ...
- mongodb lock 出毛病时解决方法
错误信息: Error: couldn't connect to server 127.0.0.1:27017 at src/mongo/shell/mongo.js:145 解决办法: sudo r ...
- MSSQL批量写入数据方案
近来有一个项目Feature需要有批量写入数据的场景,正巧整理资料发现自己以前也类似实现的项目,在重构的同时把相关资料做了一个简单的梳理,方便大家参考. 循环写入(简单粗暴,毕业设计就这样干的)(不推 ...
- JSP JSTL知识结构图
自行绘制,欢迎指正.
- Daily Scrum NO.7
工作概况 今日由于时间比较充裕,没有编译作业的干扰,团员们的进度喜人.线程池.动态爬取.异常清理这三个主要开发工作已经步入尾声.其中线程池开发工作的代码已经签入,现主要在测试和优化.动态爬取今日也签入 ...
- VS2013新建web项目时出错,系统找不到指定文件
好不容易找了一个VS2013_RTM_ULT_CHS来安装好,Key:BWG7X-J98B3-W34RT-33B3R-JVYW9 兴高采烈的打开vs2013,新建web项目,结果弹出一个错误: 傻眼了 ...