
《SQL Server 2008从入门到精通》--20180723
1.架构
架构是一种独立于用户的逻辑分组,组中可以存储表,视图,存储过程等。假如表1在架构1中,表2在架构2中,用架构1的用户名登录时表2不可见。且未添加该架构的数据库不能被该架构的用户访问。
1.1.创建架构并在架构中创建表
执行如下语句
CREATE LOGIN hy WITH PASSWORD = '123456'

GO

--新建登录名

CREATE DATABASE schematest

GO

--新建数据库

USE schematest

GO

CREATE USER u_for_test FOR LOGIN hy

GO

CREATE SCHEMA dbo_Schema

go

--在schematest数据库下添加dbo_Schema

CREATE TABLE T1(id INT,NAME VARCHAR(20))

go

CREATE TABLE dbo_Schema.T2(Nid int,DD datetime)

go

GRANT SELECT ON SCHEMA :: dbo_Schema TO u_for_test;

--给u_for_test赋予SELECT权限

--重新使用hy登录即可。
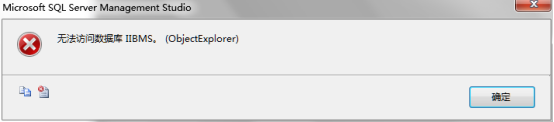
用hy登录,打开未添加dbo_Schema架构的数据库,出现如下提示
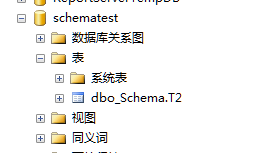
打开schematest数据库,展开表,dbo_Schema下的T2表可见,非dbo_Schema架构下的T1表不可见。
1.2.删除架构
删除架构前必须删除或者移动该架构的所有对象,不然删除操作将会失败。如执行下列语句
DROP SCHEMA dbo_Schema

GO
结果如图所示

此时要将T2表删除或者移动到其他架构才能成功删除dbo_Schema
1.3.修改表的架构
如图所示,右键表名——设计——右侧属性栏中修改表的架构

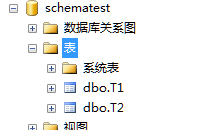
如图所示,当把T2表所引用的架构修改为dbo后,可继续删除架构dbo_Schema操作。就能成功删除dbo.Schema
2.视图
视图是数据库中原始数据的一种变换,是查看表数据的一种方式,视图是一种逻辑对象,是虚拟的表,是一串SELECT语句,并不是真实的表。
2.1.新建视图
示例1:利用student表和class_student表的数据新建视图class_01,记录01班学生详细信息
Student表的数据如图所示

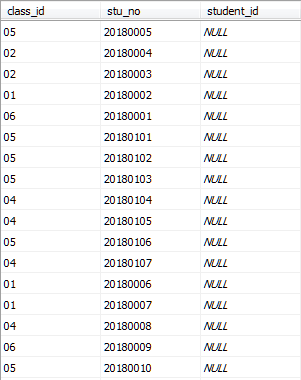
Class_student表的数据如图所示
执行下列语句新建视图class_01
CREATE VIEW class_01

AS

SELECT class_student.stu_no,class_id,stu_name,stu_sex,stu_age,stu_addr,stu_native_place,stu_birthday,stu_enter_score,stu_phone,stu_father_name,stu_mather_name

FROM class_student INNER JOIN student

ON class_student.stu_no=student.stu_no

WHERE class_id='01'
视图class_01的数据如图所示
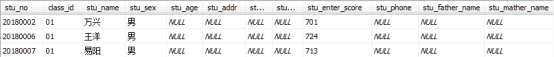
注:视图只是一个SELECT语句,数据根据基表的数据改变而自动改变。
2.2.使用视图修改数据
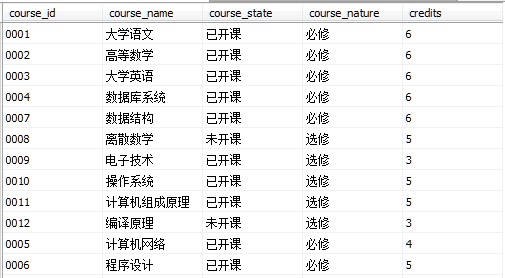
示例2:有course表数据,基于course表新建视图coursetest,列名为course_id,course_name,credits。
Course表数据如图所示
执行下列语句新建coursetest视图
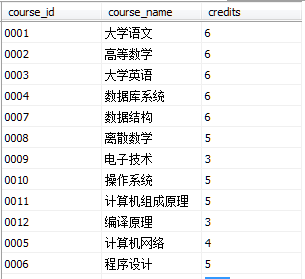
CREATE VIEW coursetest

AS

SELECT course.course_id,course_name,credits FROM course
Coursetest视图数据如图所示
在coursetest视图中插入一行course_id为“0013”的数据
INSERT INTO coursetest(course_id,course_name,credits)

VALUES('0013','嵌入式系统开发','5')
Course表数据如图所示
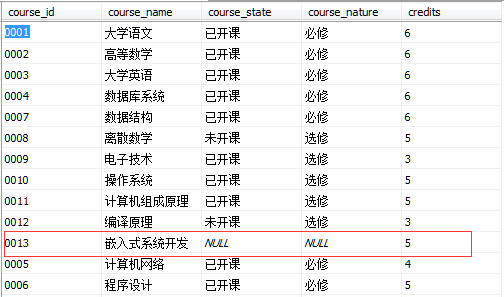
这行数据也被插入到course表中,在基于单张表的视图中可以通过增删改视图数据来更新基表数据,对基于多张表的视图不可更新。
2.3.删除视图
DROP VIEW coursetest
3.索引
3.1.聚集索引
聚集索引数据按照索引的顺序排序,查询速度比非聚集索引快。当插入数据时,按索引顺序对数据重新排序。打个比方,新华字典中按拼音查字就是聚集索引,找到了矮字就能按顺序查下去找到爱字。一个表只能有1个聚集索引
如果一个表在创建主键时没有聚集索引也没指定唯一非聚集索引,会对PRIMARY KEY字段自动创建聚集索引
3.2.非聚集索引
非聚集索引不按照索引顺序排序,制定了表中数据的逻辑顺序,采用指针指向数据页的形式。一个表可以拥有多个非聚集索引。打个比方,新华字典中按笔画查字就是非聚集索引,笔画索引顺序和字的顺序不一致,依靠指针来指向数据页。
3.3.创建索引
示例3:设置IndexDemo1表的id字段为PRIMARY KEY,看系统是否自动为该字段创建了聚集索引。执行下列语句
CREATE DATABASE IndexDemo

USE IndexDemo

CREATE TABLE IndexDemo1(

id INT NOT NULL,

A CHAR(10),

B VARCHAR(10),

CONSTRAINT PK_id PRIMARY KEY(id)

)
结果如图所示
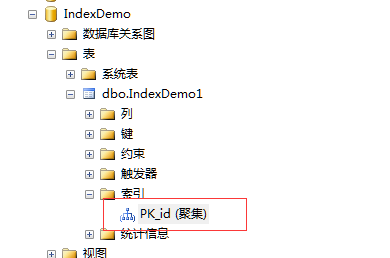
聚集索引以PRIMARY KEY的键名为索引名。
执行下列语句删除PRIMARY KEY
ALTER TABLE IndexDemo1

DROP CONSTRAINT PK_id
聚集索引PK_id也同时被删除了。
示例4:在示例3的IndexDemo1表中,插入几行数据,添加聚集索引,观察数据顺序,添加非聚集索引,观察数据顺序
IndexDemo1的数据如图所示(未添加索引)
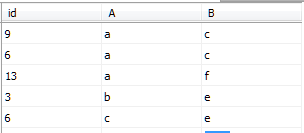
执行下列语句,为id列添加聚集索引
CREATE CLUSTERED INDEX clustered_index ON IndexDemo1(id)
添加聚集索引clustered_index后IndexDemo1表的数据如图所示
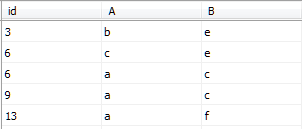
可以发现,表中数据按照id列从小到大进行排序。
此时在表中插入一条数据
INSERT INTO IndexDemo1(id,A,B)VALUES('7','g','f')
表中数据排序如图所示
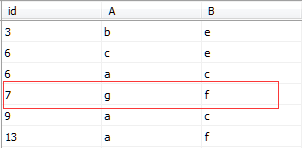
执行下列代码删除聚集索引clustered_index并对id列创建非聚集索引nonclustered_index
DROP INDEX IndexDemo1.clustered_index

GO--删除聚集索引clustered_index

CREATE NONCLUSTERED INDEX nonclustered_index ON IndexDemo1(id)

GO--创建非聚集索引nonclustered_index
表中的数据如图所示
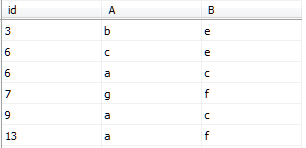
此时添加一条记录
INSERT INTO IndexDemo1(id,A,B)VALUES('8','g','f')
表中的数据如图所示
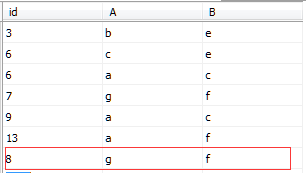
在未创建聚集索引,创建了非聚集索引的表中新插入的数据是添加在末行的。
3.4.修改索引
当数据更改时,有必要重新生成索引,重新组织索引或者禁止索引。
- 重新生成索引表示删除索引,并且重新创建索引。这样可以根据指定的填充度压缩页来删除碎片,回收磁盘空间,重新排序索引。
- 重新组织索引对索引碎片的整理程度低于重新生成索引。
- 禁止索引表示禁止用户访问索引。
示例5:对IndexDemo1表中的id列重新生成索引,重新组织索引和禁止索引。
执行下列语句
ALTER INDEX nonclustered_index ON IndexDemo1 REBUILD

--重新生成索引

ALTER INDEX nonclustered_index ON IndexDemo1 REORGANIZE

--重新组织索引

ALTER INDEX nonclustered_index ON IndexDemo1 DISABLE

--禁用索引
注:禁用索引后重新启用索引,只需重新生成索引就可以了。
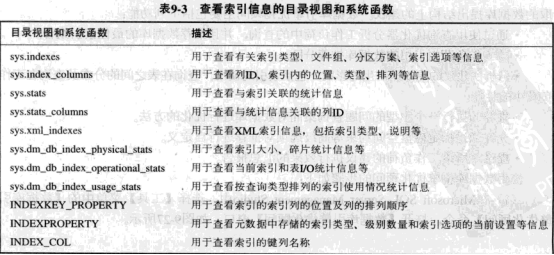
3.5.查看索引
可以利用目录视图和系统函数查看索引。这样的函数有很多,不一一列举了。
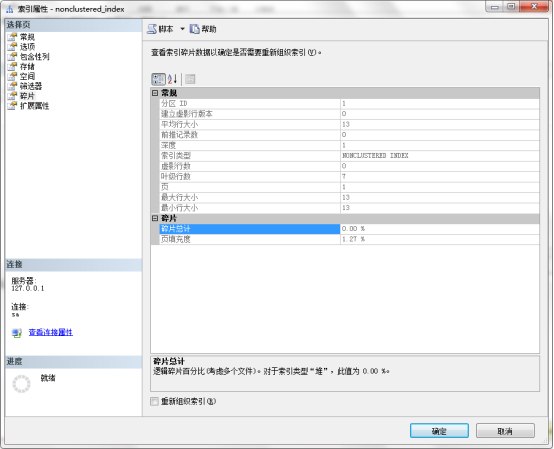
3.6.查看索引碎片
右键索引名,在属性——碎片中查看碎片
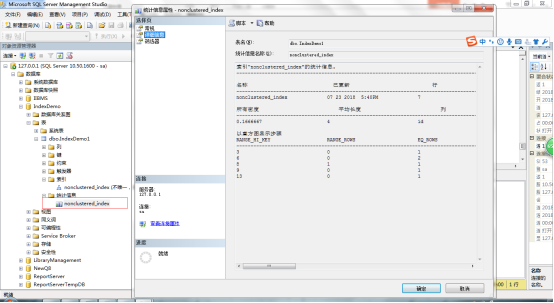
3.7.查看统计信息
在表下的统计信息中,右键点击要查看统计信息的索引名,点击详细信息
《SQL Server 2008从入门到精通》--20180723的更多相关文章
- 《SQL Server 2008从入门到精通》--20180724
目录 1.事务 1.1.事务的ACID属性 1.2.事务分类 1.2.1.系统提供的事务 1.2.2.用户自定义的事务 1.3.管理事务 1.3.1.SAVE TRANSACTION 1.3.2.@@ ...
- 《SQL Server 2008从入门到精通》--20180717
目录 1.触发器 1.1.DDL触发器 1.2.DML触发器 1.3.创建触发器 1.3.1.创建DML触发器 1.3.2.创建DDL触发器 1.3.3.嵌套触发器 1.3.4.递归触发器 1.4.管 ...
- 《SQL Server 2008从入门到精通》--20180716
1.锁 当多个用户同时对同一个数据进行修改时会产生并发问题,使用事务就可以解决这个问题.但是为了防止其他用户修改另一个还没完成的事务中的数据,就需要在事务中用到锁. SQL Server 2008提供 ...
- 《SQL Server 2008从入门到精通》--20180710
目录 1.使用Transact-SQL语言编程 1.1.数据定义语言DDL 1.2.数据操纵语言DML 1.3.数据控制语言DCL 1.4.Transact-SQL语言基础 2.运算符 2.1.算数运 ...
- 《SQL Server 2008从入门到精通》--20180704
XML查询技术 XML文档以一个纯文本的形式存在,主要用于数据存储.不但方便用户读取和使用,而且使修改和维护变得更容易. XML数据类型 XML是SQL Server中内置的数据类型,可用于SQL语句 ...
- 《SQL Server 2008从入门到精通》--20180703
SELECT操作多表数据 关于连接的问题,在<SQL必知必会>学习笔记中已经讲到过,但是没有掌握完全,所以再学一下. JOIN连接 首先我们先来看一下最简单的连接.Products表和Ve ...
- 《SQL Server 2008从入门到精通》--20180628
数据库基本概念:区.页.行 区:SQL Server中管理空间的基本单位.一个区大小为64KB,是八个物理上连续的页.SQL Server中每MB有16个区.一旦一个区被存储满,SQL Server将 ...
- 《SQL Server 2008从入门到精通》20180627
数据库范式理论 范式理论是为了建立冗余较小结构合理的数据库所遵循的规则.关系数据库中的关系必须满足不同的范式.目前关系数据库有六种范式:第一范式(1NF).第二范式(2NF).第三范式(3NF).BC ...
- 《SQL Server 2008从入门到精通》--20180629
约束 主关键字约束(Primary Key Constraint) 用来指定表中的一列或几列组合的值在表中具有唯一性.建立主键的目的是让外键来引用. Primary Key的创建方式 在创建表时创建P ...
随机推荐
- 如何让你的网站用上免费的HTTPS
因为之前网站上被注入了广告,再百般尝试之后最后还是使用了HTTPS解决了. 在实现HTTPS的时候最关键的就是证书. 证书的质量觉得了你被多少浏览器所信任. 证书的价格也就蹭蹭蹭往上涨了. 这里推荐一 ...
- Chapter 2 Open Book——26
"Oh." He let it drop. I looked away awkwardly. 哦,他让它走了.我笨拙的看向别处. “哦.”他不再纠缠于这个问题.我笨拙地移开视线. ...
- docker-使用ali云加速
ali专用网络加速地址; https://yq.aliyun.com/articles/29941 使用ali加速 vim /etc/sysconfig/docker 添加: ADD_REGISTRY ...
- gitlab的md文件内使用锚点
markdown中使用锚点的格式: [要显示的内容](#锚点的链接) 如: [工具](#tool) 又因为再markdown中每一个标题都默认是锚点,所以事情就简单了 # test ## conten ...
- CentOS Basic XLib functionality test failed!
在CentOS上安装个Qt库时,下好源代码之后执行: ./configure检查环境时,出现: Basic XLib functionality test failed! You might need ...
- webpack+react多页面开发(二)-终极架构
webpack4+react16多页面架构 webpack在单页面打包上应用广泛,以create-react-app为首的脚手架众多,单页面打包通常指的是将业务js,css打包到同一个html文件中, ...
- Linux中用HttpWebRequest或WebClient访问远程https路径
要想在Linux中用HttpWebRequest或WebClient访问远程https路径,需要作如下处理: 1,更新linux根证书(只需一次,在安装mono或安装jexus独立版后执行) sudo ...
- 出现HTTP 错误 404.0 - Not Found的解决方法
1.修改配置文件<system.webServer><modules runAllManagedModulesForAllRequests="true" /> ...
- 24.Linux-Nand Flash驱动(分析MTD层并制作NAND驱动)
1.本节使用的nand flash型号为K9F2G08U0M,它的命令如下: 1.1我们以上图的read id(读ID)为例,它的时序图如下: 首先需要使能CE片选 1)使能CLE 2)发送0X90命 ...
- mongodb命令(持续更新)
$lt $lte $gt $gte< . <= . > . >= 1.分组求和db.collection.aggregate([{$group : {_id : null, s ...