
Hadoop(一)Hadoop核心架构与安装
Hadoop是什么
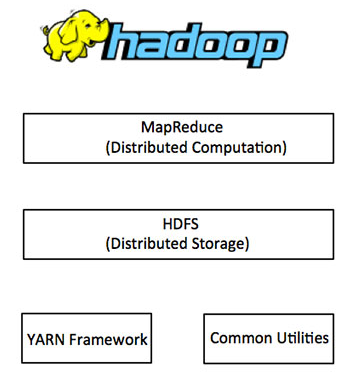
大白话,Hadoop是个存储数据,计算数据的分布式框架。核心组件是HDFS、MapReduce、Yarn。
HDFS:分布式存储
MapReduce:分布式计算
Yarn:调度MapReduce
现在为止我们知道了HDFS、MapReduce、Yarn是干啥的,下面通过一张图再来看看他的整体架构。
HDFS
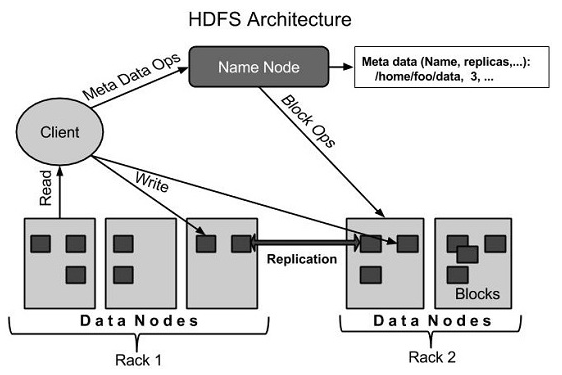
HDFS是Hadoop的存储系统,将庞大的数据存储在多台机器上,并通过数据副本冗余实现容错。HDFS两大核心组件是NameNode与DataNode。
NameNode:管理文件命名空间元数据;实现文件命名、打开关闭操作
SecondaryNameNode:帮助NameNode实现log与数据快照的合并
DataNode:根据客户请求实现文件的读写
MapReduce
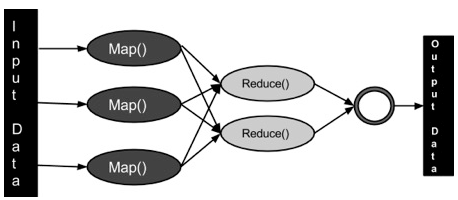
MapReduce是基于Java开发的分布式计算。包含重要的两部分,Map和Reduce。
Map:将数据转成键值对
Reduce:将Map的输出数据聚合减少
Yarn
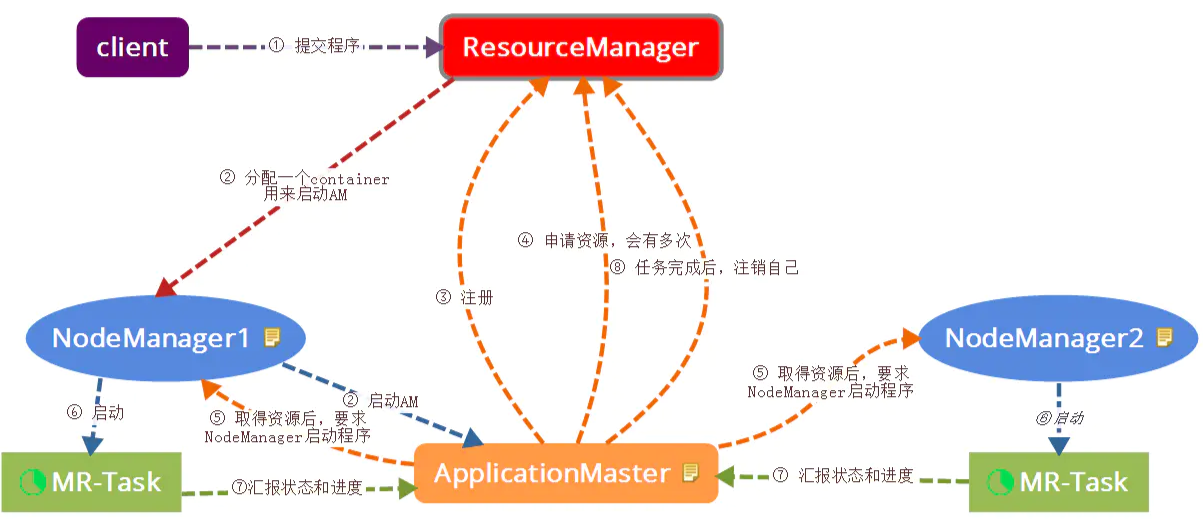
通过对集群资源的监控,调度MapReduce的任务。核心组件有ResourceManager、NodeManager、ApplicationMaster 和 Container。
ResourceManager:处理客户端请求;监控NodeManager与ApplicationMaster;调度资源。
NodeManager:管理节点资源;与ResourceManager ApplicationMaster交互。
ApplicationMaster:为程序申请资源并将资源分配给任务;任务监控。
安装Hadoop
1.安装Jdk
下载https://www.oracle.com/java/technologies/downloads/
解压
tar -zxvf jdk-8u331-linux-x64.tar.gz
加入环境变量
vi /etc/profile

#加入以下内容

JAVA_HOME=/usr/local/java18/jdk1.8.0_331

JRE_HOME=$JAVA_HOME/jre

PATH=$PATH:$JAVA_HOME/bin:$JRE_HOME/bin

CLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar:$JRE_HOME/lib

export JAVA_HOME JRE_HOME PATH CLASSPATH

//生效

source  /etc/profile
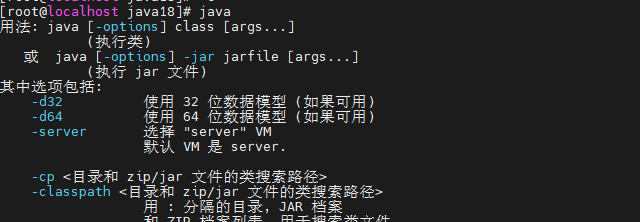
验证java
2.安装伪分布式Hadoop
下载https://www.apache.org/dyn/closer.cgi/hadoop/common/hadoop-3.2.3/hadoop-3.2.3.tar.gz
解压
tar xzf hadoop-3.2.3.tar.gz
配置本机ssh
ssh-keygen -t rsa -P '' -f ~/.ssh/id_rsa

cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys

chmod 0600 ~/.ssh/authorized_keys
配置Hadoop环境变量
cat etc/hadoop/hadoop-env.sh


export JAVA_HOME=/usr/local/java/jdk1.8
配置hdfs地址
cat etc/hadoop/core-site.xml

    <property>

        <name>fs.defaultFS</name>

        <value>hdfs://localhost:9000</value>

    </property>
配置hafs分片数
cat etc/hadoop/hdfs-site.xml


    <property>

        <name>dfs.replication</name>

        <value>1</value>

    </property>
export HADOOP_HOME=/usr/local/hadoop/hadoop-3.2.3

export HADOOP_MAPRED_HOME=$HADOOP_HOME

export HADOOP_COMMON_HOME=$HADOOP_HOME

export HADOOP_HDFS_HOME=$HADOOP_HOME

export YARN_HOME=$HADOOP_HOME

export HADOOP_COMMON_LIB_NATIVE_DIR=$HADOOP_HOME/lib/native

export PATH=$PATH:$HADOOP_HOME/sbin:$HADOOP_HOME/bin

export HADOOP_INSTALL=$HADOOP_HOME

export HADOOP_CLASSPATH=${JAVA_HOME}/lib/tools.jar

//生效

source /etc/profile
配置mapreduce
vi etc/hadoop/mapred-site.xml

<configuration>

    <property>

        <name>mapreduce.framework.name</name>

        <value>yarn</value>

    </property>

    <property>

        <name>mapreduce.application.classpath</name>

        <value>$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/*:$HADOOP_MAPRED_HOME/share/hadoop/mapreduce/lib/*</value>

    </property>

</configuration>
配置yarn
vi etc/hadoop/yarn-site.xml

<configuration>

    <property>

        <name>yarn.nodemanager.aux-services</name>

        <value>mapreduce_shuffle</value>

    </property>

    <property>

        <name>yarn.nodemanager.env-whitelist</name>

        <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_HOME,PATH,LANG,TZ,HADOOP_MAPRED_HOME</value>

    </property>

</configuration>
配置相关user
//将sbin/start-dfs.sh,sbin/stop-dfs.sh两个文件顶部添加以下参数

HDFS_DATANODE_USER=root

HADOOP_SECURE_DN_USER=hdfs

HDFS_NAMENODE_USER=root

HDFS_SECONDARYNAMENODE_USER=root

//将sbin/start-yarn.sh,sbin/stop-yarn.sh顶部也需添加以下

YARN_RESOURCEMANAGER_USER=root

HADOOP_SECURE_DN_USER=yarn

YARN_NODEMANAGER_USER=root
初始化hdfs
bin/hdfs namenode -format
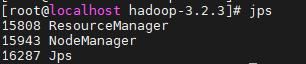
启动yarn
sbin/start-yarn.sh
通过jps查看启动的进程
启动hdfs
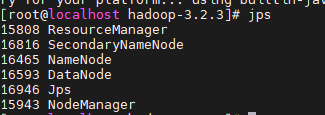
sbin/start-dfs.sh
通过jps查看进程
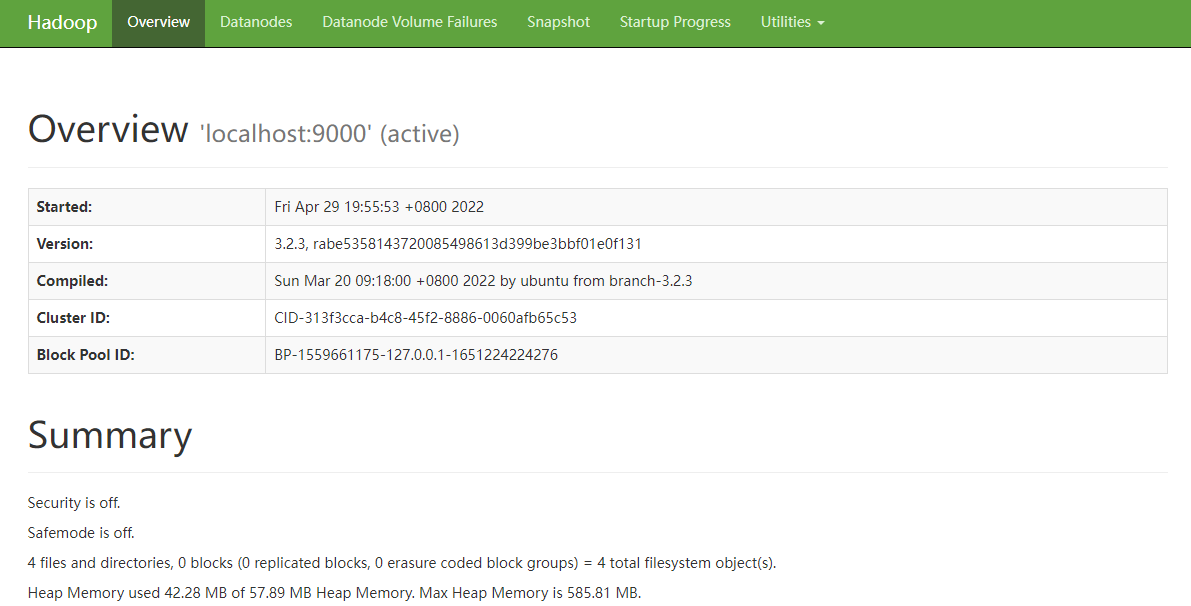
访问hadoopui验证安装是否成功
http://192.168.43.50:9870/dfshealth.html#tab-overview
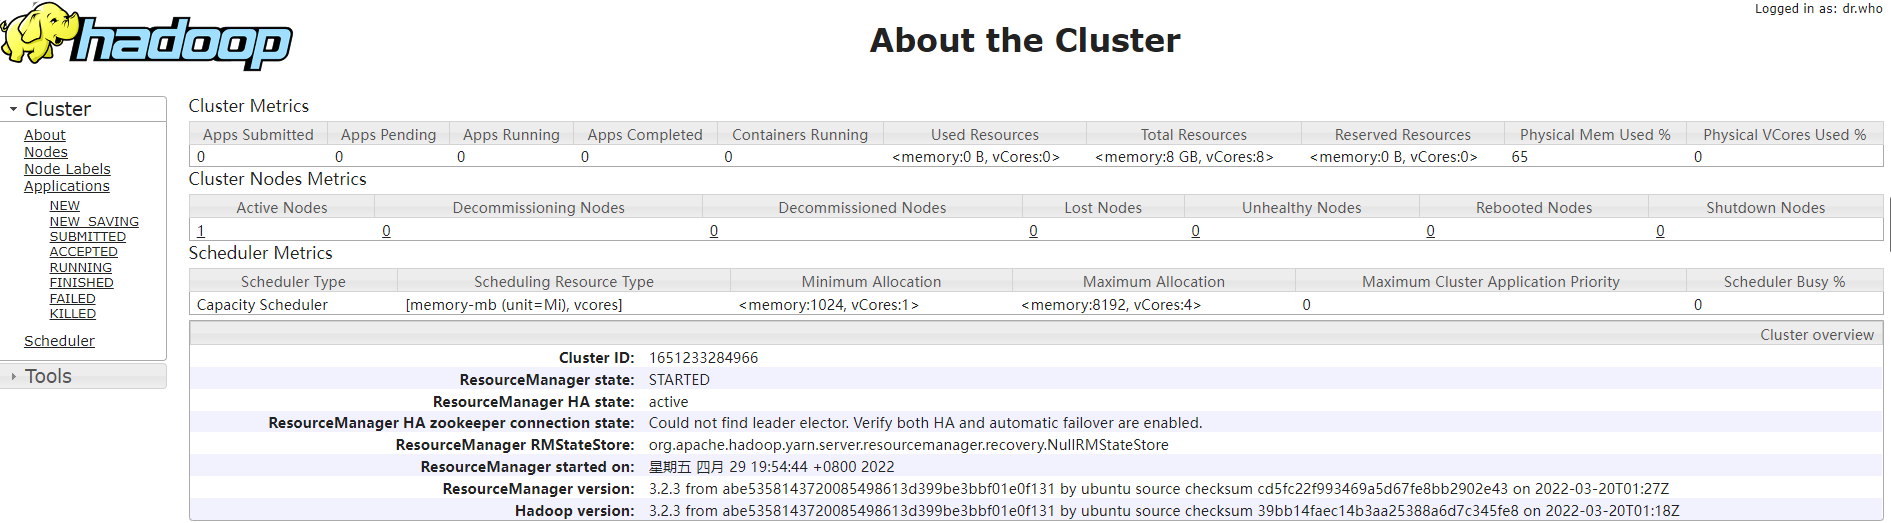
访问集群ui
http://192.168.43.50:8088/cluster/cluster
Hadoop(一)Hadoop核心架构与安装的更多相关文章
- 大数据Hadoop核心架构HDFS+MapReduce+Hbase+Hive内部机理详解
微信公众号[程序员江湖] 作者黄小斜,斜杠青年,某985硕士,阿里 Java 研发工程师,于 2018 年秋招拿到 BAT 头条.网易.滴滴等 8 个大厂 offer,目前致力于分享这几年的学习经验. ...
- Hadoop核心架构HDFS+MapReduce+Hbase+Hive内部机理详解
转自:http://blog.csdn.net/iamdll/article/details/20998035 分类: 分布式 2014-03-11 10:31 156人阅读 评论(0) 收藏 举报 ...
- Hadoop 核心架构
Hadoop 由许多元素构成.其最底部是 Hadoop Distributed File System(HDFS),它存储 Hadoop 集群中所有存储节点上的文件.HDFS(对于本文)的上一层是Ma ...
- Hadoop核心架构(1)
在大数据的发展过程中,出现了一批专门应用与大数据的处理分析工具,如Hadoop,Hbase,Hive,Spark等,我们先从最基础的Hadoop开始进行介绍 Hadoop是apache基金会下所开发的 ...
- Hadoop化繁为简(一)-从安装Linux到搭建集群环境
简介与环境准备 hadoop的核心是分布式文件系统HDFS以及批处理计算MapReduce.近年,随着大数据.云计算.物联网的兴起,也极大的吸引了我的兴趣,看了网上很多文章,感觉还是云里雾里,很多不必 ...
- 五十九.大数据、Hadoop 、 Hadoop安装与配置 、 HDFS
1.安装Hadoop 单机模式安装Hadoop 安装JAVA环境 设置环境变量,启动运行 1.1 环境准备 1)配置主机名为nn01,ip为192.168.1.21,配置yum源(系统源) 备 ...
- 大数据系列(2)——Hadoop集群坏境CentOS安装
前言 前面我们主要分析了搭建Hadoop集群所需要准备的内容和一些提前规划好的项,本篇我们主要来分析如何安装CentOS操作系统,以及一些基础的设置,闲言少叙,我们进入本篇的正题. 技术准备 VMwa ...
- 大数据——Hadoop集群坏境CentOS安装
前言 前面我们主要分析了搭建Hadoop集群所需要准备的内容和一些提前规划好的项,本篇我们主要来分析如何安装CentOS操作系统,以及一些基础的设置,闲言少叙,我们进入本篇的正题. 技术准备 VMwa ...
- Hadoop分布式文件系统:架构和设计要点
原文:http://hadoop.apache.org/core/docs/current/hdfs_design.html 一.前提和设计目标 1.硬件错误是常态,而非异常情况, HDFS可能是有成 ...
随机推荐
- 数据库连接Database link?
在一个用户下,可以获取到另外的用户下的表的数据,通常在跨数据库时使用. create database link link93 connect to scott identified by tiger ...
- python 模块和包的基础知识
1.常见的场景:一个模块就是一个包含了python定义和声明的文件,文件名就是模块名字加上.py的后缀 2.为了方便管理,我们通常将程序分成一个个的文件,这样做程序的结构更清晰,方便管理.这时我们不仅 ...
- ThreadPoolTaskExecutor原理、详解及案例
为什么要用线程池? 服务器应用程序中经常出现的情况是:单个任务处理的时间很短而请求的数目却是巨大的. 构建服务器应用程序的一个过于简单的模型应该是:每当一个请求到达就创建一个新线程,然后在新线程中为请 ...
- 关于Oracle数据库的PIVOT分组函数的使用
官方文档挺详细的,在新功能那里有介绍到:http://www.oracle-developer.net/display.php?id=506 PIVOT的语法:https://docs.oracle. ...
- prometheus-存储
采集到的样本以时间序列的方式保存在内存(TSDB 时序数据库)中,并定时保存到硬盘中 prometheus一般会保留15天 prometheus按照block块的方式来存储数据,每2小时为一个时间单位 ...
- npm安装包出现UNMET DEPENDENCY报错
出现这个内容应该是包损坏,导致npm无法正常解析,通过 npm ls 命令也可以看到UNMET DEPENDENCY在依赖包上出现,在输出的信息最后有一个错误信息 npm view pkg versi ...
- 学习Kvm(六)
五,管理虚拟存储 5.1 虚拟磁盘概述 5.1.1 虚拟化项目中存储的注意事项 [x] 存储的性能几乎总是虚拟化的瓶颈 [x] 通过多个硬盘驱动以分布磁盘I/O来实现存储解决方案 [x] 考虑部署集中 ...
- ArrayList跟LinkedList的区别
ArrayList和LinkedList都是实现list接口,它们不同如下: ArrayList是基于索引的数据接口,底层是数组.它可以以O(1)时间复杂度对元素进行随机访问.与此相对,linkedL ...
- 当心,你搞的Scrum可能是小瀑布
摘要:有的团队刚接触Scrum,一个问题令他们很困扰:迭代初期开发人员的工作较多,测试人员闲着:迭代末期开发人员闲着,测试人员的工作比较多,怎么解决资源等待的问题呢? 本文分享自华为云社区<当心 ...
- 六个框架,一百多条检查项目,保证PCB设计不再出错
一.资料输入阶段1.在流程上接收到的资料是否齐全(包括:原理图.*.brd文件.料单.PCB设计说明以及PCB设计或更改要求.标准化要求说明.工艺设计说明文件)2.确认PCB模板是最新的3. 确认模板 ...